














11
18
5台Mac mini4集群跑大模型!性能逆天,才200W
2024-12-01 12:54:59
102点赞
381收藏
136评论
在机器学习模型的运行中,任务的并行处理能力至关重要。传统的中央处理器(CPU)在处理并行任务方面效率较低,因此在CPU上运行模型速度较慢。相比之下,图形处理器(GPU)擅长并行处理,因此被广泛用于加速机器学习任务。
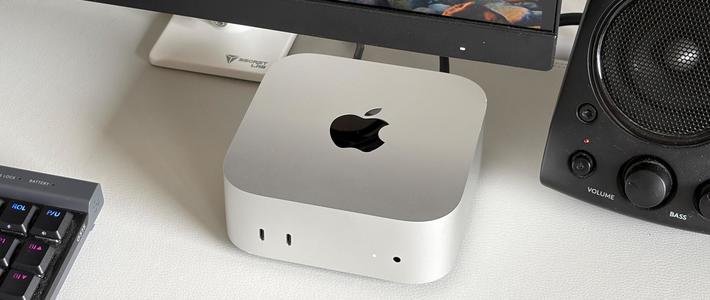
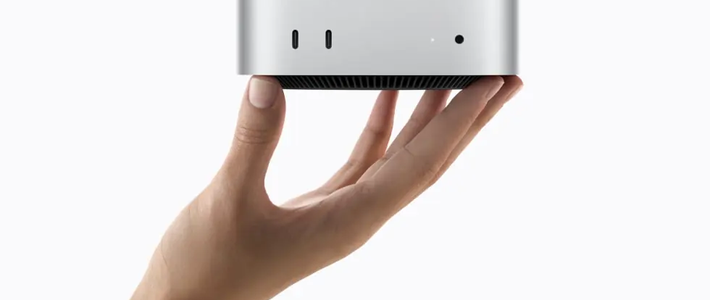
然而,专用的高性能GPU,如NVIDIA的RTX 4090,虽然性能强大,但价格昂贵且功耗高。这促使消费者寻找更具成本效益的替代方案。苹果的Apple Silicon架构,如M3系列芯片,提供了强大的性能和能效,成为在家中运行本地大型语言模型(LLM)的可行选择。
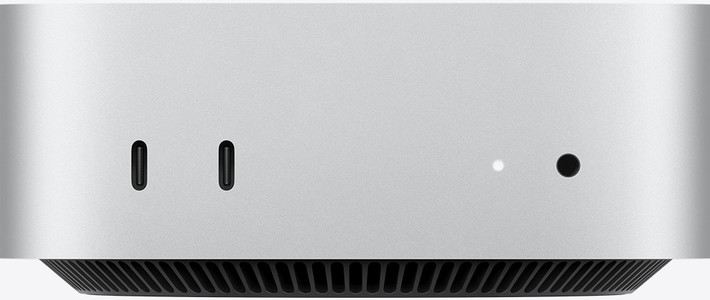
值得注意的是,Apple Silicon的统一内存架构(Unified Memory)允许CPU和GPU共享内存资源。例如,配备64GB统一内存的Mac Mini,提供的内存容量远超许多高端GPU,如RTX 4090的24GB显存。这使得Apple Silicon设备能够处理更大的模型,而无需昂贵的专业硬件。
为了进一步优化Apple Silicon设备上的机器学习性能,苹果推出了MLX框架。该框架专为Apple Silicon设计,利用其统一内存架构和硬件特性,提供类似于NVIDIA CUDA的功能。在某些基准测试中,MLX在Apple Silicon设备上的表现优于其他框架,如PyTorch。
此外,项目EXO允许用户将多台设备(如iPhone、iPad、Android、Mac等)整合成一个强大的AI集群。通过动态模型分区和自动设备发现,EXO能够在家用设备上运行大型AI模型,降低对昂贵GPU的依赖。

单机性能测试
1. 基础版M4 Mac Mini:
• 小模型(1B参数,Llama 3.21B):约 73 tokens/秒,表现不错。
• 中型模型(Quen 2.5 Coder 7B):约 21 tokens/秒。
• 大型模型(32B):约 8 tokens/秒,速度明显下降。
2. M4 Pro Mac Mini:
• 小模型(1B参数,Llama 3.21B):约 100 tokens/秒,优于基础版M4。
• 中型模型(Quen 2.5 Coder 7B):约 16 tokens/秒。
• 大型模型(32B):约 12 tokens/秒。
分布式集群性能测试
1. 两台基础版M4 Mac Mini(通过Thunderbolt连接):
• 小模型(1B参数,Llama 3.21B):
• 未优化连接:约 45 tokens/秒(比单机更差,受通信开销影响)。
• 优化连接:约 95 tokens/秒,速度明显提升。
2. 五台设备的集群(两台M4 Pro + 三台M4):
• 小模型(1B参数,Llama 3.21B):约 74 tokens/秒,与单机相近,集群未显著提升性能。
• 中型模型(Quen 2.5 Coder 7B):约 12-16 tokens/秒。
• 大型模型(32B):约 16 tokens/秒,运行变慢但能支持更大模型。
功耗
1. 单台设备功耗:
• 基础版M4:约 50W。
• M4 Pro:约 87W。
2. 五台设备集群功耗:
• 总功耗约 200W,比高端GPU方案(如RTX 4090)低得多。
总结的成绩与结论
1. 小模型:单台M4 Pro性能优于两台基础版M4。
2. 大模型支持:分布式集群可以运行更大模型(如32B和70B),但通信开销导致速度未显著提高。
3. 功耗与成本优势:
• 与RTX 4090相比,Apple Silicon设备具有更低的功耗和初始成本。
• 在家运行小模型,Apple Silicon设备是高性价比选择。
最终结论是,单台高性能设备(如M4 Pro或更高配置的MacBook Pro)可能更适合普通用户,而分布式集群技术虽然有潜力,但在当前阶段实际效益有限。










校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
低情商:挖矿
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案