







 深耕数码、居家兴趣领域





7
5
AI大模型也吃内存?绫龙DDR5 48GB套条评测
2026-09-10 14:57:24
19点赞
4收藏
24评论
这两年AI的火爆程度,不用多说大家都能感受到。自从GPT3爆火出圈,OpenClaw“龙虾”将语言模型转化成了实际生产力之后,AI就彻底摆脱了“互联网噱头”的标签,发布会上画饼的PPT技术,也真成了普通人随手就能用的实用工具。
现在不管是大厂还是普通玩家,都在跟风玩AI。日常写文案、改代码、做短剧、聊智能问答,AI几乎承包了我们大半的办公和娱乐场景,渗透在生活的方方面面。
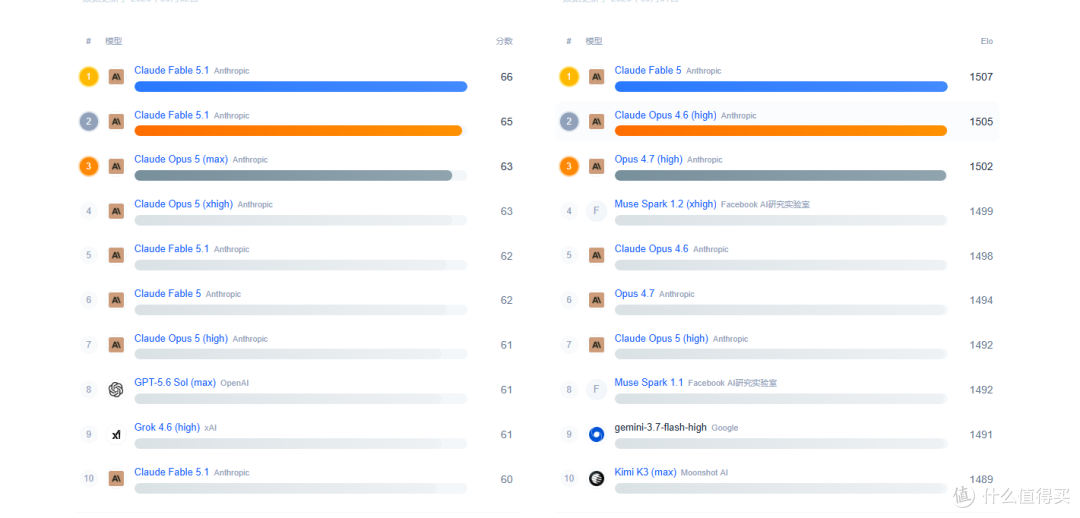
大部分人都是直接用云端AI,只是简单的小对话,点开就能用、不用折腾。再技术力一点的就是调用官方提供的API。但有两类群体更倾向于本地大模型:一是爱好折腾的个人极客,二是对数据有保密性要求的中小团队。
对于个人玩家,要么嫌弃云端API付费太贵,要么担心上传文件泄露隐私,索性选择自己在电脑本地部署大模型,主打一个免费、自由度拉满。而像律师所,产品研发这类中小企业场景,则需要极度保密,隐私的安全是不可妥协的硬性底线。但受限于超大规模的模型训练需要顶级的算力集群和海量的存储资源,无论是个人还是小微企业根本无法企及,本地部署的AI大多表现远逊于网络模型。
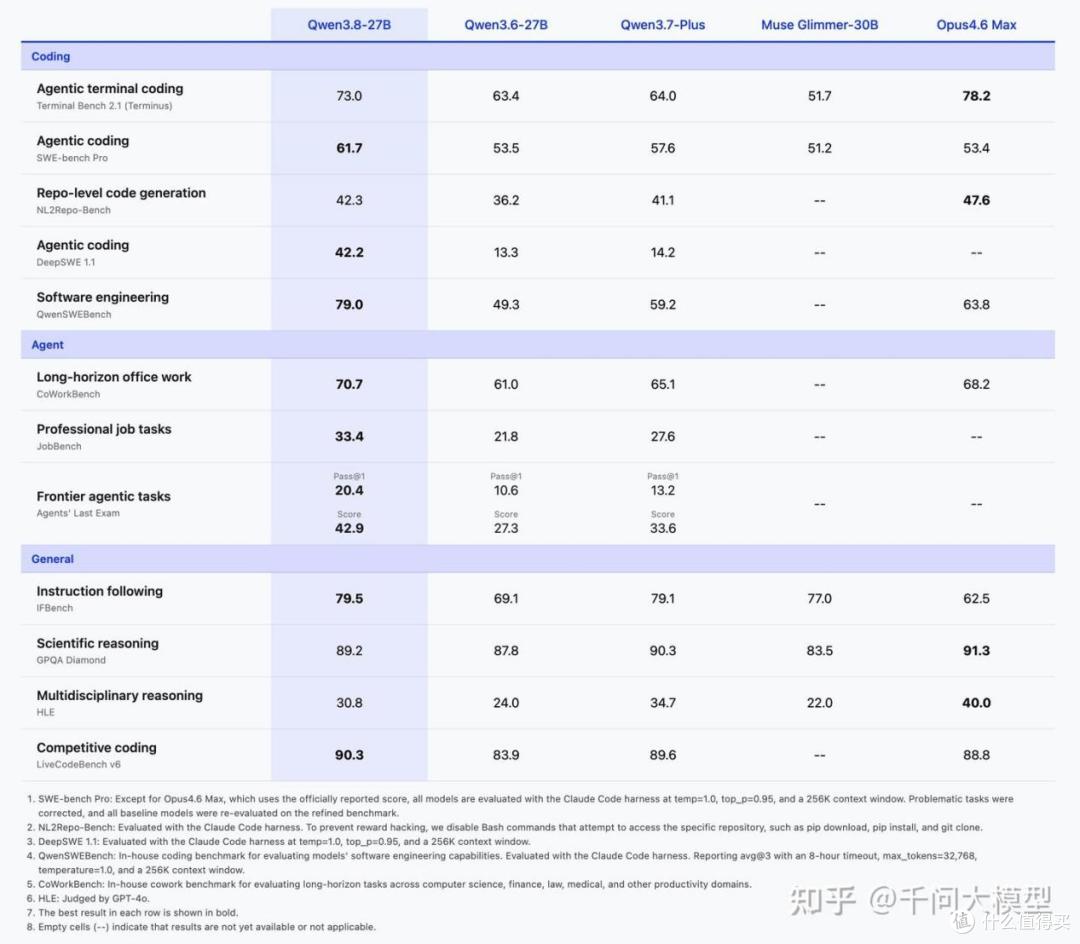
不过,本地部署的高性能AI模型的门槛这两年也一直在降。上个月,Qwen(通义千问)3.8更新,其中蒸馏优化后的Qwen3.8-27B让人惊艳:LiveCodeBenchv6编程测试拿到90.3分,在一众网络模型中都能稳居第一梯队。在代表AI智能体能力,SWE-benchPro和OSWorld-Verified的测试中甚至超过了ClaudeOpus4.6。
更关键的是它的门槛相当低:Q3_K_M精度下,16GB显存的显卡就能流畅部署,拿9070XT来说,推理速度约10token/s,日常对话、写文案、改代码都够用。
不过本地部署可不能光看显卡和显存大小。用常见的vLLM、llama.cpp程序本地部署时,哪怕模型所有的权重都塞进显存,系统依旧会在系统内存中预留一部分作为内存池,用来存放上下文缓存。在多轮对话,长文档解析和批量生成内容等需要场景,还都需要占用大量的系统内存。
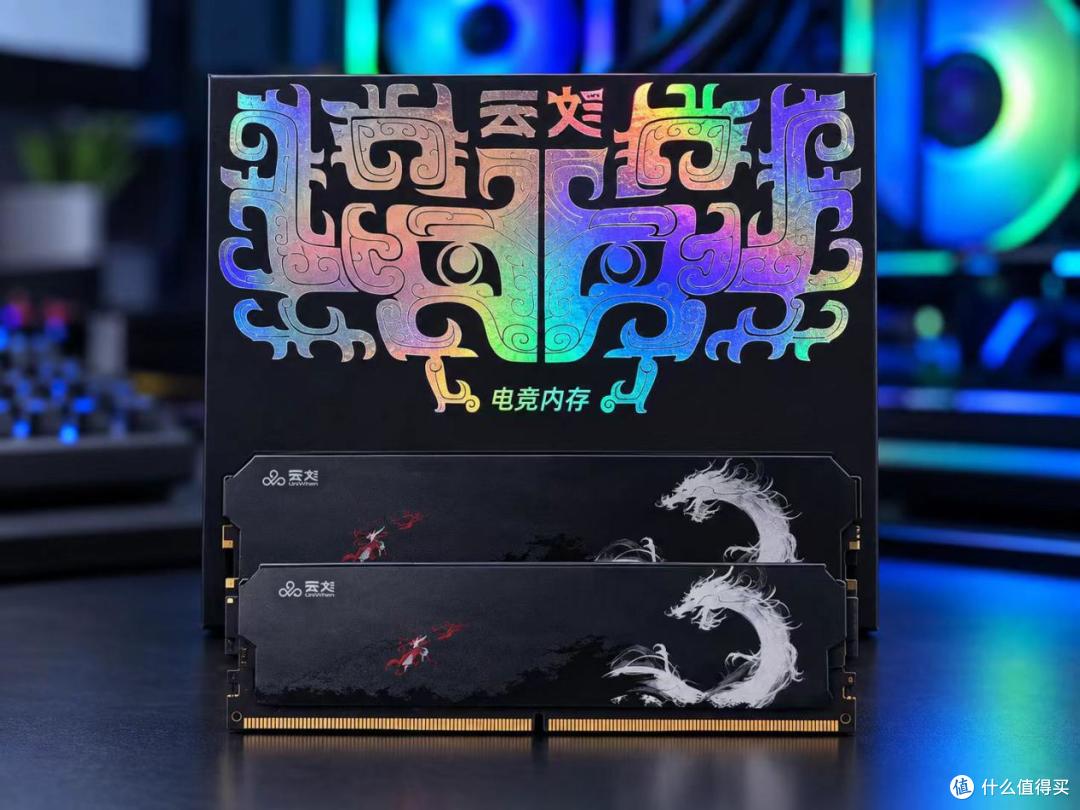
所以一块好的显卡只是部署大模型的起点,而若想真正稳定、满血地跑模型,还是需要一套高品质、大容量的内存
开箱
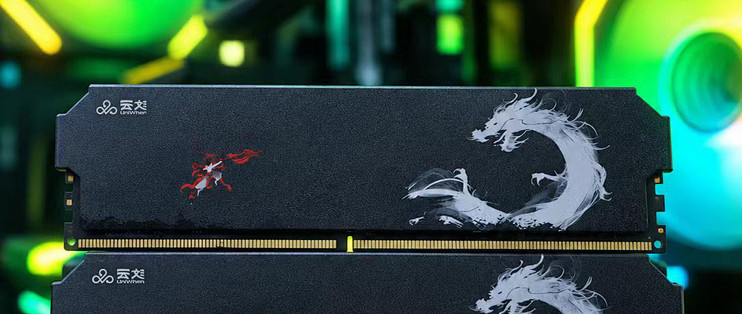
本次,我们就用来自云彣(UniWhen®)的绫龙DDR5 6000 C36 48GB(24GB*2)套条,对比一下目前主流的32GB内存,来对比测试一下大模型的实际表现。
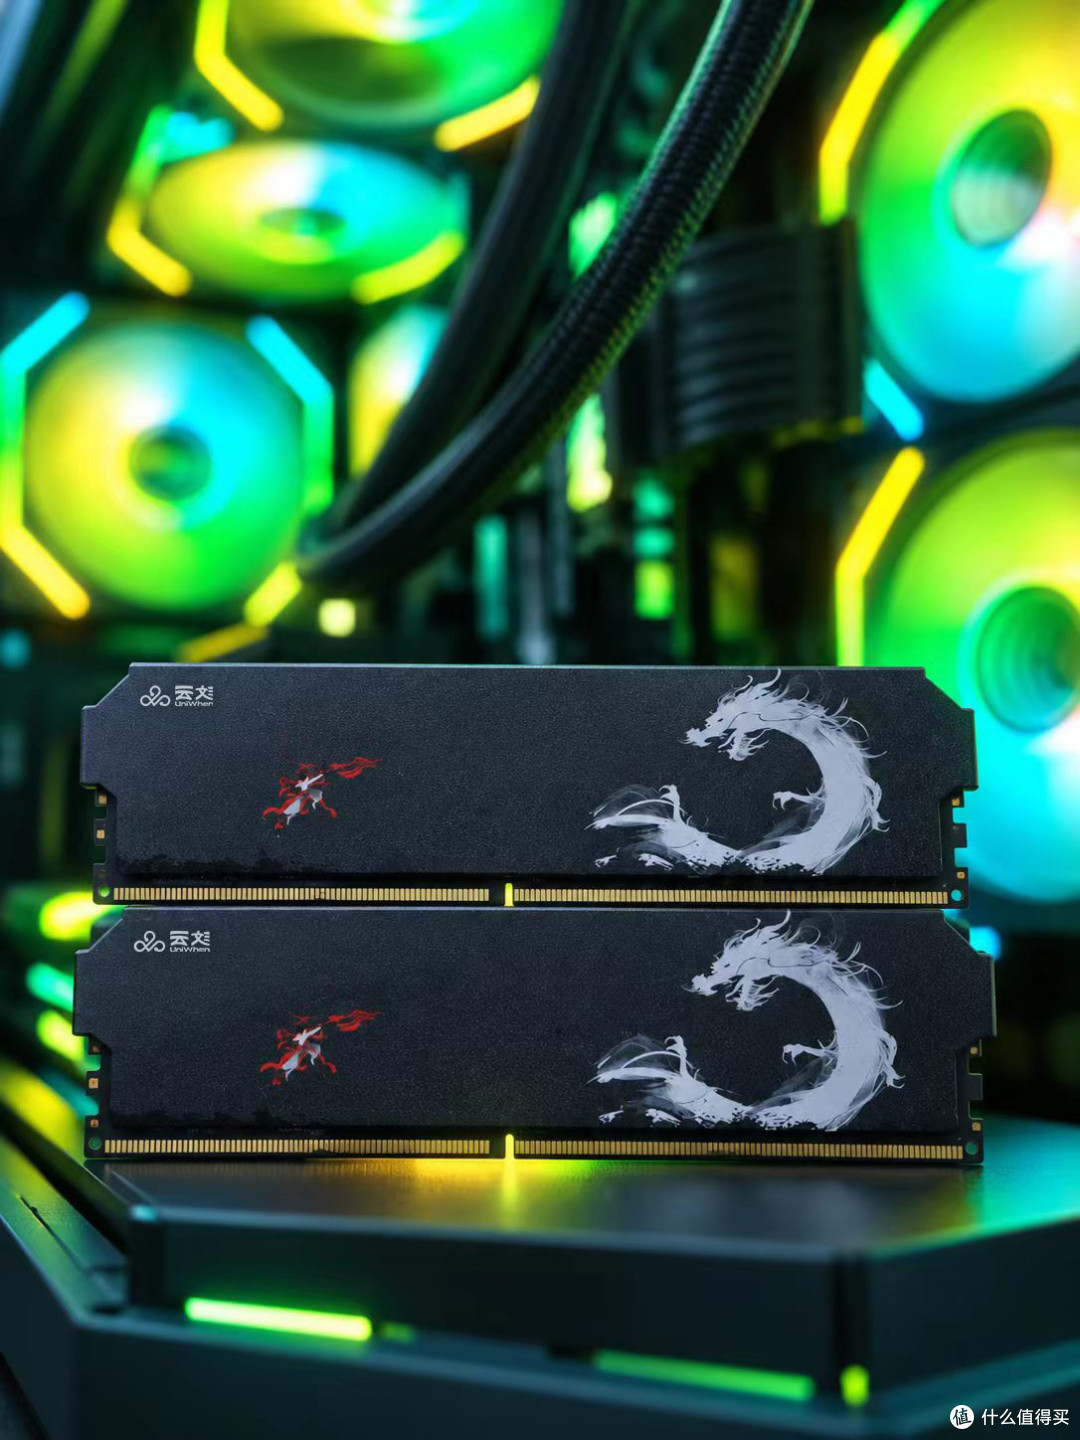
先来看看本次测试的主角,绫龙DDR5内存依旧采用标志性的水墨风国韵设计,以家喻户晓的《哪吒闹海》作为核心主题,将英勇无畏的精神内核融入了产品设计之中,墨焰黑的配色也给整机增添了不凡的质感,我个人非常喜欢。
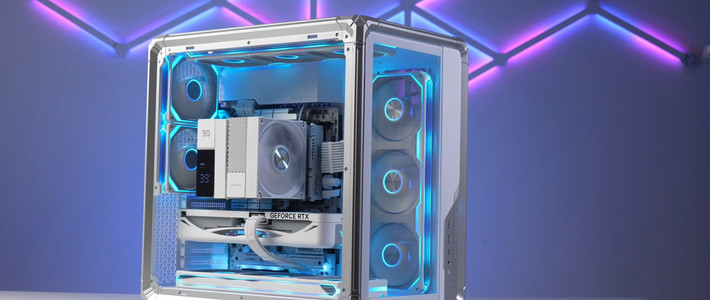
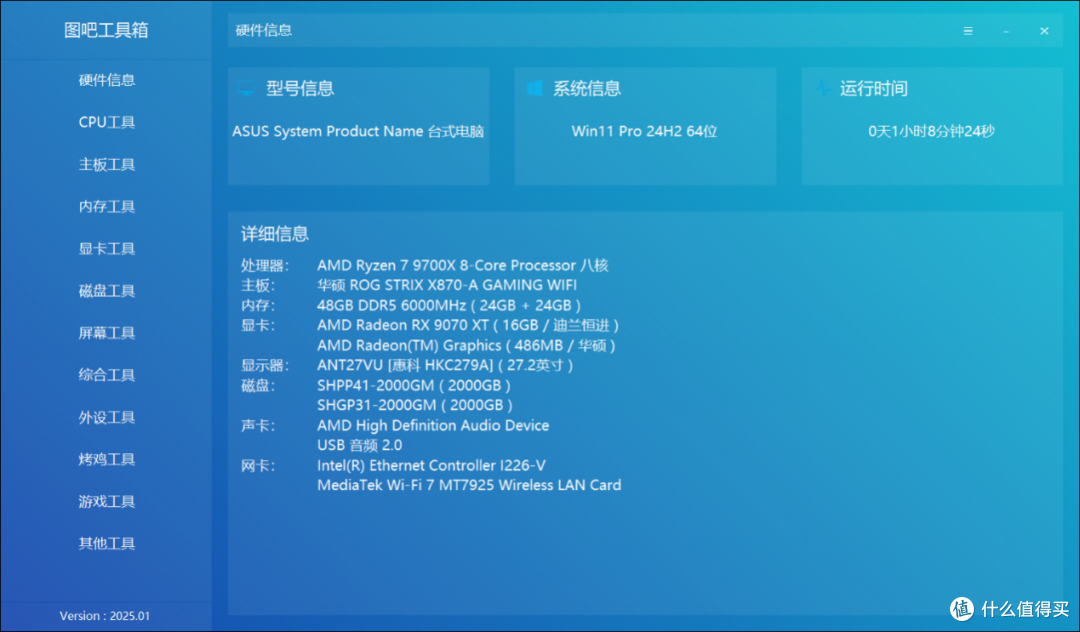
装机的配置如图,这次的性能展示就简单点,重点来看AI能力。
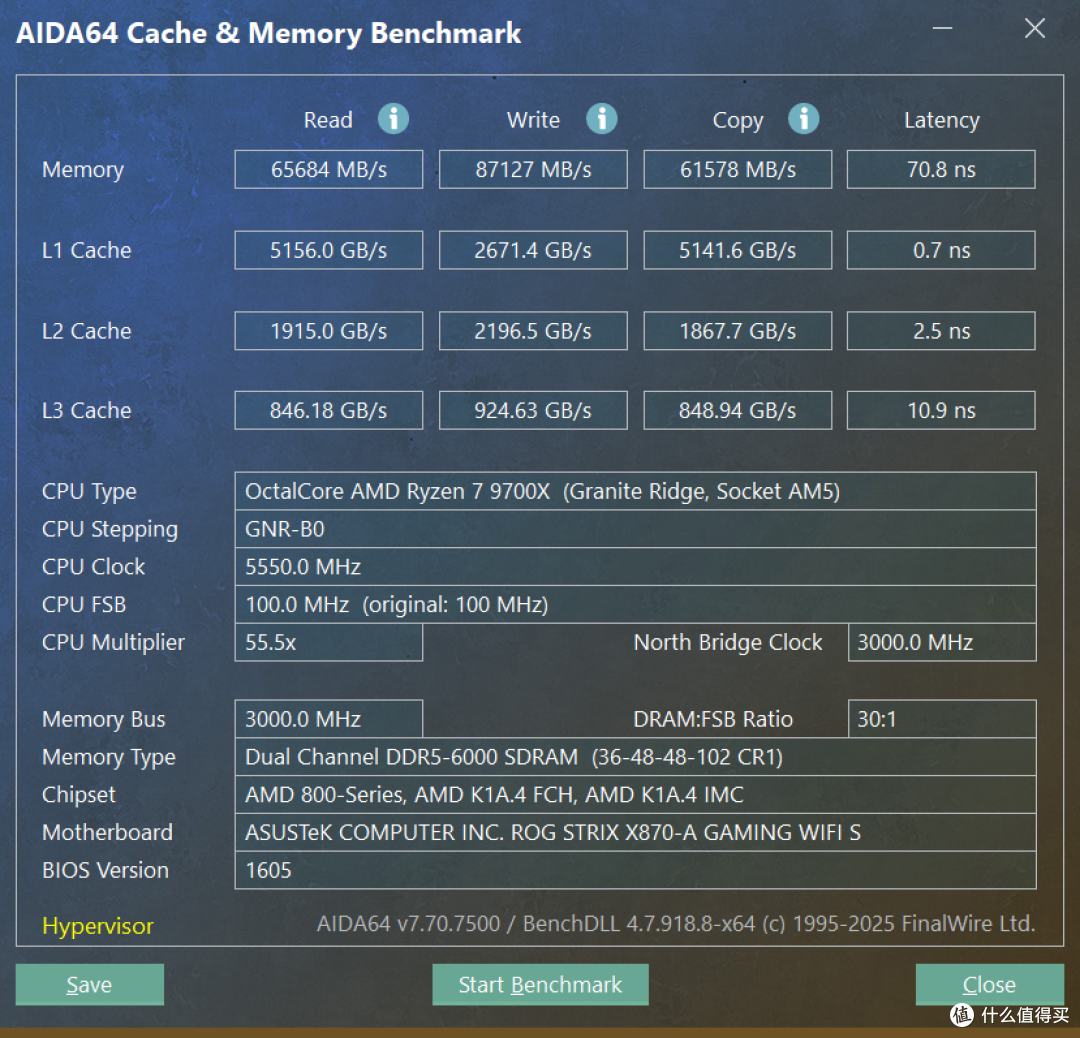
用AIDA64测试一下内存的读写性能:除了内存容量,读写性能也是AI能力的重要一环,更快的读写性能也能提供更快的交换速度,也能侧面影响大模型的生成速度。
接下来,我们来重点看下AI能力,我们把它和一套常见的32GB双通道配置放在同一平台、同一模型下对比,重点看长文本对话、长文档解析和复杂代码任务。
32GB双通道内存:尝鲜入门
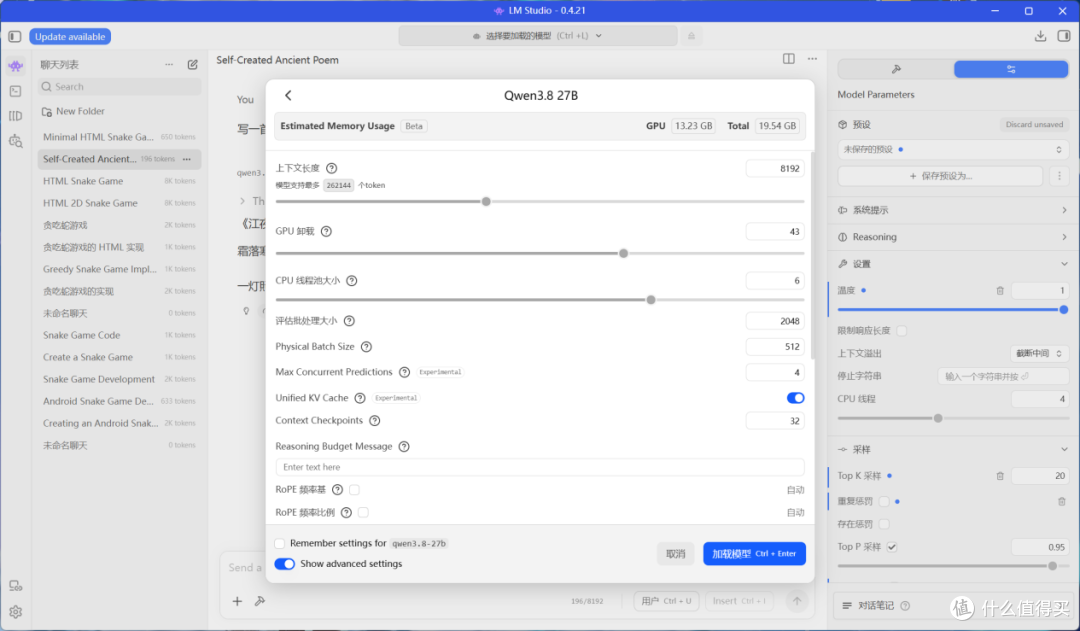
先来看一下目前主流的32GB内存,这套日常十分充裕的规模能够应对基础的本地AI任务,但在高负载场景下余量会比较紧张。
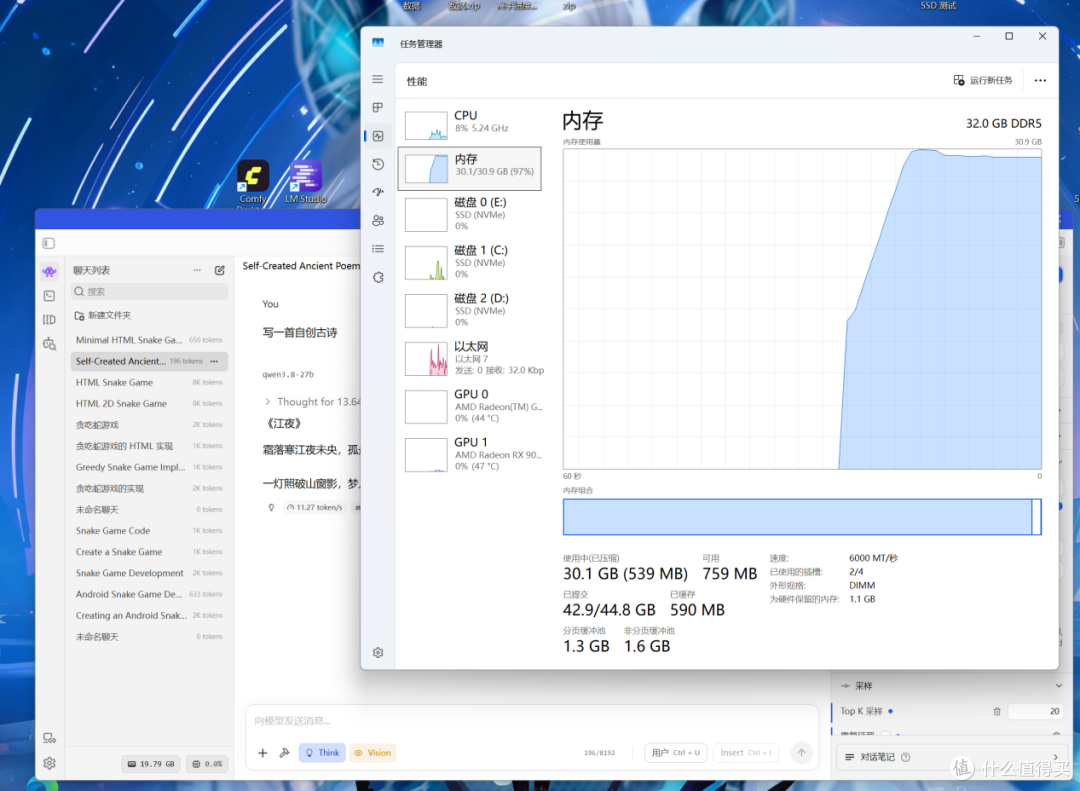
当上下文长度设置为8K大小时,系统内存压力会明显上升。大模型完成加载之后,物理内存占用快速走高,剩余可用空间不足1GB,同时已提交的内存已冲至44.8GB,此时系统会大量调用虚拟内存,继续使用或者运行复杂任务就会遇到瓶颈。
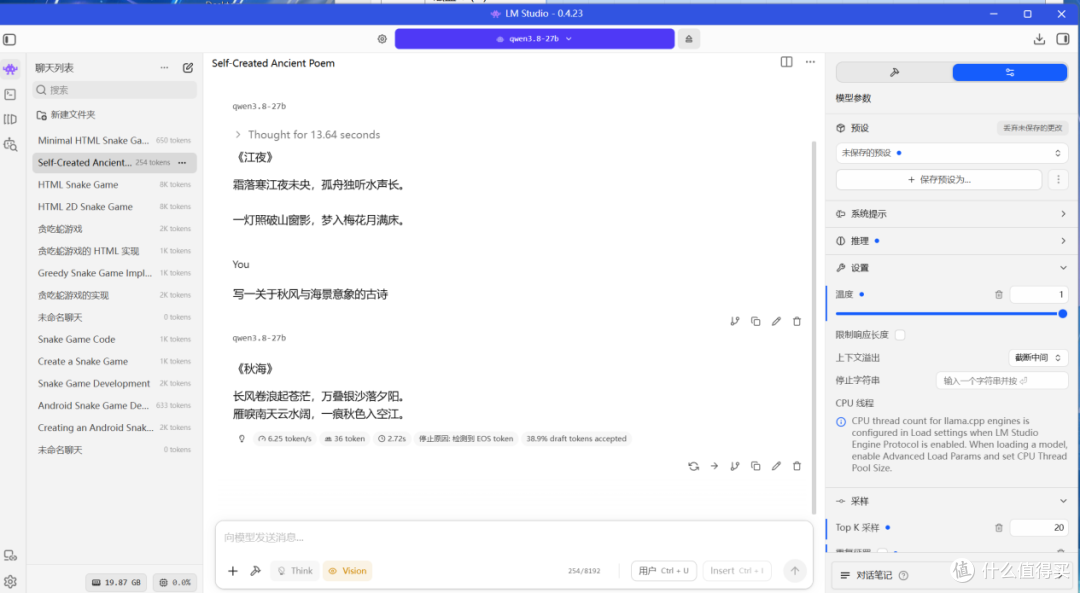
当然,8K大小下基础对话、简单聊几句还是很足够的。但是如果还有什么后台应用常驻,或者要求智能体做一些连续、复杂的任务,内存就顶不住了。
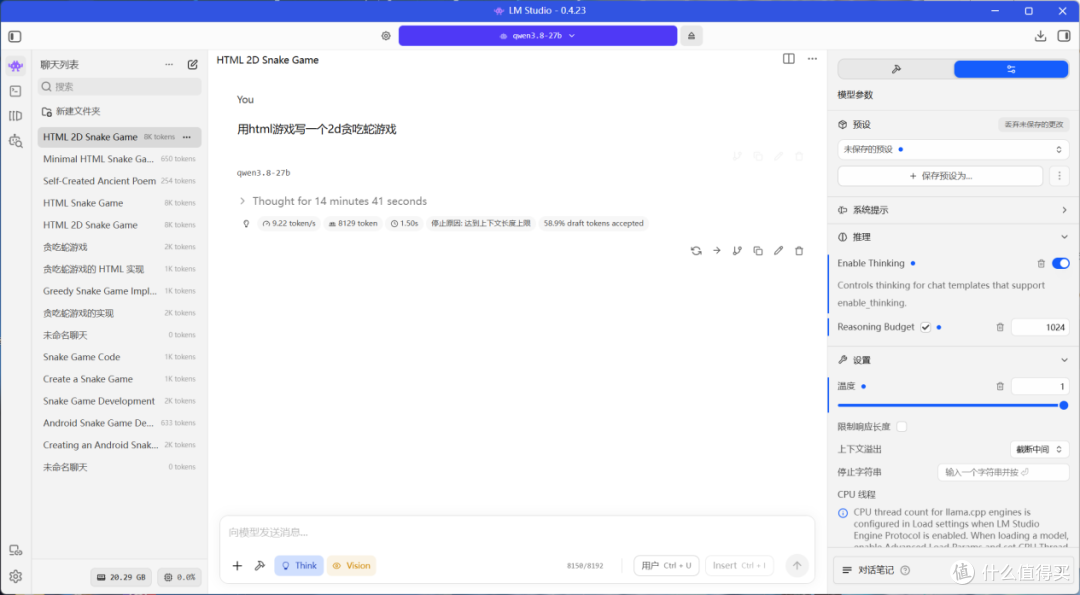
8K的上下文最受影响的就是AI的思考模式了,仅仅是安排一个贪吃蛇的编写任务,还在思考阶段都到了上下文上限,很难支撑重度的AI玩法。
48GB大容量双通道内存:满血体验
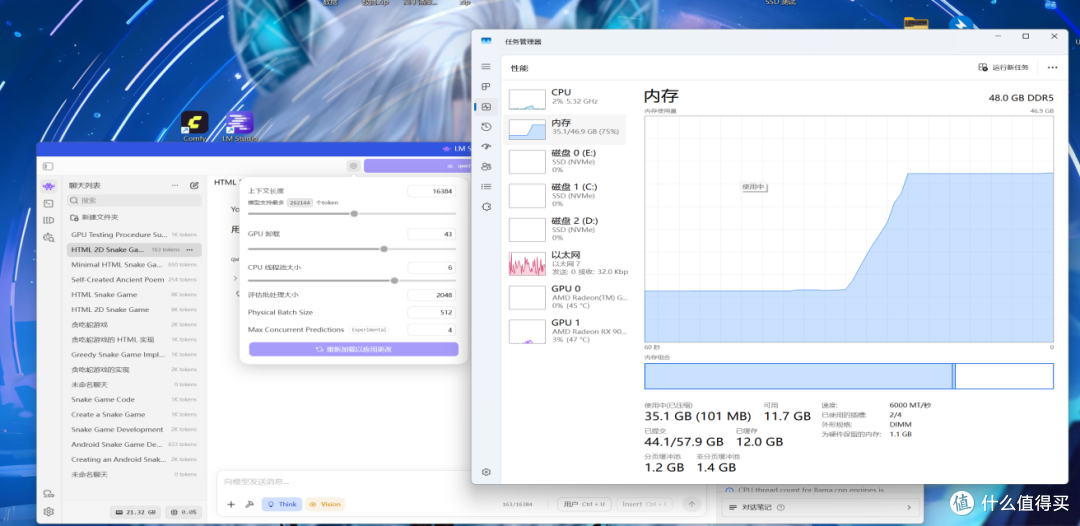
升级到绫龙的48GB大容量内存后,最直观的就是上下文可以直接翻倍,16K的超长上下文可以随意开启。内存占用仅达到35GB左右,整体还有相当的空闲余量。
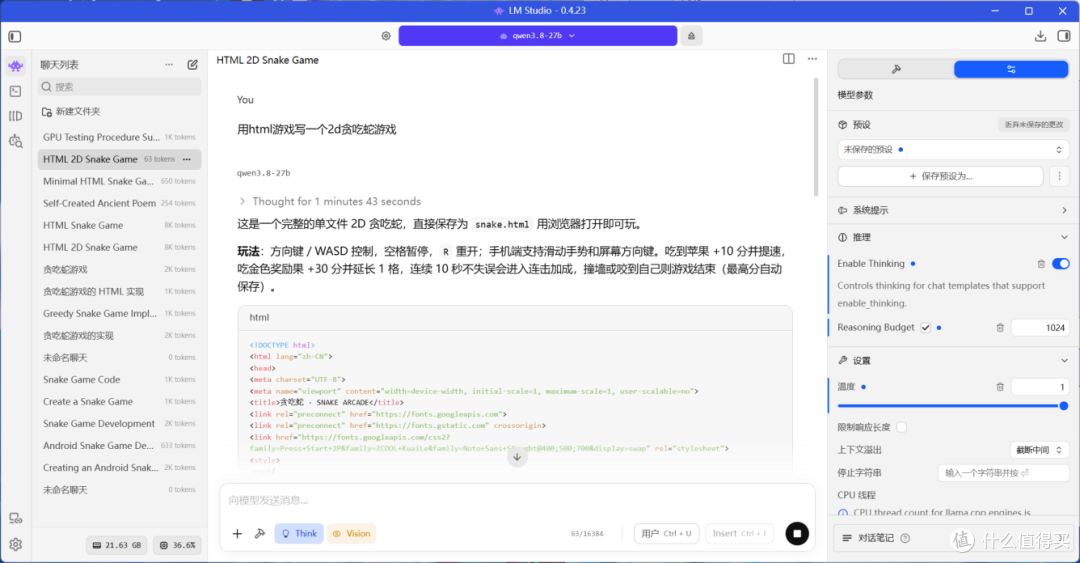
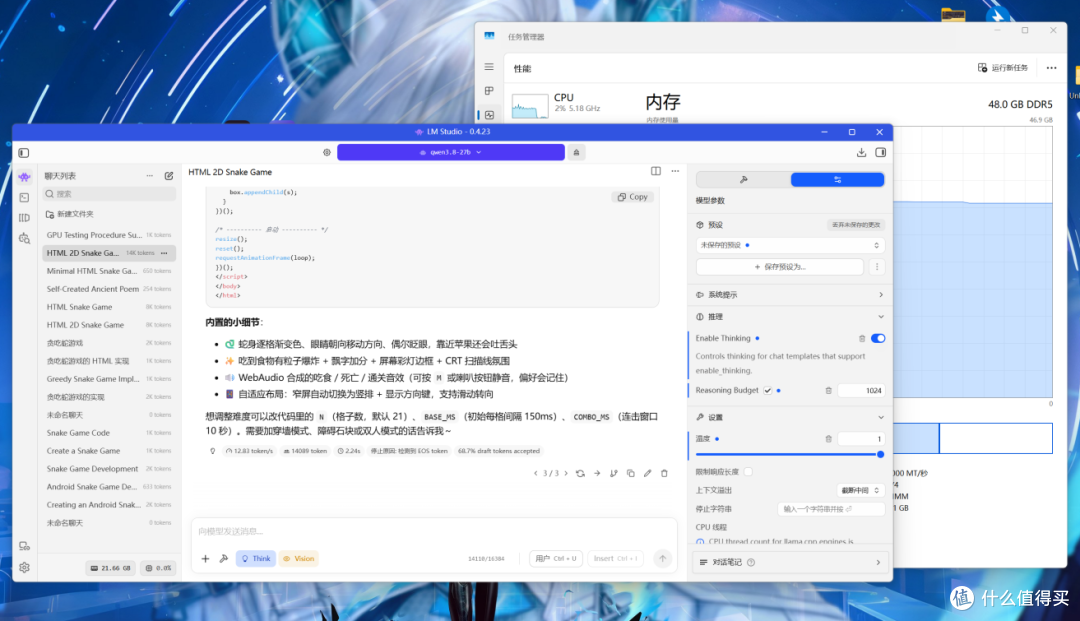
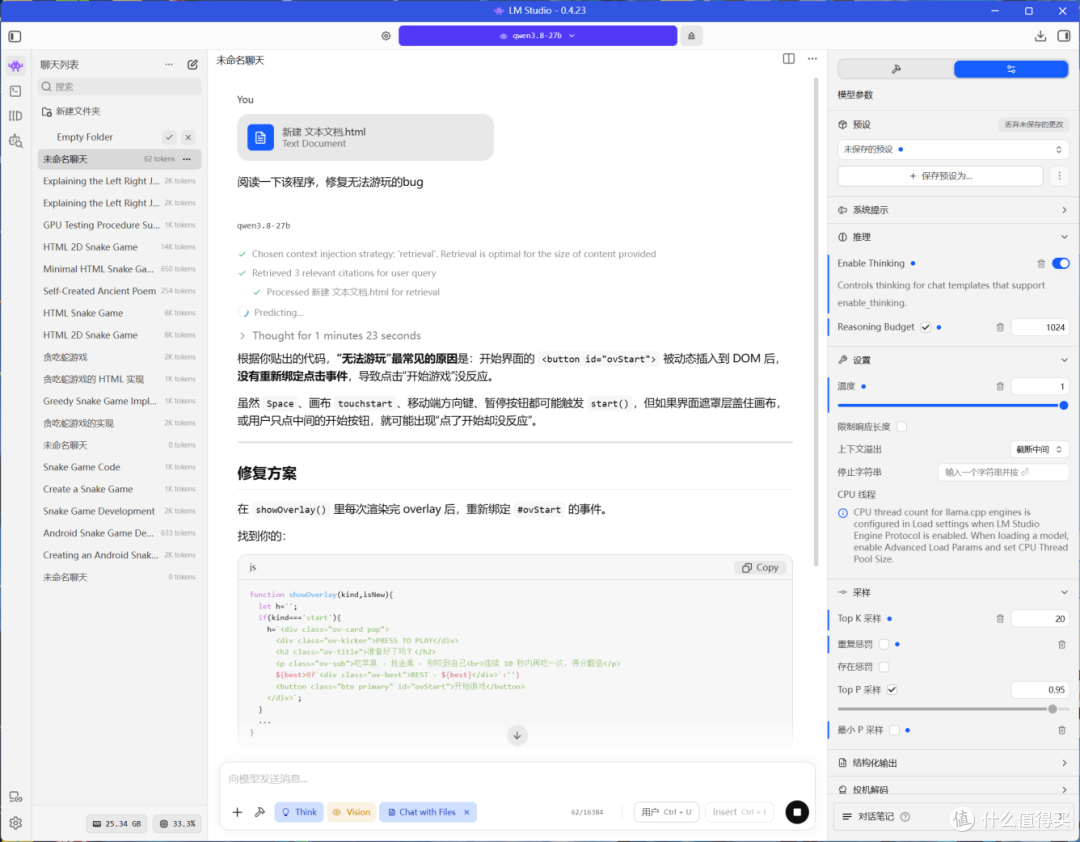
更换为16K大小后,同样是写贪吃蛇,48GB内存能在一个会话里完成分析,思考和制作,还能继续追问、改BUG,能够在一个会话里连贯地完成工作,相比时断时续的描述,修改,体验要好得多。
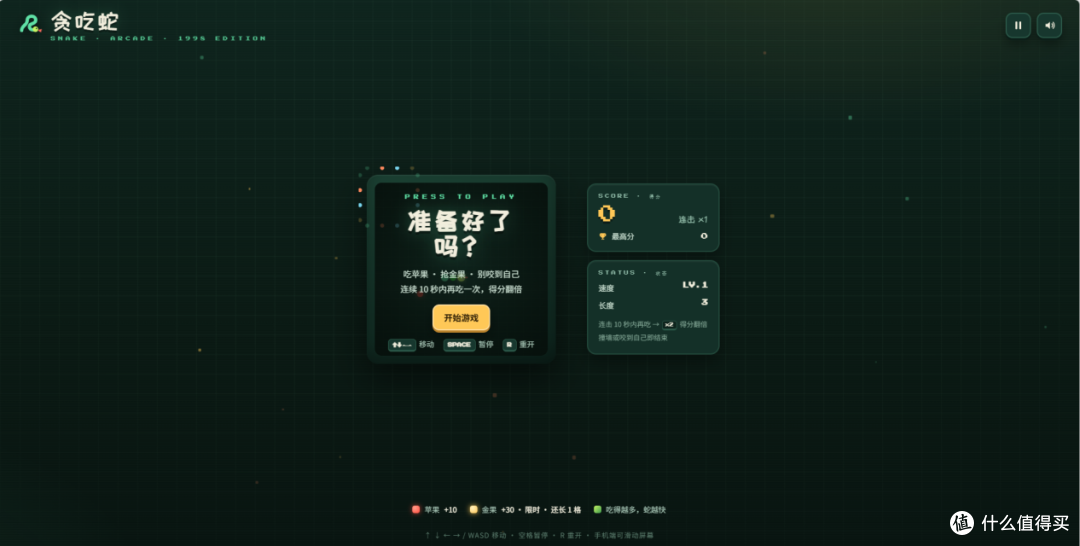
(由Qwen3.8-27B制作的贪吃蛇网页游戏)
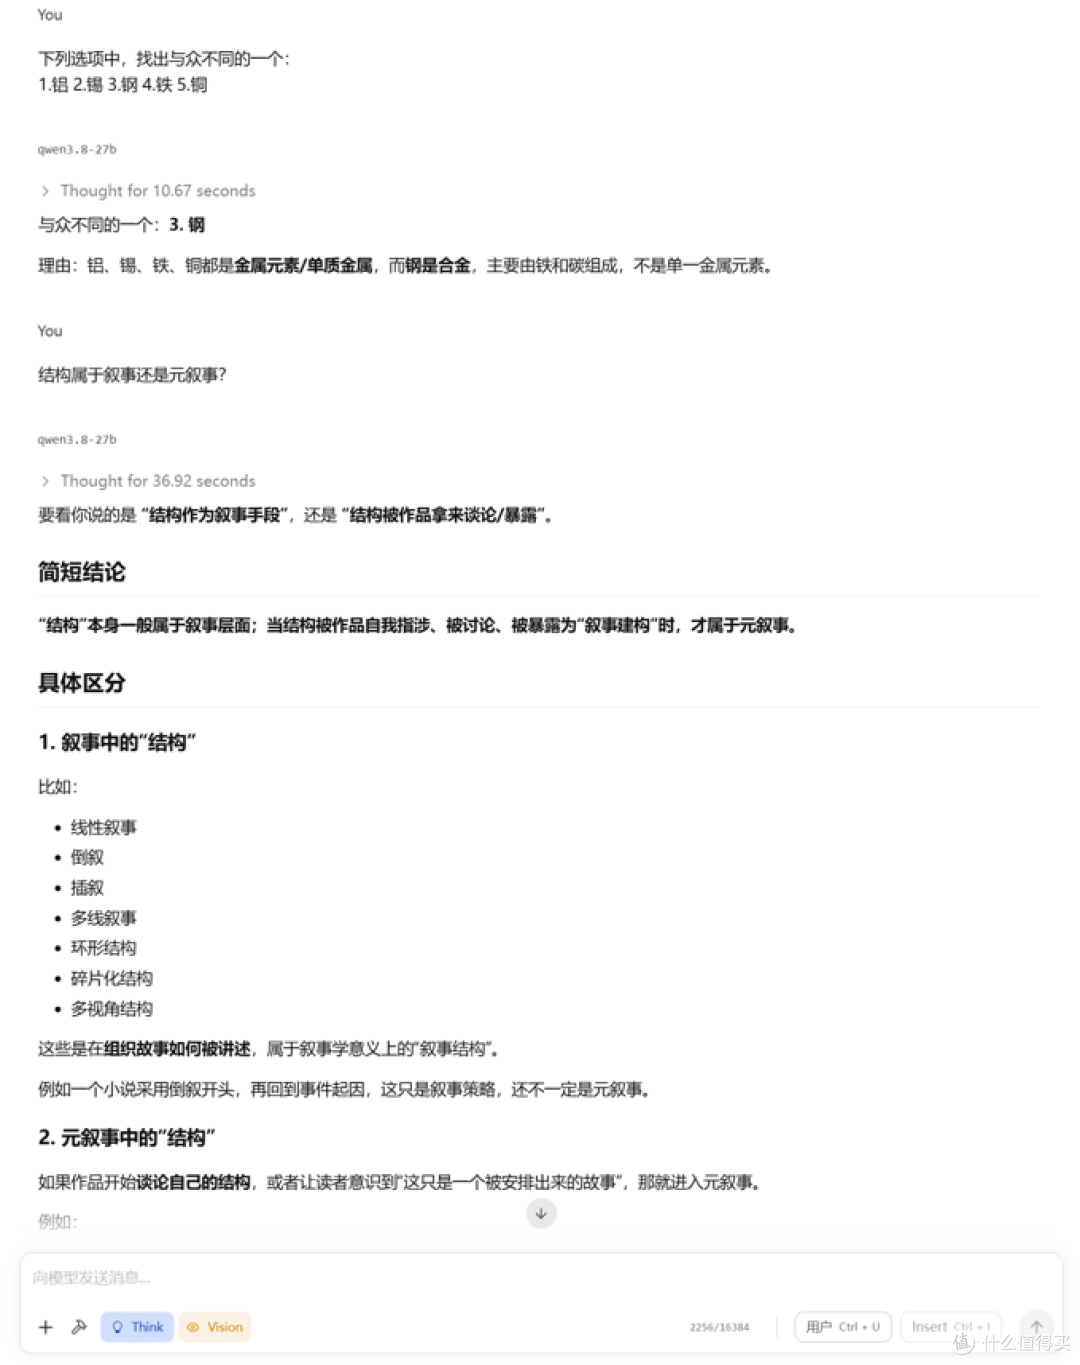
在更基础的场景中,无论是十几轮对话,还是长篇文档的一次性解析,都十分流畅,全程无闪退、卡顿、掉速出现。
总结
回到文章开头,现阶段消费级显卡显存上限也不过停留在24GB。想要本地完整跑通超大参数模型,选购专业计算卡固然可行,但动辄高昂的成本,对于普通消费者来说并不现实。
对本地 AI 部署而言,显卡是必不可少的入场券,但内存也同样是不可忽视的关键硬件。32GB 内存可以胜任轻度闲聊、简单尝鲜这类入门使用场景;如果需要开展重度生产类工作,它的硬件余量会相对有限。但如果你想常驻模型、用AI处理长文档、写代码、做复杂创作,48GB大容量内存的优势就彻底体现出来了。更大的上下文上限、更稳定的多任务运行,让本地AI从“勉强能用”,蜕变成真正高效好用的生产力工具。
云彣(UniWhen)绫龙DDR5 6000 C36 48GB套条在这个定位下表现优秀,稳定舒适,完美适配用户本地满血跑大模型的需求。想要升级本地AI体验,告别卡顿和上下文不足,这套内存是不可忽视的优选之一。










校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案