


















19
20
开源字幕工具,翻译、配音、合成一次完成
2026-10-19 15:21:26
0点赞
1收藏
0评论
给视频配字幕,过去得在几个工具之间来回倒。把片子弄下来用一个,转文字用一个,翻译一个,配音一个,最后字幕还得一个。
妙幕(SmartSub)把这些装进同一个桌面应用,MIT 协议,Windows、macOS、Linux 都有安装包,GitHub 上五千五百多星。

启动台。左边是几个预设流程,右边是环境就绪度、快捷入口和 AI 助手
01 / MODELS & API
本地模型和接口方式
先说它用什么模型跑。本地模型装上就能用,不用自己去配运行环境,模型下载也有国内镜像的替代办法。
本地
本地那套打包在软件里,装上就能用
whisper.cpp FunASR Qwen3-ASR FireRedASR NVIDIA Parakeet Kokoro VITS ZipVoic esherpa-onnx ffmpeg
转写有五个识别引擎,按语种和场合分工。whisper.cpp 是 OpenAI Whisper 的 C++ 移植版,什么语言都能认,当通用项用;FunASR 来自阿里达摩院,主打中文;Qwen3-ASR 也是阿里的,覆盖的语种和方言最多;FireRedASR 是小红书开源的,开源方案里中文精度排前面,短视频字幕这类素材更合适;NVIDIA Parakeet 面向英文,胜在快。whisper.cpp 直接内置,另外四个靠内置的 sherpa-onnx 加载,那是个跨平台的语音模型运行时,装上就能切。
配音,把文字念成声音,用的也是三样。Kokoro 是个轻量语音合成模型,自带 103 个音色;VITS 走中文合成,174 个音色;ZipVoice 做零样本克隆,录一段参考音频就能用那个声音念下去。最后合成交给内置的 ffmpeg。
接口方式这头是云端 API,按量计费,不抢本地的活。
云端
按量计费,不抢本地的活
9 家在线听写20 个翻译服务6 类云端配音
翻译最能看出这套设计的开放度,内置几家免费接口能直接用,也能把 Ollama 里的本地模型拉来当引擎。
本地和云端给的功能是一样的。走本地不需要注册任何账号,不需要申请 API Key,音频文件不出本机,也没有用量限制。不想为字幕付费、也不想把素材传到别人服务器上的人,靠本地这条路就能把整条流程跑通。
02 / WORKFLOW
几大功能
配字幕要走六步,下载、转写、翻译、校对、配音、合成,它把这六步装进同一个应用。
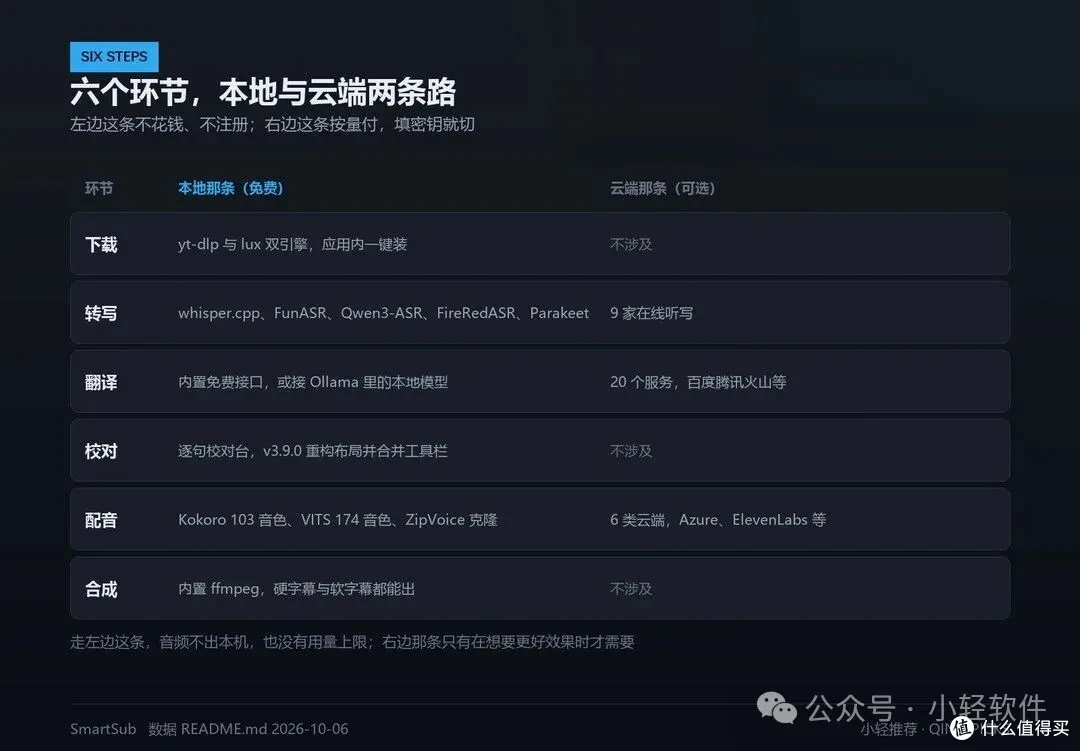
六个环节各自的本地路与云端路
STEP 01
下载
yt-dlp 用来下海外站点的视频,比如 YouTube,据说支持 1800 多个站点;lux 则针对国内的站点,B 站、抖音、小红书这些平台都支持。链接直接粘贴,它会自己识别使用哪个引擎,需要手动下载引擎。实际测试了 Youtube 和 B 站的视频,都能完成保存。

下载引擎页,两张卡各带自己的安装日期,下面是刚用 yt-dlp 下完的一条 YouTube 视频
STEP 02
字幕转写
加载你要处理的视频,选择好视频默认的语言,会自动识别生成字幕。
场景给了一组预设,按素材分档。会议访谈、网课演讲、影视 Vlog、短剧短视频各有各的切分与停顿策略,通用均衡兜底,不确定选哪个就用它。不想用预设的话,专家自定义能调 Beam Size、VAD 灵敏度和幻觉过滤这些底层参数。其中说话人聚类、术语校正、口语化这几项要额外接服务。

字幕页,一条任务走完提取、转写、导出三步,语音模型用的是 Whisper.cpp,输出 SRT
STEP 03
翻译
给字幕换一种语言,有免费接口、付费服务、和本地模型三选一。测试时免费的一直失败,最后使用 DeepSeek 的接口完成了翻译。

字幕页的逐句对照,一条 3 分 20 秒的片子切成 113 句,每句英文原文配一行中文译文,顶部标着 23 处待检查
STEP 04
校对
界面里有个逐句校对台,对着字幕一句一句过。识别和断句总有出错的地方,这一环是留给人补的。

校对台,2 分 14 秒的片子逐句带时间码,选中哪句就在右侧改哪句,行下标着字符数与 CPS
STEP 05
配音
将字幕文字转换为其他声音,音色可以挑选,也能用克隆声音。测试了默认的引擎,声音 AI 感比较重,VITS 引擎比较自然,克隆声音没有测试。

配音台,左侧挑引擎、声音和语速,右侧 58 句台词逐行列出,每行还能单独换音色
STEP 06
合成
最后出片,可以选择字幕的样式,重新生成的音轨可以加入。

合成台,左侧挑字幕样式、右侧实时预览,底部切硬字幕与软字幕,编码可选 CPU 或硬件加速
03 / TOOLBOX
工具箱
六个环节之外,它还攒了一盒周边小工具,一共八个,处理全在本机。字幕格式互转,SRT、VTT、ASS、LRC、TXT 这些都能倒,ANSI、GBK 乱码能探出来修掉,也能转简繁。视频按毫秒级区间无损裁,裁好直接送进转写。音轨一键抽出来转 MP3、WAV、AAC、FLAC,预设里带一个 16 kHz 的语音识别档。MKV、MP4 里内封的字幕轨能单独抠出来。时间轴可以整体平移、按比率压缩,或者用首尾双锚点重采样校准。双语字幕按时间轴重叠合并,也能拆回两份单语。社交分享的轻量压缩能压到 25 MB 以内。片段还能导出成 GIF 动图。
这些单拎出来都不算大功能,找个在线站也能对付。放进同一个应用,好处是跟前后步骤接得上,裁完的片段送进转写,抽出的音轨直接配字幕,中间少一通导出再导入。

工具箱,八个周边小工具按字幕处理、视频剪辑、音频转换分了三类
04 / MCP & COPILOT
MCP 工具和 AI 助手
111
个 MCP 工具,外加一套统一命令行
Cursor、Codex、Claude Code 在应用里都有导入入口,配置不用手写

MCP 与 CLI 的接线方式
除了被外部 AI 调度,它自己还带了个助手,在右侧的抽屉里,顶部工具栏点开或者按 Ctrl+J 呼出(macOS 是 ⌘J)。这助手知道上下文,你在哪个页面、视频播到第几秒、当前选中哪一句、任务队列跑到哪、最近报了什么错,它自己关联,不用你先把背景交代一遍。
对着它说人话就能干活。
你说
把当前这段视频转成中英双语字幕并合成
它做
那 111 个工具它自己也能调,照着做。
你说
把这一句改得更口语化
它做
改动直接落进编辑器,也进撤销栈,反悔了还能撤回;只有你说保存,它才写进文件。
遇到报错弹窗,或者不知道该怎么配的参数,点相机图标把当前界面截给它,模型看着图给排查思路。
音视频、字幕、文稿、图片都能拖进对话框,音视频不上传云端,只把本地路径交给底层工具处理。模型要自己填,DeepSeek、通义千问、Gemini、SiliconFlow、DeerAPI,或者任何 OpenAI 兼容的端点都行,支持流式回复,也能单独设系统提示词。
05 / INSTALL
安装
三端四个包,macOS 用 Homebrew 装最省事,会自动匹配芯片类型。
WINDOWS · x64
安装包 exe
126.6 MB
macOS · APPLE 芯片
dmg 安装包
macOS · INTEL
dmg 安装包
LINUX
deb / AppImage
装完如果 mac 报「应用程序已损坏」,按 README 跑一条 xattr 命令就好。
模型和 GPU 加速包都不在安装包里,进软件之后再下。加速这块 NVIDIA 走 CUDA、AMD 和 Intel 走 Vulkan、Apple 芯片走 Core ML,加载失败会自动退回 CPU 并在诊断面板里说明原因,遇到闪退就手动切成「仅 CPU」。
06 / LINKS
项目地址与版本发布
1 · 仓库地址
https://github.com/buxuku/SmartSub
2 · 版本发布页
https://github.com/buxuku/SmartSub/releases
3 · 官网
https://smartsub.linxiaodong.com/
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~








