













12
18
英伟达供应链AI:专家经验如何沉淀进模型?
2026-10-09 14:43:16
0点赞
0收藏
0评论
一块关键部件到货后,应该分给哪家工厂?选错了,部件可能等着其他物料配齐,另一家本可开工的工厂却在停工。对英伟达(NVIDIA)来说,这是一道牵动供应商、工厂产能和交付承诺的高价值决策。
在9月份Palantir举办的AIPCon上,英伟达展示了围绕GB200 NVL72(机柜级AI超节点)等复杂产品的物料分配实践:供应商、工厂产能和交付承诺不断变化,有限的关键部件需要每周重新安排。

图1: NVIDIA GB200 NVL72
英伟达与Palantir围绕这项“受限物料分配”(CMA)建设的系统,记录求解器方案、规划人员的修改依据和后续生产结果,再从中筛选训练材料及独立评估案例。由此,企业有机会把资深专家的判断经验沉淀进模型,并用真实业务记录检验后续版本模型是否持续改进。
一、英伟达如何把每周物料分配变成模型学习材料
先选定要改善的结果
英伟达把供应链目标描述为“从晶圆到第一个Token”:设备最终要完成组装、部署,才能在客户数据中心真正运行。此次公开案例聚焦其中的前半程,即从芯片离开晶圆厂到机柜系统抵达数据中心,受限物料分配正是这一段反复发生、影响重大的决策。
分配以周为单位,覆盖本季度和下一季度;最近几周已有交付承诺,每周新增的信息主要改变更远期的安排。GPU、CPU或内存哪一种最紧缺,也会随着到货和产能变化而改变。对于规划人员来讲,核心要解决的问题是:在现有承诺不能随意改动的前提下,哪些物料应在什么时间送往哪些制造站点,才能尽快形成完整产品?
英伟达用持有时间(Time of Ownership,以下简称TOO)衡量这件事:从制造站点收到一项物料,到它作为组件或产品离开站点,经过了多久。系统希望缩短关键物料的等待时间,并观察供应链有效产出,即吞吐量(Throughput),这两个指标给每周的分配定下了业务目标。
让系统知道一块零件会牵动什么
规划人员过去需要拼接表格、查邮件、打电话、开会,才能判断问题出在哪一环。英伟达和Palantir共建的供应链运营指挥中心(Command Center),把物料、制造站点、供应商承诺、产能、分配和实际产出放到一个工作环境中。
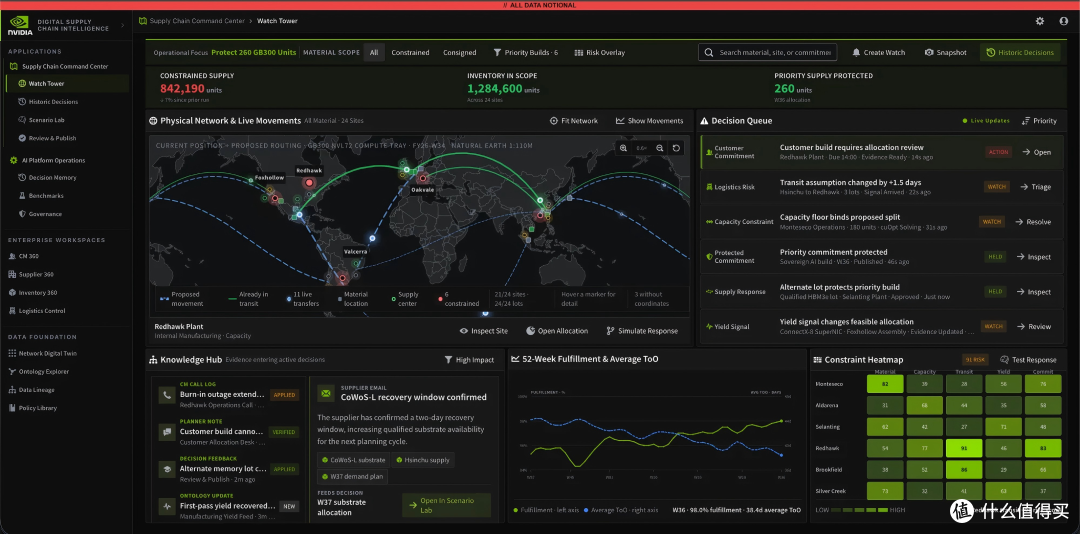
图2:Palantir Foundry平台上的英伟达供应链统一态势视图
底层的Ontology(本体)把它们组织成有关系的业务对象:一块内存属于哪张物料清单,哪些计算板需要它,哪些工厂能生产,工厂承诺了多少、实际完成了多少,都可以沿关系查到;散落在各处的邮件、供应商通话和风险事件等信息,也与相关业务对象一起,进入规划人员的视野。
cuOpt计算分配方案,规划人员依托Ontology作最终判断
有了业务关系和当前状态,英伟达的cuOpt(优化计算工具,即求解器)根据物料清单、到货时间、工厂产能和交付承诺等可量化约束,计算各站点应获得多少受限物料,使TOO尽可能低。cuOPT还会指出本周真正限制产出的约束;超快的求解速度让团队能反复比较“内存少10%”或“新工厂投产”等情景。
求解器算出分配方案后,规划人员还要判断供应商承诺是否可靠、突发事件会影响哪些工厂和订单,这些判断过去依赖分散的邮件、沟通记录和专家经验。Ontology把相关信息与供应商、物料、工厂和交付承诺关联起来,提供辅助判断,而AIP Logic和Agent Engine负责汇总线索、组织情景,供规划人员审查。
英伟达与Palantir回测历史分配时发现,规划人员将这类信息纳入判断后,决策优于单纯依靠数学方案。在实际工作流中,cuOpt提供方案和关键约束,规划人员依托Ontology核查相关业务信息,再结合自身经验,接受、修改或否决建议,并作出最终分配。
英伟达系统供应链副总裁Jeff Whitmer说,“我们希望由 Ontology、系统和技术把所有信息拼接起来,让经验丰富的规划人员真正做出最佳决策。”
把专家判断和业务结果变成模型改进材料
Palantir FDE Sid Singh在AIPCon 11说:“用户做出的每一个决策,在与业务结果建立关联之前,都只是一个日志。”Ontology把决策时的业务状态、原方案、规划人员明确给出的修改依据、最终分配、预期产出和实际产出关联起来,形成决策谱系(decision lineage)。
英伟达从真实决策中挑选有代表性的优秀案例,单独保留作验证集,并随着运营继续补充。训练侧则先对Ontology中的运营历史做匿名化处理,用NeMo Data Designer(合成数据生成工具)补充稀少的异常情景;Sid Singh还提到用Synthesizer(清洗微调样本工具)清理有噪声的训练信号。NeMo AutoModel(开源模型训练工具)通过监督微调和LoRA等方法,把专家的分析方式注入Nemotron模型。
Palantir Autopilot则管理模型生命周期:从Ontology取数、启动训练任务、记录数据与模型版本的关系,并将候选版本送入企业基准评估。评估采用历史时点回放(Replay):让新模型回到某次分配发生的那一天,只看到当天已知的信息,先隐藏之后的结果,再比较它的建议、当时规划人员的选择和实际结果。
通过评估的版本经NIM(英伟达模型推理微服务)提供推理服务,读取当前供应链状态,向规划人员建议分配范围并说明依据和风险。规划人员继续审查并作决定;新的接受、修改、否决及生产结果再写回Ontology,积累到足够有代表性时启动下一轮受控训练。要补充的是,英伟达官方技术文章明确说,模型不会在生产环境自行重训。
英伟达已披露一项模型任务结果:在其开发集上,后训练的Nemotron 3.5 Lightning分配决策准确率为86.7%,高于基础版的17.5%和通用Ultra模型的55.5%。这表明模型在该开发集的分配任务上有所改进;同一技术文章也承认,未来生产风险预测仍然困难。
Jeff Whitmer表示项目还处于早期,公开材料也未给出TOO、吞吐量或履约率的改善幅度,业务价值仍待后续运营结果验证。
二、业务结果如何推动模型学习改进
英伟达按周制定分配方案;生产和交付结果出现后,对照TOO、吞吐量及交付承诺,检查本轮安排是否兑现,并调整下一轮分配。
业务结果反馈回答的是:这次安排做得怎样?模型学习还要回答:规划人员为什么这样做?哪些专家判断值得模型学习?

图3:英伟达供应链AI的受控模型改进闭环
cuOpt依据可量化约束给出方案,规划人员会结合供应商承诺、工厂状态等信息作出修改。修改理由记录了专家关注的风险,后续结果提供检验线索。两者结合,模型才有机会学习哪些业务条件会改变分配判断。
单次结果仍可能受物料到货变化、产能和执行变化影响。业务专家需要核查这些条件,从多轮决策中筛选可复用的经验,再检验下一版模型面对未见过的情境能否作出更稳妥的判断。
三、企业如何建立持续改进的模型闭环
前两部分,讲清了英伟达如何让业务结果检验分配决策、让专家判断成为模型学习材料。企业要借鉴这套做法,关键是将决策、执行结果复盘和模型验证衔接起来,形成持续改进机制。
为此,企业需要让日常工作流稳定留下三类材料:可核验的业务结果、带有修改依据的专家决策;同时,从真实案例中单独留出不参与训练的独立评估案例集。英伟达围绕每周物料分配的实践,可以归纳为以下四步。
选一项反复发生、结果可追踪的决策。 写清负责人、不可突破的交付承诺以及何时能看到结果。英伟达选择每周受限物料分配,以TOO为首要指标;企业也应同时明确真正限制产出的约束,避免只看某项物料是否紧缺。
先建立足以支撑决策的Ontology,再建设工作流。 Palantir FDE先与英伟达专家厘清数据含义、权限、芯片与制造商等业务对象,以及规划人员的实际动作。英伟达项目直到第4或第5天,确认Ontology足以支撑分配判断后,才开始建设工作流。Jeff Whitmer特别提到,英伟达在FDE进场前已界定问题范围并准备基础数据。
让专家修改方案时留下依据。 cuOpt给出方案和关键约束,规划人员依托Ontology核查证据,再接受、修改或否决。供应商邮件等现场信息引发的改动尤其值得保留:工作流要记录原方案、修改理由、预期产出和最终分配,后续才能检验这项经验是否奏效。Jeff Whitmer称,捕捉并学习这类独特决策,就是“把NVIDIA的知识编码下来”。
用真实业务案例把关下一版模型。 企业要把训练材料与独立评估案例分开:英伟达用合成数据补足罕见情景,却从真实决策中保留验证集。积累足够有代表性的记录后,再训练候选模型,按历史时点回放并由业务专家检查,通过后才返回工作流。模型在开发阶段评估集上的分配决策表现,只能说明它完成这项任务的离线效果;TOO、吞吐量是否改善,还需在实际运行中单独验证。
以上四步解决工作流如何建,模型能否学到有效经验,还取决于两项业务判断。
由业务团队定义“好结果”。 Palantir FDE Sid Singh在AIPCon 11提出,企业应先问清:“你做出了这个决策,业务发生了这个结果,这是好事还是坏事?”对物料分配而言,规划人员需要结合TOO、吞吐量及交付承诺判断一次调整是否奏效,据此筛选学习材料,并单独留出真实案例作为验证集。
结果出现偏差,先归因再决定改什么。 如果实际产出低于预期,企业应检查当时的数据是否完整、约束条件是否变化、方案是否按计划执行,再判断是补充数据、调整规则和流程,还是更新模型。不能把每一次运营偏差都当作模型错误。





