


















 深耕汽车兴趣领域




7
5
强强联合!英伟达、海力士正式官宣合作,共同开发下一代AI内存
2026-06-08 11:00:20
0点赞
0收藏
0评论
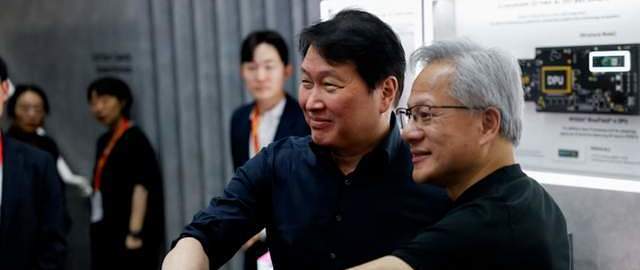
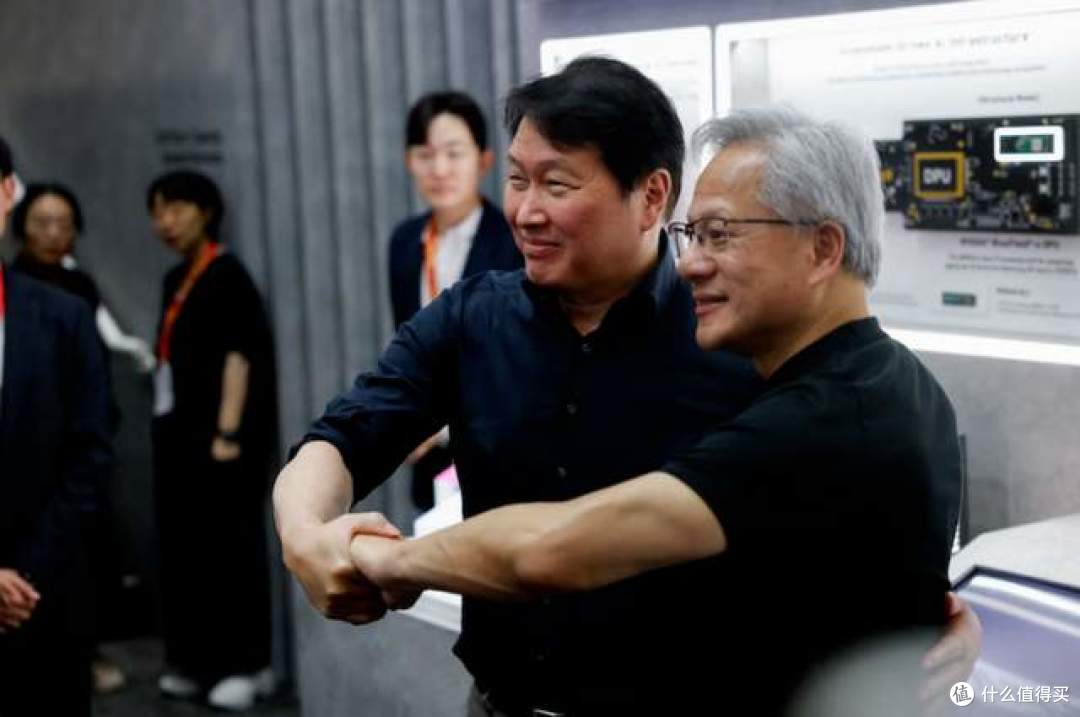
今天(6月8日)上午,英伟达与SK海力士在韩国首尔SK集团总部正式宣布建立多年期技术合作伙伴关系。
双方将围绕全球AI工厂建设所需的下一代内存展开联合研发,并将AI技术深度应用于半导体芯片设计与制造全流程,为AI时代的算力基础设施升级注入新动力。
一、合作聚焦三大技术方向
此次英伟达与SK海力士的合作并非简单供应关系,而是覆盖从内存研发到芯片制造的全链条深度协同,主要聚焦以下三个方向:
1.下一代AI内存联合研发
SK海力士将为英伟达VeraRubinAI超级计算机、VeraCPU、RTXSparkPC及JetsonThor机器人计算平台协同开发专用内存,涵盖HBM4及未来更先进的内存技术。
这意味着SK海力士将正式进入英伟达正在开拓的AI基础设施、个人AI及物理AI领域三大新市场,打破传统内存供应商的市场边界。
据英伟达官方数据,VeraRubinAI超级计算机单GPU将配备288GBHBM4内存,带宽高达22TB/s,是上一代Blackwell架构的近三倍,这种极致性能对内存的稳定性和延迟提出了极高要求。
SK海力士作为全球第二大存储芯片制造商,将凭借其在HBM技术上的积累,为英伟达提供定制化的内存解决方案。
2.加速半导体芯片设计流程
在芯片设计领域,SK海力士将全面采用英伟达CUDA-X库及PhysicsNeMo框架,大幅提升芯片仿真、技术计算机辅助设计(TCAD)工作流及内部工程代码的运算效率。
双方还将探索与电子设计自动化(EDA)软件供应商的三方协作模式,进一步优化芯片设计流程,缩短研发周期。
PhysicsNeMo作为英伟达专为物理仿真打造的AI框架,能够通过机器学习加速复杂物理计算,对于先进工艺芯片的设计验证至关重要。
这一合作将帮助SK海力士在3nm及以下先进工艺节点的芯片研发中占据优势。
3.构建晶圆厂数字孪生,推动自主化运营
在智能制造领域,SK海力士将结合英伟达Omniverse平台、OpenUSD流程及cuOpt决策优化引擎,构建完整的晶圆厂数字孪生体系。
这种数字孪生技术能够实现对晶圆厂的实时模拟、监控与优化,支持自动移动机器人(AMR)的路径规划和工厂资产的智能调度,为实现全自主晶圆厂运营奠定基础。
英伟达CEO黄仁勋在发布会上强调:“这一战略伙伴关系将确保内存供应跟上英伟达基础设施路线图的步伐,满足全球AI工厂持续建设的需求,协议期限将超两年且有能力持续续约。”
二、缓解AI内存短缺,重塑行业竞争格局
当前,全球AI算力需求呈指数级增长,内存已成为制约AI发展的关键瓶颈。黄仁勋此前多次警告,存储供应短缺将持续数年,而此次合作正是应对这一挑战的重要举措。
SK海力士、三星电子和美光科技是全球三大HBM供应商,此前已确认将在今年第三季度开始大规模生产和供应HBM4芯片。此次英伟达与SK海力士的深度绑定,将进一步保障高端内存的稳定供应,同时推动HBM4技术的快速迭代。
对于SK海力士而言,此次合作是其战略转型的重要一步。近年来,存储行业周期性波动加剧,SK海力士正积极寻求从传统存储向高附加值的AI内存市场转型。通过与英伟达的合作,SK海力士将获得稳定的高端内存订单,提升产品溢价能力,同时借助英伟达的技术生态拓展新的应用场景。
而英伟达则通过与SK海力士的深度协同,确保其AI基础设施、个人AI及物理AI三大战略方向的内存供应,进一步巩固其在AI计算领域的领导地位。特别是在RTXSparkPC和JetsonThor机器人计算平台等新兴市场,专用内存的协同开发将帮助英伟达打造差异化竞争优势。
三、内存与计算深度融合,开启AI工厂新纪元
此次合作的深层意义在于推动内存与计算的深度融合,为下一代AI工厂建设提供技术基础。AI工厂作为英伟达提出的全新概念,需要从芯片设计到制造、从数据中心到终端设备的全链条协同优化。
在VeraRubinAI超级计算机中,内存不再只是GPU附近的"高速缓存",而是整个系统吞吐的硬约束。通过与SK海力士的协同设计,英伟达能够实现内存与计算的无缝衔接,大幅提升AI训练和推理效率。
同时,晶圆厂数字孪生技术的应用将彻底改变半导体制造的运营模式。通过实时模拟和优化,SK海力士能够实现更快的量产启动、更高的运营灵活性,并降低制造成本。这一技术未来还可能拓展到整个半导体供应链,推动行业向更高效、更智能的方向发展。
写在最后
英伟达与SK海力士的战略合作,标志着AI时代内存与计算的协同进入新阶段。在全球AI算力竞争日益激烈的背景下,这种从技术研发到制造应用的全链条合作,将为AI工厂建设提供坚实基础,同时重塑半导体行业的竞争格局。
对于科技行业而言,这一合作不仅将加速AI技术的普及,还将推动整个半导体产业向更高性能、更智能化的方向迈进,值得持续关注。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~