








 深耕数码、AI兴趣领域


10
8
AI越聪明,我们为什么反而越不敢删数据了?
2026-09-17 16:53:20
0点赞
0收藏
0评论
我以前经常因为 iPhone 的容量不够而删东西。
照片、微信里下载的文章、调研报告的 PDF 以及工作资料,慢慢地就把手机给塞满了。
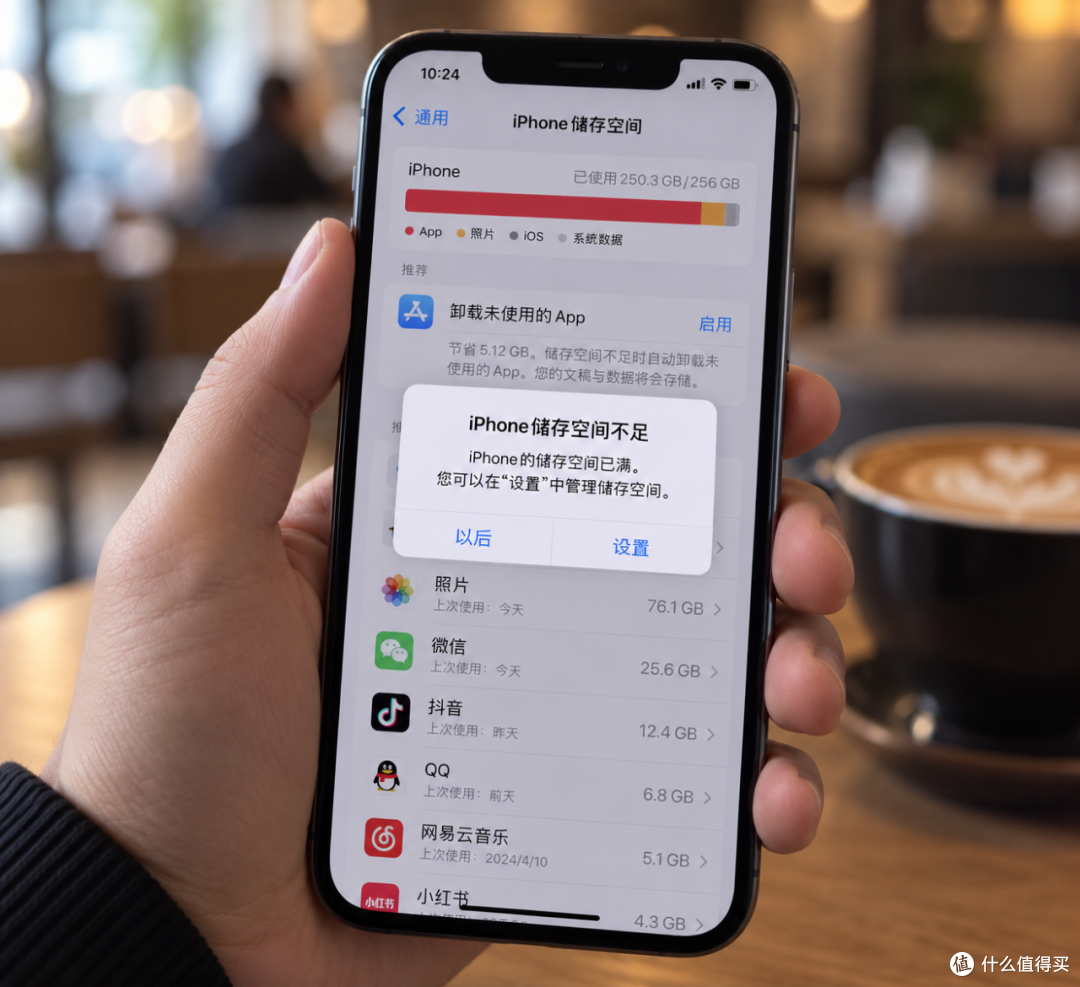
所以每次手机系统跳出存储空间不足之后,我通常也不会有太多的犹豫,先从那些很少打开的文件开始。
过去已经发表过的文章、下载了很久、以后大概率也不会看的调研报告 PDF、几年前拍的照片,挑一批不太重要的也可以删;甚至是一些体检报告的截屏,我也会删。
当时的判断其实也很正常。我认为一份数据有没有价值,最直接的标准就是最近我还会不会用到。
如果是很久没用并且留在手机里的,它就是占空间。但现在回头来看,我觉得其中有些数据删得挺可惜的,尤其是自己过去写过的文章、采访的录音和照片,以及一些体检报告之类的。
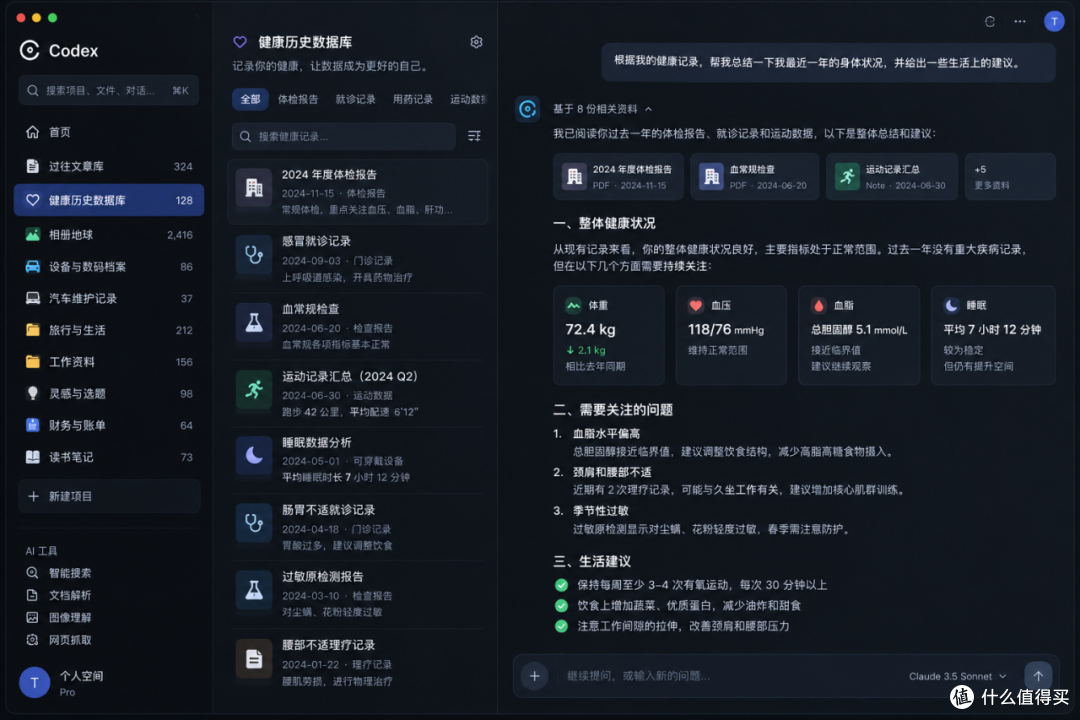
如果这些东西还在,我今天完全可以交给 AI 重新整理。
它可以帮我分析过去的文章是怎么展开的、哪些词用得比较多,以及解释技术术语问题时习惯从哪里切入。
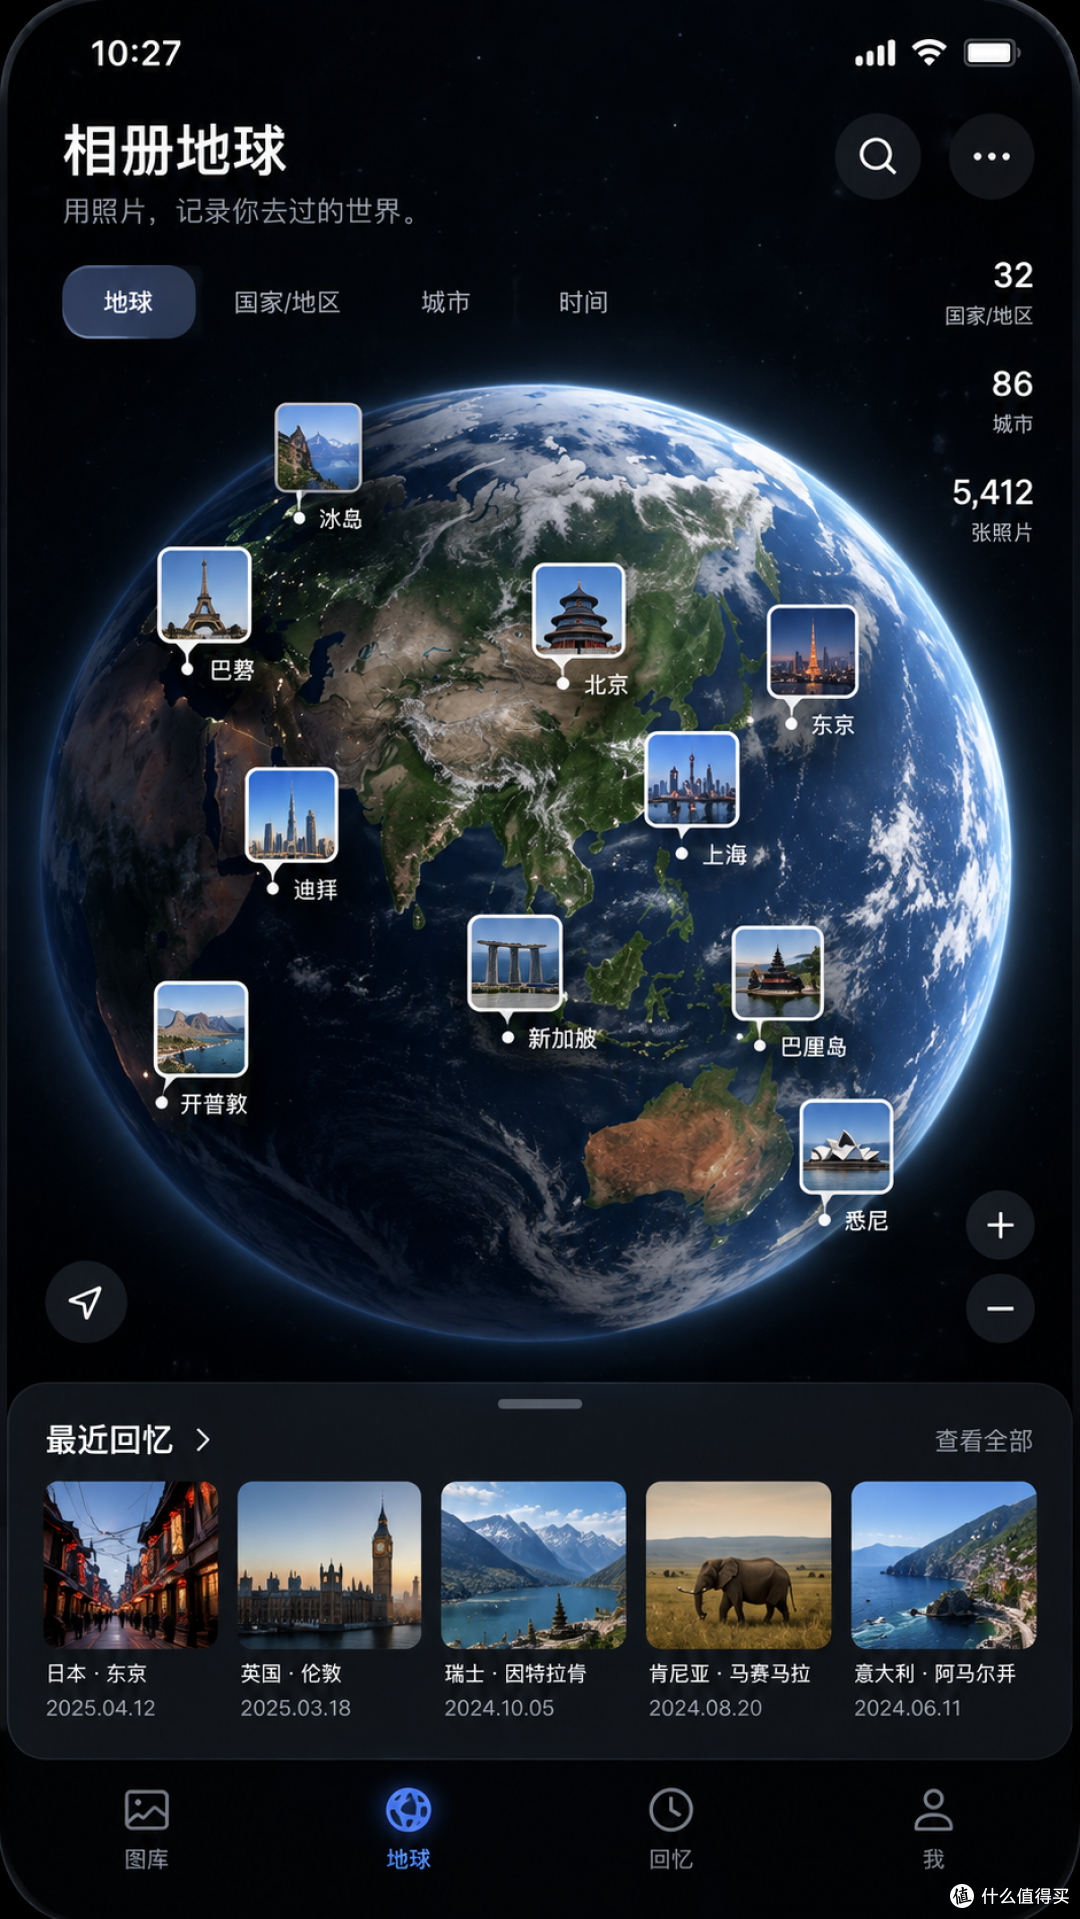
我也可以把很多年前的照片制作成一个相册地图,它能够帮我按照地点和时间,罗列出我曾经去过哪里、在哪里拍过哪些照片。
采访录音里那些当时没有继续使用的内容,也可以通过转写和语义搜索重新找出来。
而我的体检报告,则能让我直接生成一份完整的身体健康统计表,让我可以时不时回看过去和现在检查报告之间的区别,并让 AI 分析出我需要什么时候去体检。
所以,以前我以为自己删掉的是已经没有用的数据,现在才发现,我删掉的也可能只是当时还没有被重新理解的数据。
在当时当刻,我突然意识到:现在没有用和以后有没有价值,原来其实不是一回事。
过去,我对数据要不要删除的判断依据,主要看它以后还会不会被我用到。
现在有了 AI,我还需要考虑另一件事:未来有没有新的工具,能够重新理解这些被尘封的数据,并让它们再次产生价值。
哪些被我删掉的数据
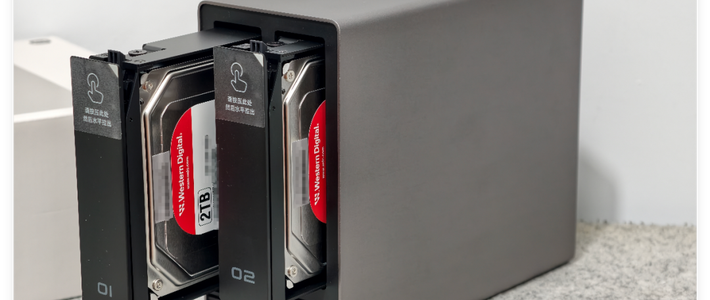
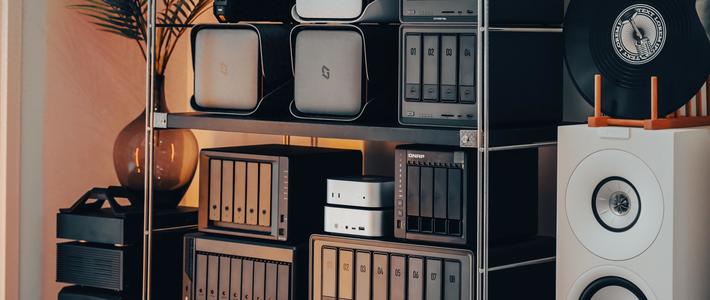
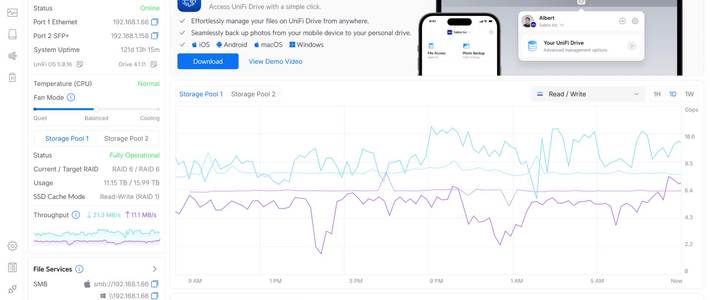
后来当我有了 NAS 之后,最大的变化是我开始大胆的删数据了,只要我觉得不常用和暂时没有价值的数据都往NAS里扔。
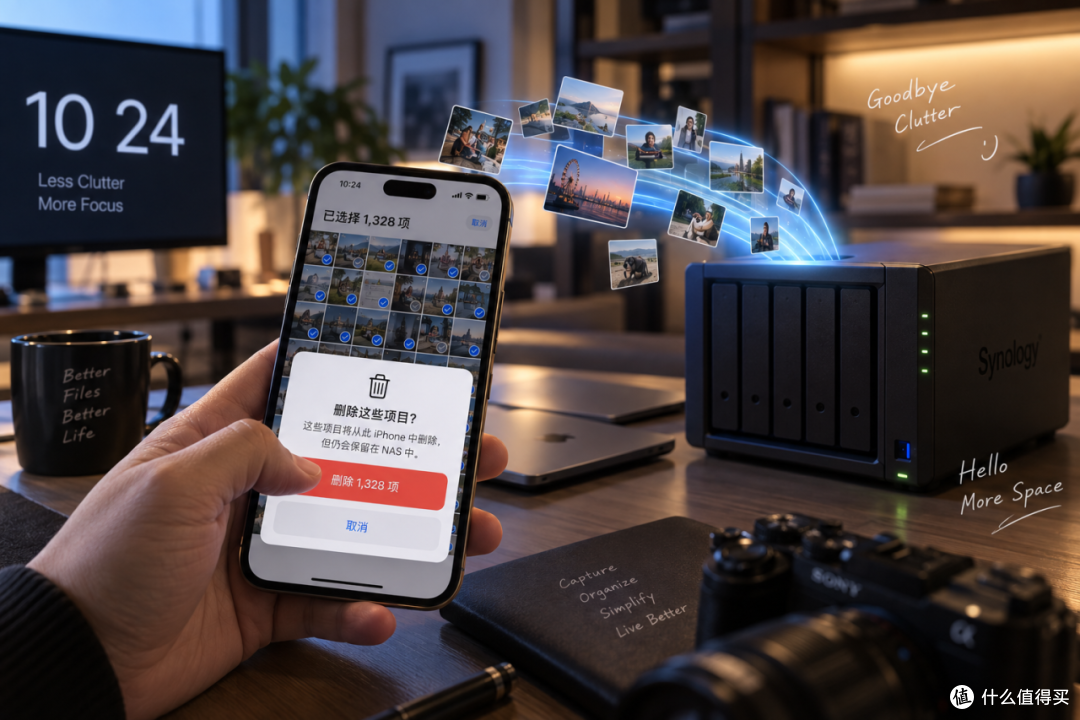
以前手机里的文件一旦删除通常就等于消失了,没有第二个备份,也没有更大的地方可以暂时存着。
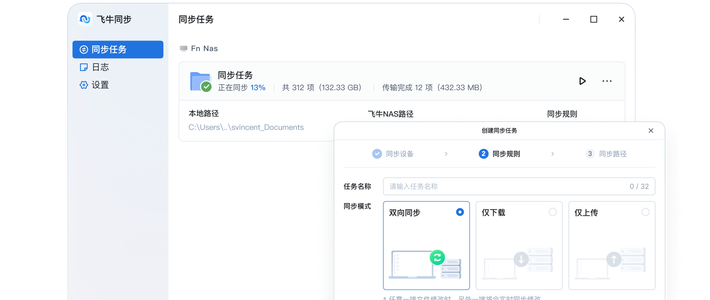
有了 NAS 之后,照片、视频可以同步备份,文章、采访录音和工作资料我可以进行归档。确认文件已经备份完成之后,可以放心大胆的清理手机的存储空间。反正以后需要随时可以从NAS调取。
这个变化看起来其实很简单,但它改变了我处理个人数据的方式。
我以前的逻辑是:不常用的、占空间的,我就把它删了。
后来变成:不常用的先转移到更大的存储空间去,未来需要的时候我再调用。
回头想想这不就是最简单的分层存储嘛。
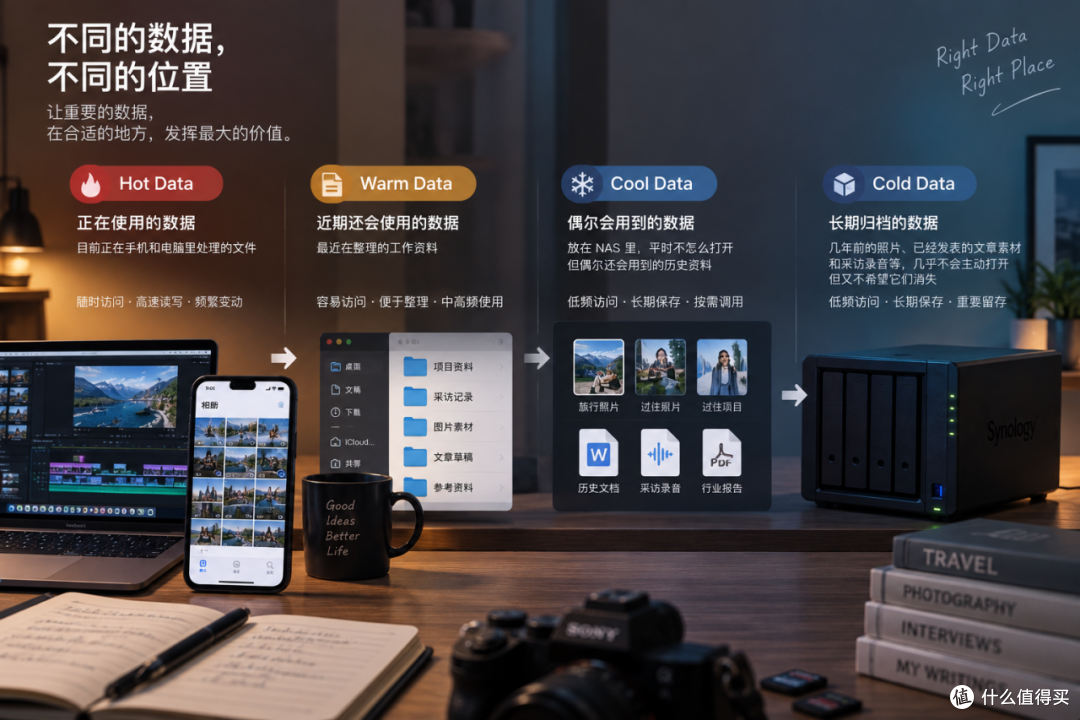
比如说目前正在我手机和电脑里处理的文件,被称为Hot Data,最近还会使用、我正在整理的工作资料,可以理解为Warm Data。
而放在 NAS 里平时不怎么打开、但是偶尔还会用到的历史资料,属于Cool Data。像几年前的照片、已经发表过的文章素材和采访录音,平时我几乎不会主动打开,但又不希望它们消失,这些就是cold data。
后来再看 IDC 把企业数据分成 Hot、Warm、Cold 和 Cold 的四层,我突然觉得这些名词没有那么复杂。
我个人数据的单位是 GB 和 TB,而到了企业级,它的单位变成了 PB 甚至 EB。但其实问题并没有变,不同的数据使用频率不同,就不应该占用同样昂贵、同样高速的存储位置,毕竟现在存储设备很贵。
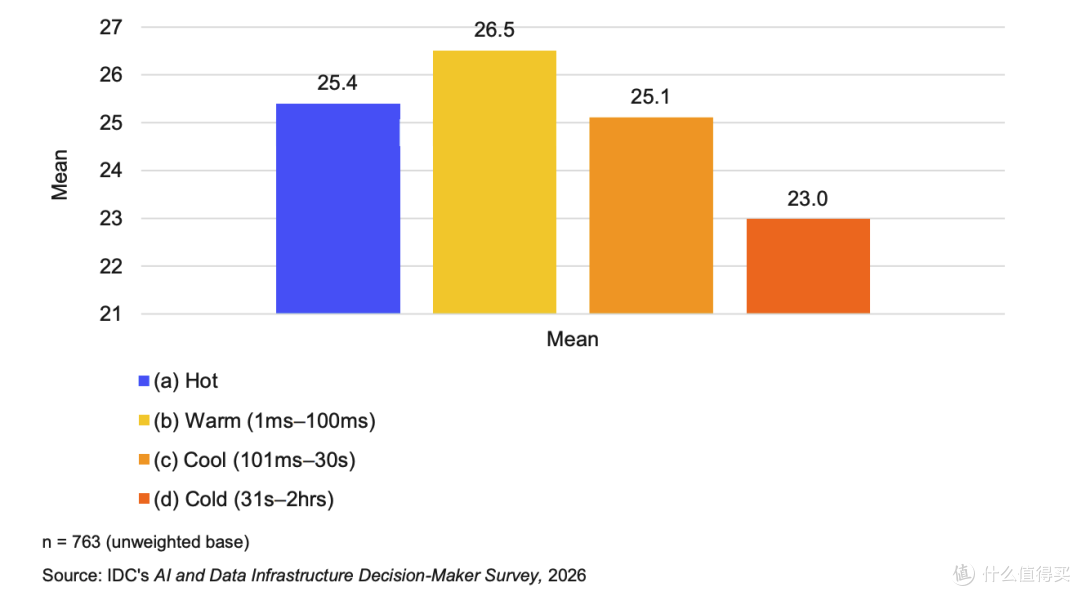
最近我看西部数据委托 IDC 开展的这项调研显示,企业现有的数据中。Hot data 平均占 25.4%,Warm data 占 26.5%, Cold data 占 25.1%,Cold data 占 23%。
而从这组数据中也能看出,真正需要最高速度随时访问的 Hot data 只大约占四分之一。剩下的 74.6% 的数据,其实并不属于必须一直放在最快、或者说最贵的存储那一类。
如果我们把企业的这种行为投射到我们自己个人的设备上来理解的话,就是当你正在剪辑视频、正在处理项目文件时,当然需要更快的 SSD 来提升效率。
但是,十年前的照片、已经完成的视频和已经剪辑完的素材,你根本不会用到,就没有必要一直占据最昂贵的高速空间(也就是 SSD)。
所以,过去我们做分层存储,主要是为了节省空间和控制成本。
但是现在 AI 出现之后,这件事情就开始变得复杂了。
原来我早就在分层存储
以前将我的数据放进 NAS 里,某种程度上只是因为我舍不得删。
照片拍完以后,照片是一种记忆,所以我愿意备份进去,过去写过的文章是自己的辛苦劳动,所以也会归档进去;采访结束之后,把录音存进去,也是为了未来某个时刻能够用来引用。
从我把它们存入 NAS 的那一刻起,它们可能几年都不会被重新打开。数据依旧还在那里,但使用的频率会越来越低,最后就真正变成冷数据了。
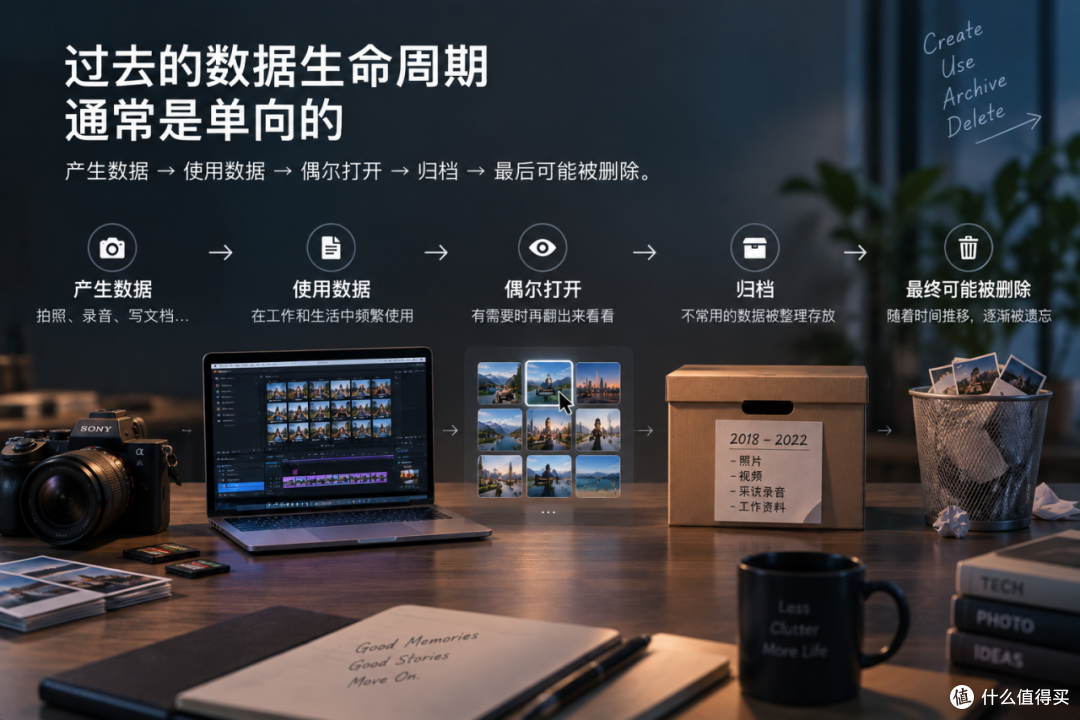
过去的数据生命周期通常是单向的:产生数据到使用数据,到数据偶尔打开,然后再归档,最后的结果可能是被删除。
而 AI 改变的地方在于,将这些旧数据重新利用的成本下降了。
比如说,我过去写过几万篇文章,我不可能逐篇重新分析,几百小时的采访录音,也不可能为了寻找一句话就把所有的音频文件都重新听一遍。照片的数量更庞大,人工整理就变成了一件很让人头疼的事情。
而现在,AI 可以帮助我整理这种非结构化的数据:去识别录音内容、读取 PDF、理解照片,再从一批旧资料里找到与我当前问题相关的内容。
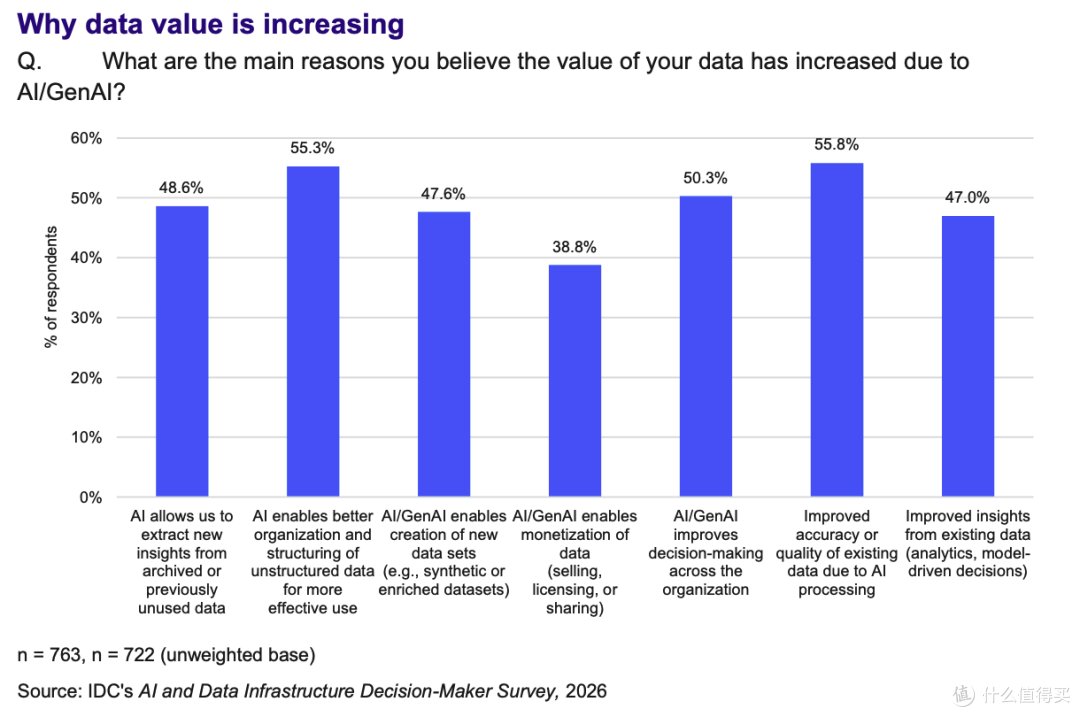
IDC 的调查中,55.3% 的受访者认为 AI 让过去难以利用的非结构化数据变得更容易整理;而 48.6% 的受访者认为 AI 能够从过去归档或没有被正在使用的数据中发现新的洞察。
这两组数据正好对应了我现在的工作情况。
我的旧文章数量并没有变化,NAS里照片也没有变化,过去采访录音同样没有变化。而真正变化的就是,现在我有了 AI,可以让我重新看懂它们,并且分析它们。
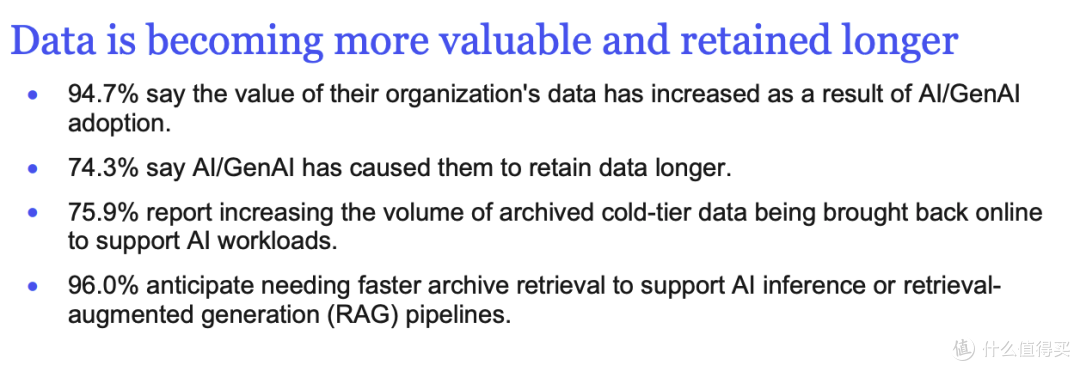
IDC 的这份调查还显示,94.7% 的受访者认为,在采用 AI 或者生成式 AI 之后,企业拥有的数据变得更有价值。而 74.3% 的受访者因此延长了数据的保存时间。
更直接的是,75.9% 的受访组织正在增加过去归档冷数据重新上线的数量,其中 23.9% 的组织认为这种增加非常明显。
看到这里,我脑中突然跳出了一句话:“冷数据重新升温”。
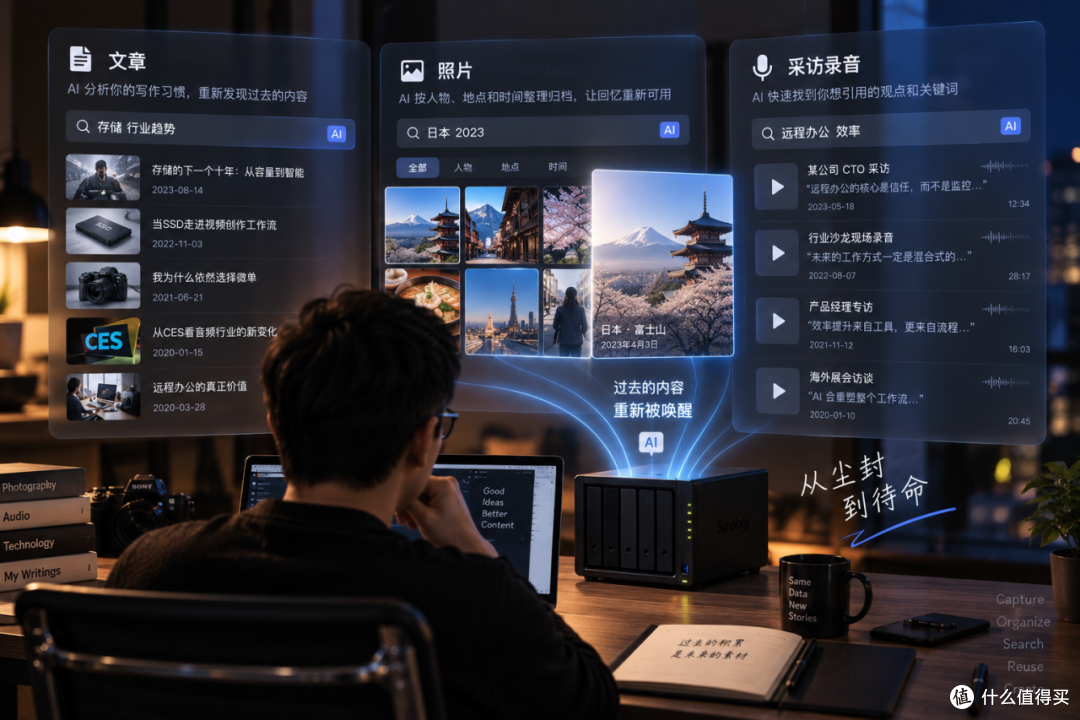
就像我以前写过的文章,因为现在 AI 能够分析我的写作习惯,所以我会把以前的文章重新拿出来。
也因为 AI 能够按照人物、地点和时间来整理归档,所以我会把以前的照片也拿出来。
因为 AI 可以快速搜索到我想引用的某个人的观点和关键词,所以我会把以前的采访录音也重新拿出来。
以前的归档意味着尘封,现在的归档更像是待命。
当然,并非所有的数据都应该永远保存。
能不能从一份数据中找到价值,还是要取决于数据本身它是否完整,是否有上下文,是否具备可检索的结构。
如果是大量重复的照片、没有意义的缓存文件,甚至是已经损坏的资料,该删的还是都删掉吧。
但自从有了 AI 的加入,对数据的判断标准确实发生了变化。
以前我只需要去思考这些数据以后还会不会用到?现在则要再多思考一层。未来有没有可能用新的工具,再重新去理解这些数据呢?
而且更麻烦的是,AI 不仅是数据的消费者,它自己也在制造海量的数据。
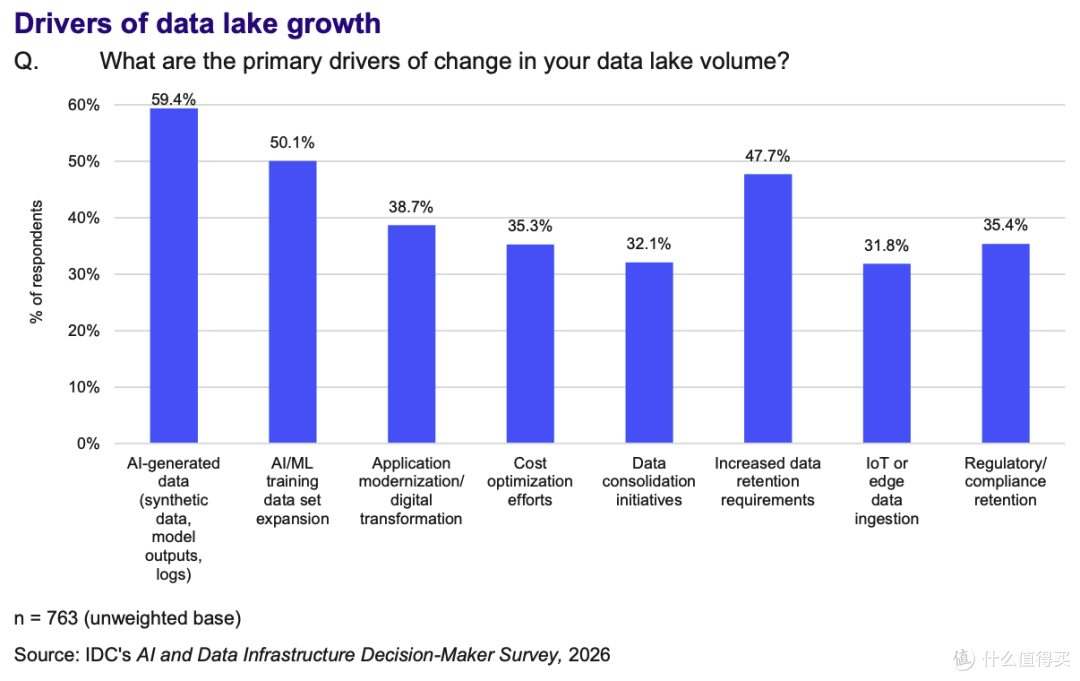
IDC 调查中,59.4% 的受访者把 AI 生成的数据列为数据湖容量增长的重要驱动力,包括合成数据、模型日志和推理结果;把训练数据集扩张列为重要驱动力的比例则是 50.1%。
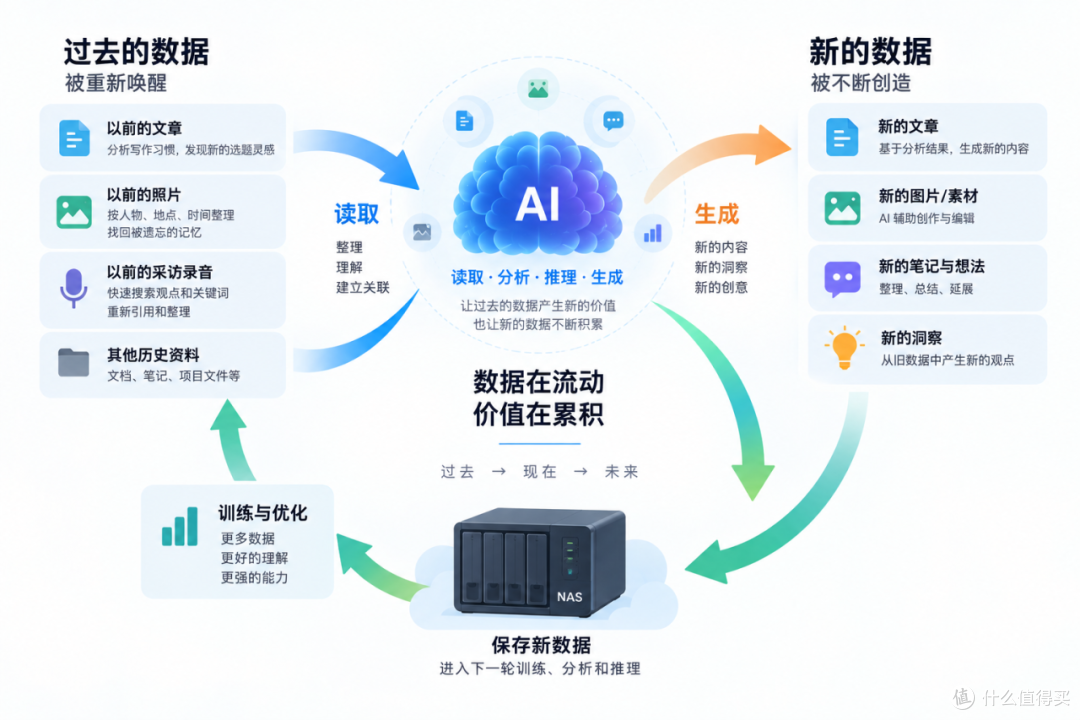
所以,AI 一边在读取旧的数据,一边也在生成新的数据。新的数据又可能被保存下来,进入下一轮的训练、分析和推理,形成一个循环。
当企业面对的已经不是一次性的存储扩容,而是数据不断被调用、生成和回流的循环的时候,越来越多的数据都留下来了,难道以后都要存在 SSD上吗?
冷数据,重新热起来了
如果我们只看 AI 芯片、GPU、HBM 跟 NVMe SSD,很容易产生一种错觉,就是 AI 时代所有的东西好像是越快才越好。
但到了存储系统中反而不是这样。
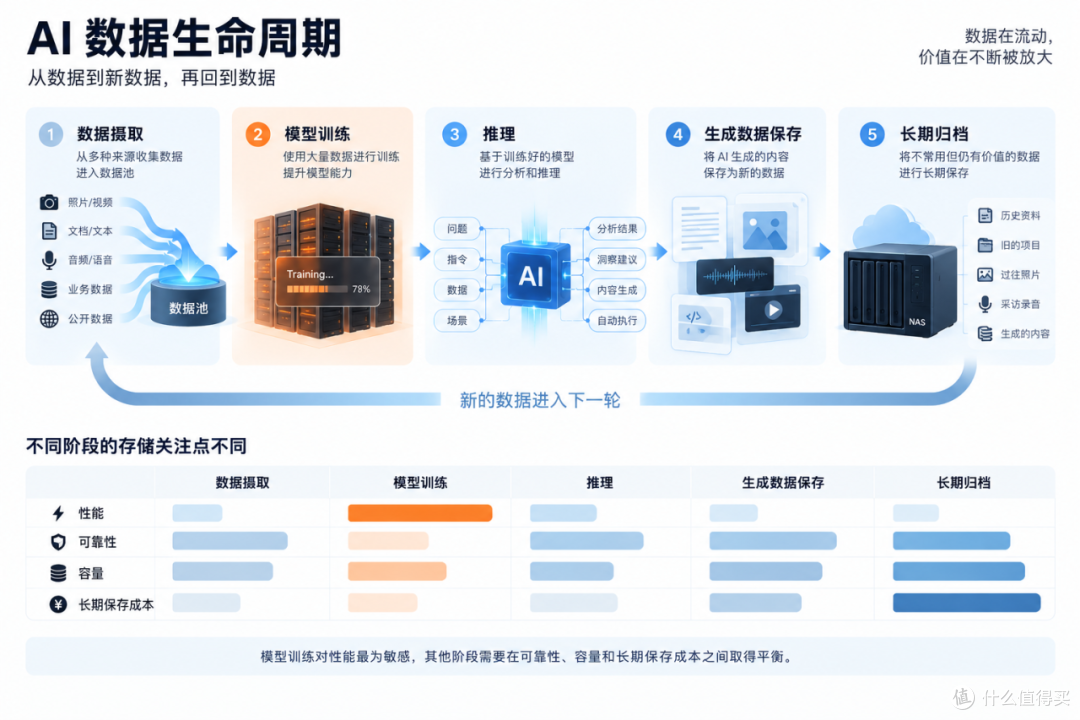
IDC 将 AI 数据生命周期拆成了数据摄取、模型训练、推理、AI 生成数据保存和长期归档几个阶段。
真正明显把性能放在第一位的,主要还是模型训练,其他的阶段往往需要同时考虑可靠性、容量和长期的保存成本。
这和普通人使用存储的方式没有本质的区别。
比如说,你如果正在剪辑视频,肯定希望在高速的 SSD 上运行,同时整个项目中的视频素材,你也希望能够放在SSD上以便快速地进行调用。
但是你已经发布过的视频和素材原始数据,你并不会想着随时去调用和读取,你只是希望它不要消失就好了。
所以产生了一种矛盾:冷数据虽然访问频率很低,但还是有访问的需求在的。
就像 AI 推理和 RAG 会重新调用过去已经归档的资料,所以企业希望历史数据仍然能够被找回来,而不是被放进一个完全不可访问的黑盒中。
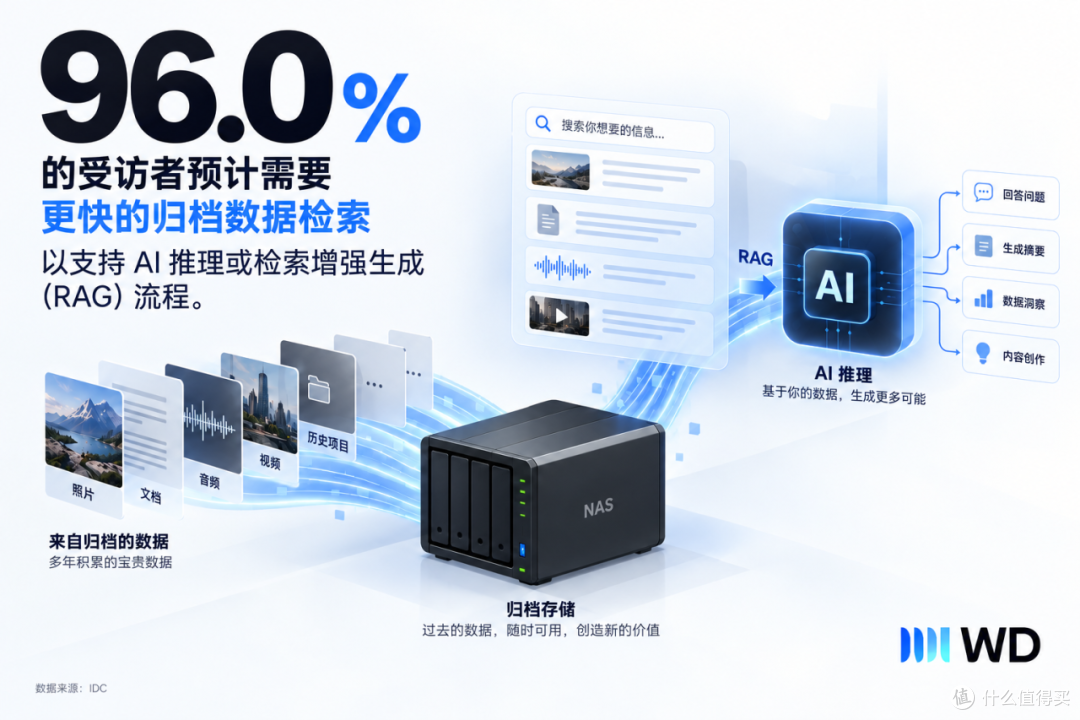
白皮书中显示,96% 的受访者预计未来 AI 推理和 RAG 会需要更快地访问过去归档的数据;其中 45.3% 的受访者认为这种需求会显著增加。
这两组数据改变了企业传统归档的含义。
这也是为什么西部数据会在这个时间点继续讨论 HDD 在 AI 时代的位置,
不只是因为它卖机械硬盘,也不是 HDD 要和 SSD 去比性能。而是未来又可能被 AI 重新调用的数据正爆发式增长的现实问题。
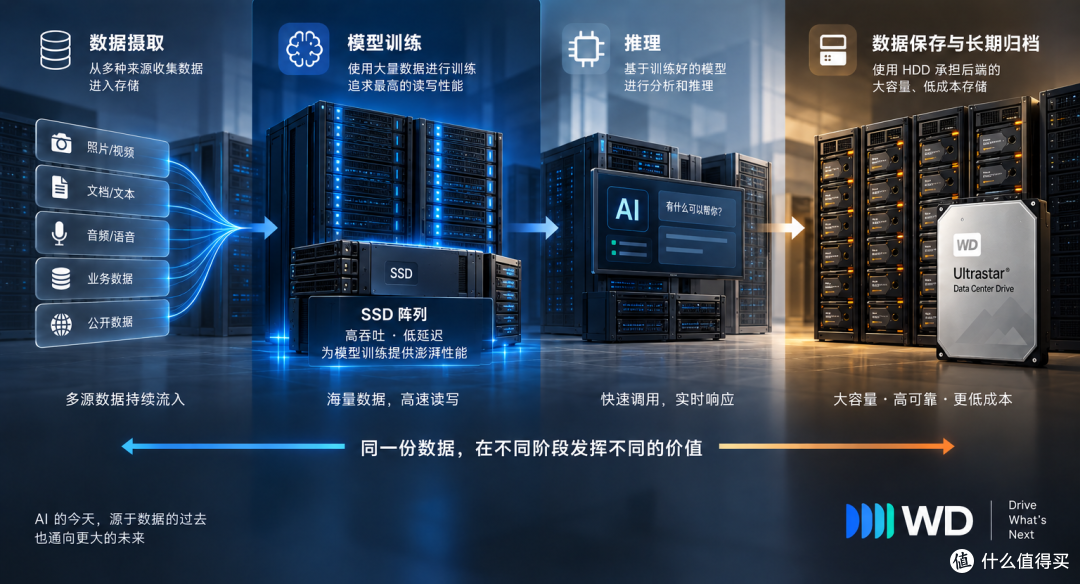
白皮书里提到,一些客户会在模型训练阶段部署大量的 SSD 阵列,训练完成之后会再使用 HDD 去承担后端的容量存储。
这其实很符合数据分层的逻辑:SSD 解决的是现在要有多快,HDD 解决的是未来要存下多少。
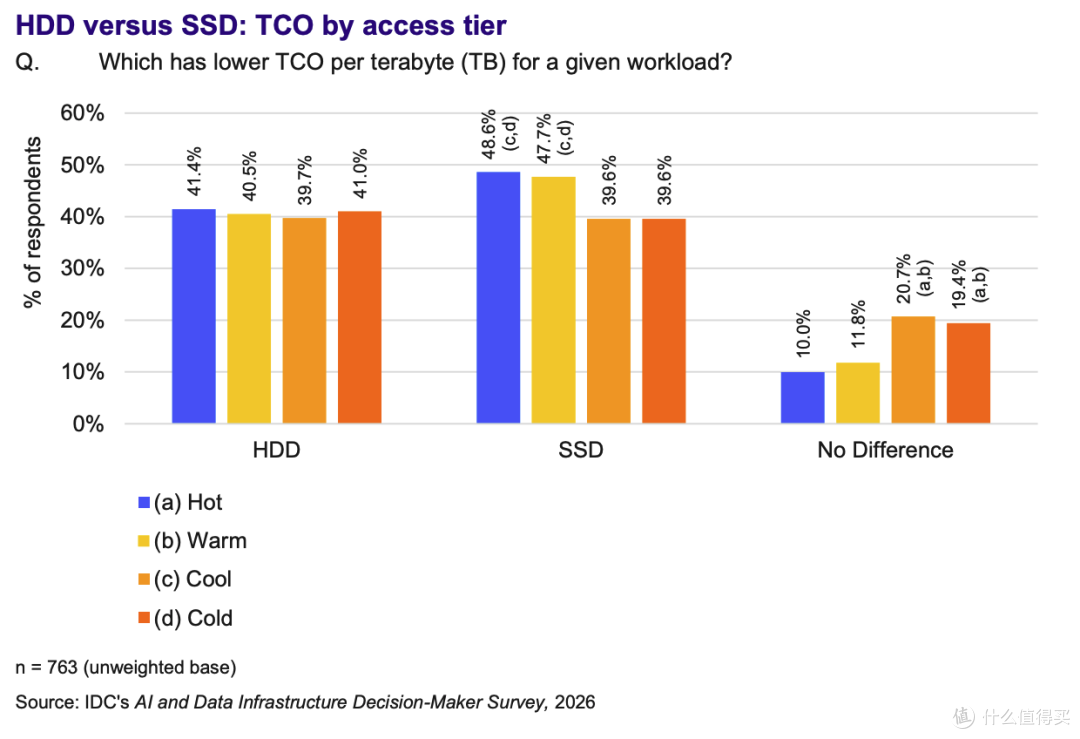
IDC 对不同存储层的每TB总拥有成本调查显示:在Hot和Warm层,更多的受访者认为 SSD 的总拥有成本更低;但到了Cool层,两者大致接近;在Cold层HDD 才开始体现出容量的经济性优势。
而我认为,在这四个分层中,Cold层的数据量应该是最大的。
理性来说,其实企业要判断的是哪些数据值得为速度付费,哪些数据应该为容量和长期的保存来付费。
当然,数据越热,性能的价值越高;数据越冷,容量越大,单位 TB 成本就越重要。
西部数据的品牌和产品路线,真正能接上的也是这一层的需求:让容量继续扩大,同时让长期保存的数据保持可访问,而不是简单地把所有数据都推向最高的性能。
AI 时代仍然需要 HDD
回到我自己的 iPhone 和 NAS 上,这件事情其实已经发生过一次了。
手机和电脑里的空间有限,所以我需要删除一些文件,但我又不希望因为空间不足,把未来可能有用的资料一起清掉。
NAS相当于给我提供了一个中间位置:它不需要像手机那样随时响应,但也不会成为离线的冷库那样难以访问。
企业数据中心面对的是同一个问题,只是数据规模比我大了很多。
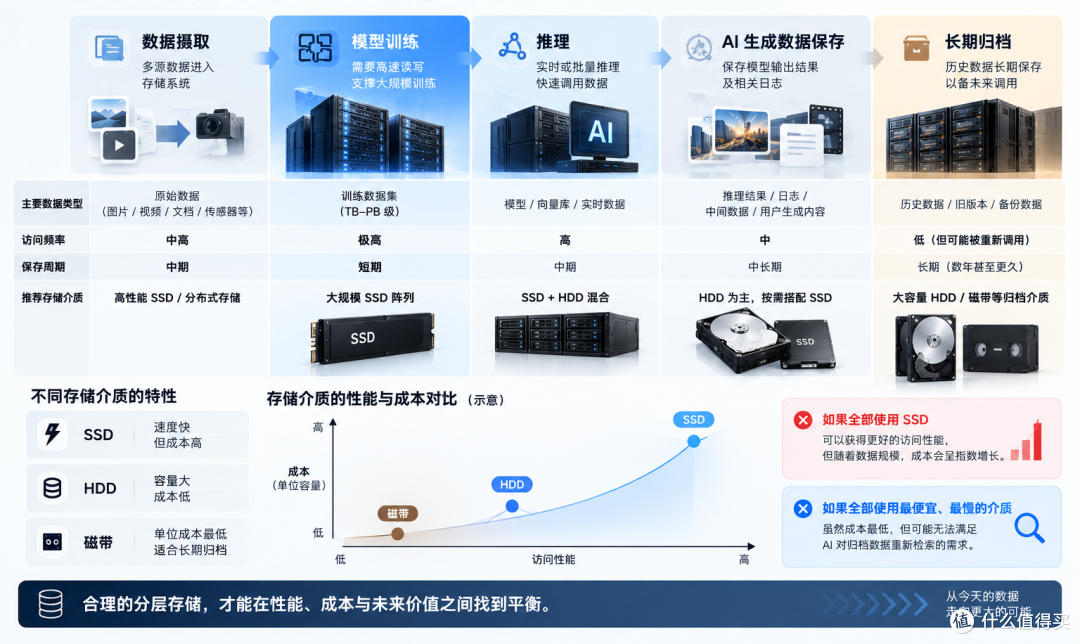
模型训练阶段需要高速存储;训练完成之后,模型相关的数据集、日志、推理结果和历史资料仍然要保留下来。它们的访问频率不同,保存周期不同,未来被调用的可能性也不同。
如果都放在 SSD 里,当然可以获得更好的访问性能,但成本也会随着数据规模呈指数据增长,如果都放在最便宜、最慢的介质里,又可能无法满足 AI 对归档数据重新检索的要求。
所以在看我来,AI 并没有让存储走向一种介质统揽天下的格局。
恰恰相反,它可能让分层存储变得更加明显。
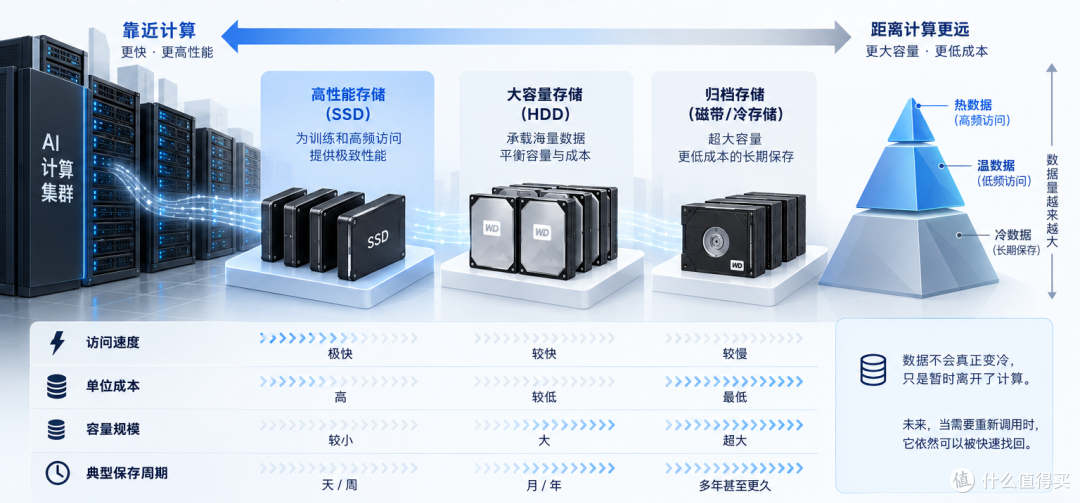
靠近计算的数据需要更快,而距离计算较远、但数量越来越多的数据,则需要更大的容量和更低的单位成本,同时又不能真的失去访问能力。
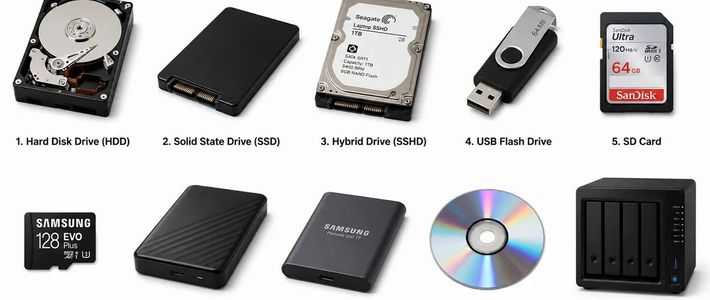
HDD 在这里承担的并不是替代 SSD,而是作为容量层的一部分。
这也是西部数据想要强调的,并非机械硬盘可以通吃所有的场景,而是当数据规模开始增长、访问频率下降之后,机械硬盘的容量经济性会重新变得重要。
这和普通用户购买 NAS、移动硬盘的逻辑很接近。我们不会把所有的照片都放在手机里,也放不下那么多。
当然,我们也不会把正在剪辑的视频直接放在一块只适合长期归档的硬盘上,不同的数据放在不同的位置,究其原因并非是技术偏好,而是使用方式的不同。
AI 会让一些原本被冷落的数据重新被调用。比如说我那几万篇文章,可能会成为分析我个人写作风格的重要素材。
我那么多年积累下来的采访录音,可能会成为当下回答某个历史问题的依据。
未来的存储系统,不仅要看数据现在用的多不多,还要考虑以后会不会再用到。
但至少,AI 让我们重新看见了一个过去容易被忽略的问题:
很多数据不是没有价值,只是过去找到价值的成本太高了。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~