













1
1
AI一次甩出722篇数学论文,25位菲尔兹奖得主坐不住了
2026-10-15 10:50:18
0点赞
0收藏
0评论
AI 一次性端出 722 篇数学手稿,数学界第一次被批量生成的成果打了个措手不及。
剑桥大学菲尔兹奖得主詹姆斯·梅纳德形容,一场“海啸”正涌向数学的海岸;同为菲尔兹奖得主的雨果·迪米尼-科潘则提醒,这批手稿涉及海量理论与数据,验证工作量巨大。这批由 OpenAI 内部 AI 模型生成的手稿,9 天前被集中放上 GitHub,整理为 372 组成果,覆盖数论、代数几何、理论计算机科学等 17 个方向。
这不是一次普通的模型升级公告。约一个月前,同一家公司宣称其内部系统解决了纳维-斯托克斯方程的存在性与光滑性问题,七个千禧年大奖难题之一。而在发布前的一个多月里,数学界已经经历了 25 位菲尔兹奖得主的联合声明、独立顾问小组的公开警告,以及一位菲尔兹奖得主加盟 OpenAI 的人事震动。
真正的问题不在 AI 能不能做数学,而在一门以恒久性立身的学科,能否消化一种发现成本近乎为零、验证能力却原地踏步的知识生产方式。
公布了什么10 月 6 日发布的仓库包含三个部分:722 篇手稿及源码、10 份模型推理摘要、部分证明的 Lean 形式化版本。Lean 是一种能被计算机逐行核验的证明语言,能排除推导层面的逻辑漏洞,但前提是形式化陈述与原命题一致,这一步仍要人来把关。OpenAI 称,模型此前尝试了约 4000 个研究问题,平均每项成果消耗的算力约相当于 ChatGPT Pro 思考三小时。
从宣布到发布,两次动作相隔约一个月:先是纳维-斯托克斯问题上的单点突破,随即是数百项成果的集中倾泻。发布的目的更接近于展示能力边界,而非与学界共同完成一次严格的成果确认。
手稿的名头确实惊人,准黎曼猜想、霍奇猜想、伯奇和斯温纳顿-戴尔(BSD)猜想、有理数域上的希尔伯特第十问题,千禧年难题沾边三道。
需要说明的是,其中多数是对相关难题的推进与局部突破,比如只解决了黎曼猜想的弱化版本,但 2024 年在同一方向上取得过重大进展的梅纳德称之为“开创性意义”,是“解析数论领域过去一百年来最重磅的成果”;也有手稿宣称完全解决了悬置 50 多年的有理数域上希尔伯特第十问题,同样未经核验。
伦敦大学学院的弗朗西斯·约翰逊研究其中的沃尔 D(2) 问题长达 25 年,最终本人放弃。他说自己近月与 AI 模型协作研究,其分析的缜密程度令他震惊:精灵已经出瓶。
然而公布不等于证实。
发布次日,OpenAI 撤回了三篇预印本,另修订 14 篇、更新 13 篇引用,手稿总数由 722 降至 719:一个错误使其中一篇的论证失效,并连带影响另外两篇。模型本身至今未公开,第三方无法独立复现。OpenAI 发言人向《科学美国人》证实,绝大多数结果由单一提示、单一智能体一次生成。麻省理工学院数学家安德鲁·萨瑟兰的态度随之被广泛引用:在模型发布、人们能够复现成果之前,任何关于单一智能体一次性解决问题的说法都应视为未经证实。
数字收敛之路评价这批手稿,关键是把“生成”和“确认”分开。帝国理工学院的凯文·巴扎德提供了一个罕见的抽样数据:发布成果中属于他研究的数论领域的有 30 篇,其中看起来质量突出的仅 7 篇,通过 Lean 形式化验证的只有 1 篇。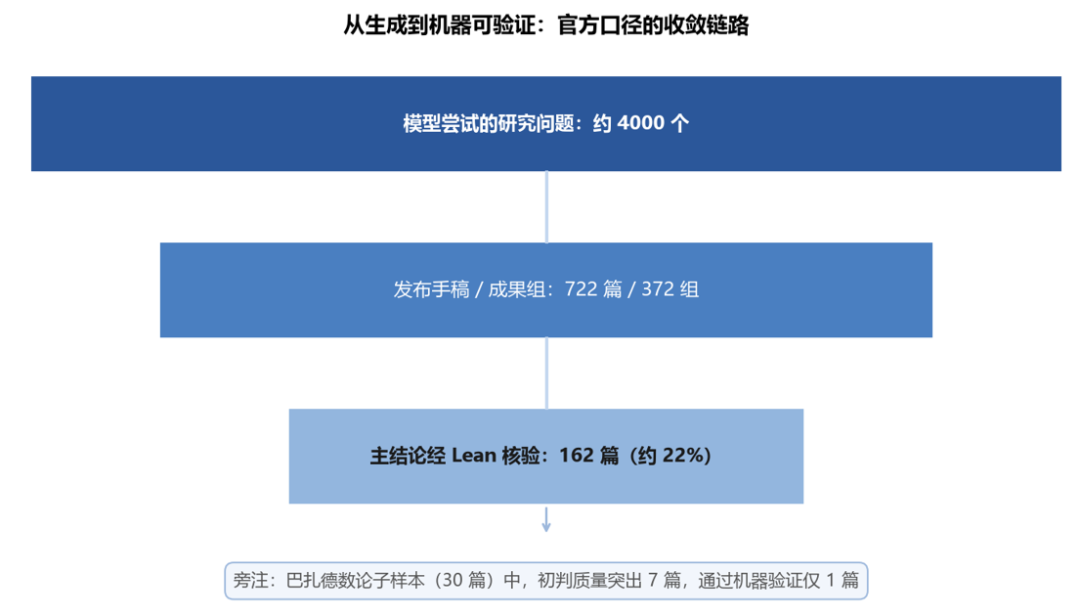
从约 4000 个问题到 162 篇经机器核验:官方口径下的收敛链路(据 OpenAI 仓库形式化目录整理;巴扎德抽样为旁注)
这不构成对成果质量的否定,但构成了对传播方式的质疑。
OpenAI 自己的口径是,约四成顶层结果附有 Lean 形式化,按官方形式化目录,折算到论文层面为 162 篇、占比约 22%。巴扎德的抽样提供了更贴身的参照:30 篇中质量突出的 7 篇,通过机器验证的只有 1 篇。自称“已解决超过 100 个开放问题”,与可被机器核验的成果之间,缺口仍然醒目。
问题不在数字本身有假,而在发布流程把最不成熟的环节(自然语言证明)和最可靠的环节(Lean 形式化)打包成同一条新闻,由读者自行分辨。菲尔兹奖得主陶哲轩给这种状态起了个名字:“证明消化不良”:机器高速生成证明,人类来不及验证、理解、教学和吸收,最后攒下一堆无人能消化的文本。
验证缺口还带来一个常被忽视的后果,读懂 AI 证明正在成为一门新的苦役。
预印本平台上,无人能完全消化的 AI 辅助证明正快速增多,迫使研究者把机器输出改写为人类可核查的形式,而这部分劳动目前几乎不获得任何学术回报。当理解成为瓶颈,愿意投入消化工作的人却在减少,缺口只会越拉越大。剑桥团队还发现,纳维-斯托克斯论文与 Lean 代码存在明显不一致,形式化结论弱于论文宣称。机器验证不等于论文宣称的结论已获核验。
更值得警惕的是优先权机制的失灵。纽约大学的巴克马斯特与 Anthropic 的阿尔珀格曾独立使用大语言模型攻关同一问题,并在 OpenAI 宣布前约 12 小时发表了自己的说法;OpenAI 对此提出异议,双方各执一词。当发现变得廉价且并行,围绕“谁先做出来”的争议将成倍增加,而现有的署名与评审制度并没有为此做好准备。
三重警报:制度碰撞升级把时间线摊开,可以看到数学界的反应几乎与 OpenAI 的节奏同步升级。
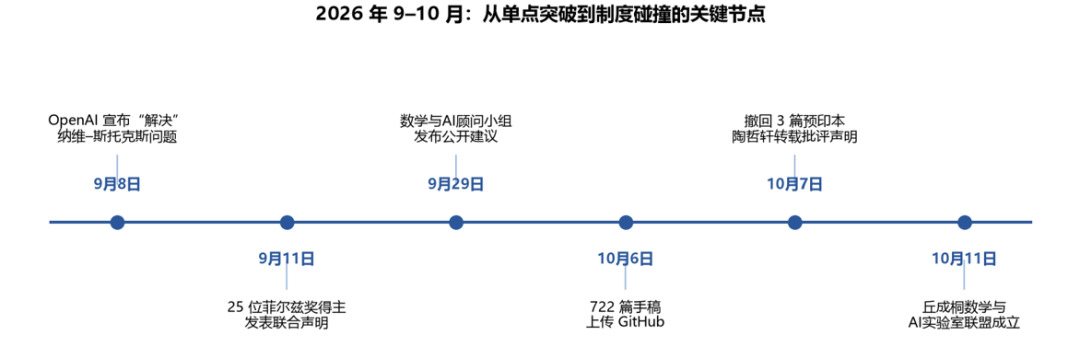
2026 年 9 至 10 月关键事件:产业界的发布节奏与学术界的制度回应交替出现
第一重警报来自人才。2026 年菲尔兹奖得主雅各布·齐默尔曼在 7 月的国际数学家大会上宣布转向 AI 安全并加入 OpenAI。一位处于学术荣誉顶端、因证明安德烈-奥尔特猜想等成果获奖的数学家,宣布入职后将停止招收博士生。薪酬只是表层原因,更可能的解释是算力与问题资源的落差。
第二重警报来自数学共同体的集体表态。9 月 11 日,陶哲轩、邓煜等 25 位菲尔兹奖得主发表声明《人工智能在数学中的严重错位》;10 月 7 日,陶哲轩又在博客转载“人类数学协会”的声明,呼吁数学家停止与 OpenAI 合作。
声明直言,一次性发布 700 多份文件展示的不是学术研究,而是权力。措辞激烈,但指向清晰:争议的核心是发布流程绕开了同行评议,而非 AI 做数学这件事本身。作为对照,Anthropic 此前公开了费马大定理 1300 万行 Lean 验证代码,巴克马斯特团队同日公开的三项成果也均附带可下载的形式化证书。
第三重警报来自合法性框架的动摇。设在普林斯顿高等研究院的数学与人工智能顾问小组早在 9 月 29 日就警告,专有模型可能造成两级体系,使实验室跑赢整个领域。
耐人寻味的是,据其早期声明,该小组曾倾向于认为前沿 AI 企业不应利用内部模型对高级数学问题进行测试,而 OpenAI 恰恰是在此前提下推进并发布的。合法性框架被自身引用的机构所质疑,这是本次事件中最具讽刺性的一笔。法国数学家维拉尼的表态则代表了另一种期待:这将是数学领域的一场变革。
值得注意的是,中国数学界的回应提供了另一种声音。丘成桐在清华大学表示,这是学者最兴奋也是最危险的时代,AI 是一个集大成的工具,把人类有史以来直到今天的思考通过强大算力聚合起来;中国科学院院士席南华则指出,企业发布成果不受学术规则约束,发布不需要经过同行严谨核验,甚至允许错误内容流出;在他看来,新的共识还在形成,规则需要数学界与产业界在磨合中逐步建立。
批评与建设并存,说明共同体的分裂不在于要不要 AI,而在于由谁定规矩。建设性的一面也有了实物,上海数学与交叉学科研究院与清华大学丘成桐数学科学中心的团队日前报告,用 AI 辅助构造出一类严格满足数学条件的离散能谱,并证明其能重现三维 BTZ 黑洞的熵及高阶量子修正,AI 承担了反例构造、猜想推广与 Lean 形式化,人负责提出问题、修订猜想、审查结论。
结构还是周期,可检验的判断乐观者的理由并不弱,发现成本下降,整类过去因技术开销过大而无人问津的猜想将变得可及,数学研究的总盘子会像当年吸收计算机那样扩大。丘成桐“AI 提高数学研究层次”的判断,本质上也是这一立场。
现实也提供了支撑,约翰逊本人近月与 AI 协作并称赞其分析缜密;丘成桐实验室已产出七维同伦球面等 AI 辅助成果。新证词还在不断送来:谷歌 DeepMind 的 AlphaProof Nexus 登上《科学》,解决了 9 个厄多斯开放问题(其中两个悬置超过 50 年)和《整数数列在线百科全书》492 个开放猜想中的 44 个,与 OpenAI 形成鲜明对照的是,这批成果等了数月、走完了完整的同行评审,同期《科学》的评论文章标题就叫“AI 用于数学研究已经到来”;Anthropic 则报告 Claude 帮物理学家把散射振幅计算从八圈推进到九圈,布朗大学物理学家沃洛维奇评价,这在很大程度上建立了对前沿 AI 系统能够可靠完成困难计算的信任。
但扩张论回避了分配问题。
蛋糕做大时,回报未必流向提出问题的人。当给出答案的工具掌握在少数实验室手中,优先权、声望与专利便随之集中。传统学术实验室的年度算力预算与前沿实验室单个实验的支出相差数个量级,工具本身成为稀缺投入时,拥有工具的机构就在设定议程。这不是预测,而是已经发生的现实:菲尔兹奖得主流向产业,预印本平台被大量 AI 辅助证明涌入,数学家开始在论文里扣留开放猜想,担心想法尚未成熟就被模型抓走。
这个判断不需要靠信念维持。按本文设定的观察标准,它可以在未来 18 个月内被检验。观察三个指标即可:
其一,顶级数学期刊中经形式化验证的 AI 参与成果占比是否持续上升;
其二,顶尖博士与奖项得主流向产业实验室的速度是否超过常态;
其三,主要数学期刊是否把披露 AI 使用情况、提交机器可检验证明写入投稿规范。
还有一项更直接的观察指标:DeepMind这种“慢发布、走评审”的路径,是否被更多实验室效仿。同行评审的队列有多长,比任何宣言都更能说明问题。四项中两项成立,结构性转变即获确认;反之,若验证人力跟上了生成速度、制度完成吸收,则本次风波会被归档为一次剧烈的周期性扰动。
出路:从发布到提交这场冲突的解法其实并不玄奥,难点只在约束发布者自己。
对 AI 公司而言,核心动作是把“成果发布”改为“成果提交”。即让 AI 产出进入人类可验证、可教学的流程:先过形式化验证,再设一段供数学家消化的评审期,经确认后再传播。
DeepMind 刚刚在《科学》上演示了这条路走得通,慢几个月,换来的是无需争论的合法性。OpenAI 承诺资助研讨会与学术会议,是朝正确方向付的首付款。顾问小组则进一步要求企业为暑期学校、博士后席位与阐释性著作买单,并披露模型名、提示词、算力成本与失败的题目数;其同时提醒,接受此类资助不等于认可企业的做法。信任无法用预算直接购买,只能用可核查的流程逐笔积累。
对学术界而言,当务之急是给验证劳动定价。当瓶颈从发现转向理解,形式化验证、成果阐释、教育转化这些环节就是新的稀缺资源,应当获得经费、职位与署名权重,而不是像现在这样成为无报酬的影子工作。丘成桐数学与人工智能实验室联盟在事件后一周内成立,把 AI 辅助形式化证明列为重点方向,正是国内学界给出的组织化回应。
对青年学者而言,风险同样存在,研究数年的问题可能被模型在数小时内攻克,论文在答辩前就已过时。理性的应对不是放弃深度,而是把精力挪向机器暂不擅长的环节:提出新问题、判断哪些结果值得验证、把零散的成果组织成理论脉络。发现可以外包,品味与判断力暂时不能。
对期刊而言,窗口期正在收窄。率先建立 AI 使用披露与机器可检验证明标准者,将成为新规范的制定者;观望者则把影响力让给预印本平台。
AI 没有终结数学,但它终结了数学作为一场公平竞技的历史。
此后的学科将奖励那些验证速度快于发现速度的人。发现成本的坍塌不可逆转,理解与信任的重建却仍在人力范围内。用丘成桐的话说,要在大潮上冲浪,而不是躲开;产业界则需要明白,一次抢跑赢得的头条,远不如一套让所有人都能核查的流程值钱。
(本文首发钛媒体APP,作者 | 硅谷Tech-news,编辑 | 焦燕)
作者:硅谷Tech news