











28
36
5000人见过真AI,60亿人还没碰过
2026-10-14 21:51:15
0点赞
0收藏
0评论
上周 X 上出现了一张手绘的四层图。最底下一层写着 60 亿人,最顶上那层写着 5000 人,比登过珠峰的 7500 人还少。
画图的是个在特斯拉和 OpenAI 都干过的 AI 研究员,配文只有四个字:餐巾纸估算。顺手一算的意思,别拿去当统计口径。图被搬到知乎,冲到热榜第 4,写代码的那批人看完集体眩晕。
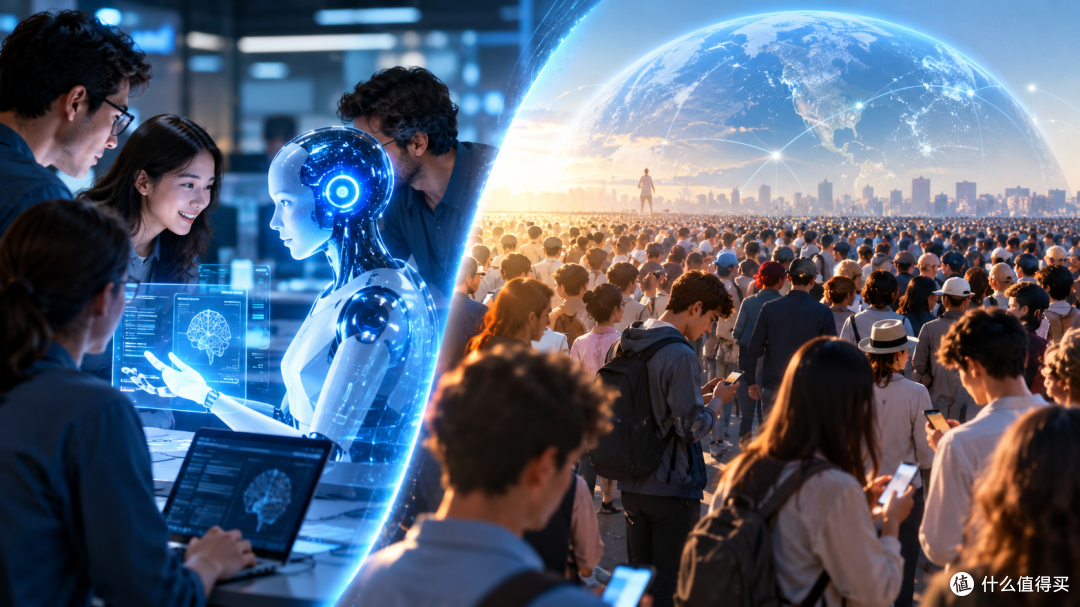
这张漏斗把 80 亿人切成了四层
最底下那层最大,也最沉默:约 60 亿人、占全球人口 75%,几乎没有接触过任何大语言模型,AI 对他们来说只活在新闻标题和科幻片里。
往上是第二层,约 10 亿到 20 亿人、占两成左右,免费版产品的偶尔使用者。这一层手里多半只有免费版,脑子里对 AI 的印象还停在去年,以及短视频里那些翻车片段——语音模式被问"我该开车还是走路去洗车",答得磕磕巴巴。视频是真的,只是里面的机器已经是一年前的了。
再往上,人数掉得很快。约 2000 万人、占全球人口 0.2%,主要是数学和编程领域的从业者,他们付费使用最前沿的智能体模型,把它接进真正的工作流。这位研究员用自己举例:不到一年前,他还在一个字一个字地敲命令、偶尔按 Tab 补全;现在原本要顶级工程师做几个月的项目,一个提示词就能交付,最高端的付费版还能自己静默跑一小时,把整套代码库重构完。
顶层那 5000 人、占全球人口 0.00006%,看到的东西完全不同:上千个智能体在内部系统里连着跑几周,自己找零日漏洞、自己往前推数学;而人类研究员还在上千页机器日志里翻找,722 篇 AI 写的数学手稿,顶尖数学家也要啃很久才啃得动。
最陡的那段斜坡,为什么偏偏长在代码和数学上
同一批模型,写文案时平平无奇,写代码时却能自己跑满一小时,差别不在模型"偏爱"哪个领域,而在奖励信号干不干净。
代码和数学的对错是硬的:跑得通就是跑得通,证明错了就是错了。这种可验证的反馈让强化学习有明确的靶子可打,能力才有机会被反复磨快;写一首诗、写一篇评论,好坏全靠主观判断,没有这条回路,进步就慢。有个说法总结得很准:你对 AI 的敬畏,跟你让它干的活有多难成正比。
还有一个变量是你手上压着多难的问题。你让 AI 写封邮件、查个菜谱,它连热身都算不上,你看到的就是它最散漫的那一面。研究员的话很直白:你得有一池自己真正在意、又反复解决不掉的难题,一个接一个丢进去。
还有一道大多数人迈不过去的坎,是权限:免费版、付费版、内部系统三道台阶彼此隔离,外部世界能拿到的,始终只是预览版。
两个最容易看错的地方
"我试过,AI 就这水平。"这话有它的道理,免费版和前几代旧模型确实会在简单问题上翻车,那些搞笑视频也是真的。但它解释不了一件事:视频里跑的多半是被废弃的旧模型,你测的是哪一层,你否定的就只有那一层。AI 的能力不是一条向上爬的直线,是几层彼此隔开的水位,免费版和内部系统之间差的不是几个版本,是几个量级。
至于"买更贵的会员就能往上走",付费只是一张门票,不是答案。真正把层级拉开的,是你手里有没有足够难、对错又足够清晰的问题。一个天天只让 AI 润色周报的人,买下最贵的套餐,也依然停在一二层之间。
真正有用的动作只有一个
别再用"洗车该开车还是走路"这种题给 AI 判死刑。挑一件你真在乎、又有明确对错的事——一段跑不通的脚本、一份要逐行核对的表格、一个你反复算错的指标——交给付费版,允许它跑上十几分钟,再看结果。
边界也得说清楚:这是"餐巾纸估算",比例不能当精确数据引用;如果你的日常里几乎没有对错清晰的环节,落差本来就会小一些,这不算落后,只代表你所在的领域还没长出可验证的奖励信号。
想知道自己在第几层,不用看会员等级。翻一下过去一周你交给 AI 的任务,有几个是它第一次没做对、你又逼着它做对的?这个数字比任何榜单都准。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~





