









 深耕数码、AI兴趣领域


9
16
NVIDIA下一代GPU偷偷缩水:内存、互连带宽双双锐减
2026-10-28 22:03:34
0点赞
0收藏
0评论
NVIDIA新一代Vera Rubin AI计算平台已在今年年中投入大规模量产,并在今年秋季批量供货。
不过根据芯硬件从NVIDIA官网上观察到的最新规格参数,该平台悄无声息地出现了一些缩水,主要是HBM4内存带宽和第六代NVLink总线带宽都降低了,部分平台的容量和算力也砍了一刀,但与此同时,横向扩展(scale-out)网络带宽却有所提升。
对比网页历史快照发现,这些变更早在9月上旬就有了,但是NVIDIA官方从未公开发声。
根据最初公布的规格,每颗Rubin GPU搭配288GB HBM4高带宽内存,带宽22TB/s,而今容量不变,带宽却降至19.2TB/s,缩水了12.7%。
同时,负责沟通Vera CPU、Rubin GPU的第六代NVLink互连总线,单路带宽也从3.6TB/s降至3TB/s,缩水幅度16.7%。
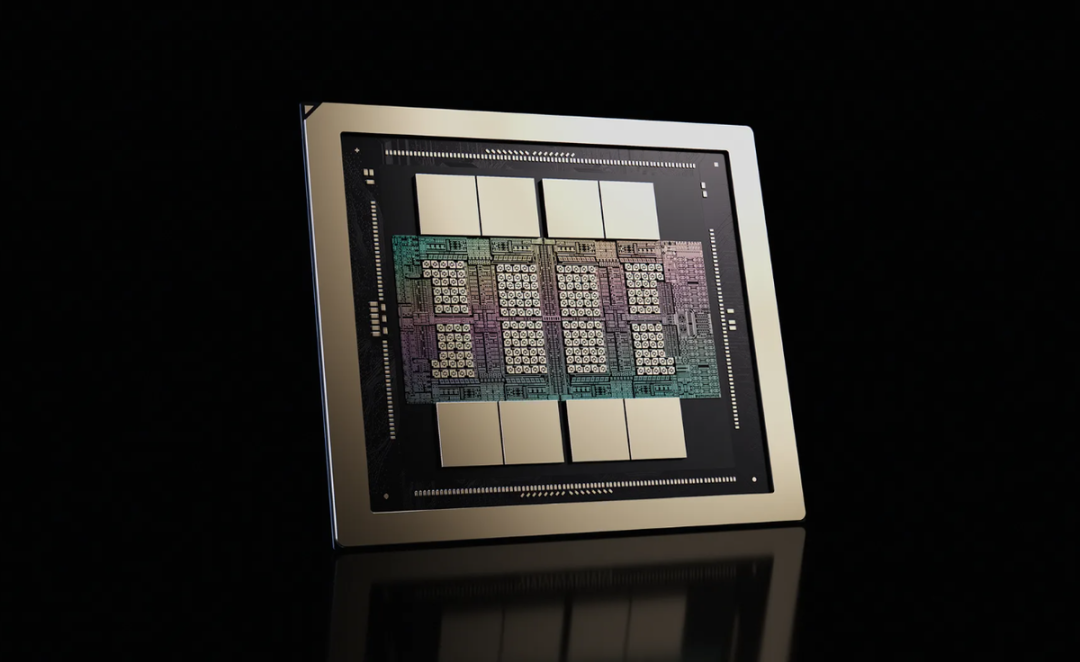 Rubin GPU
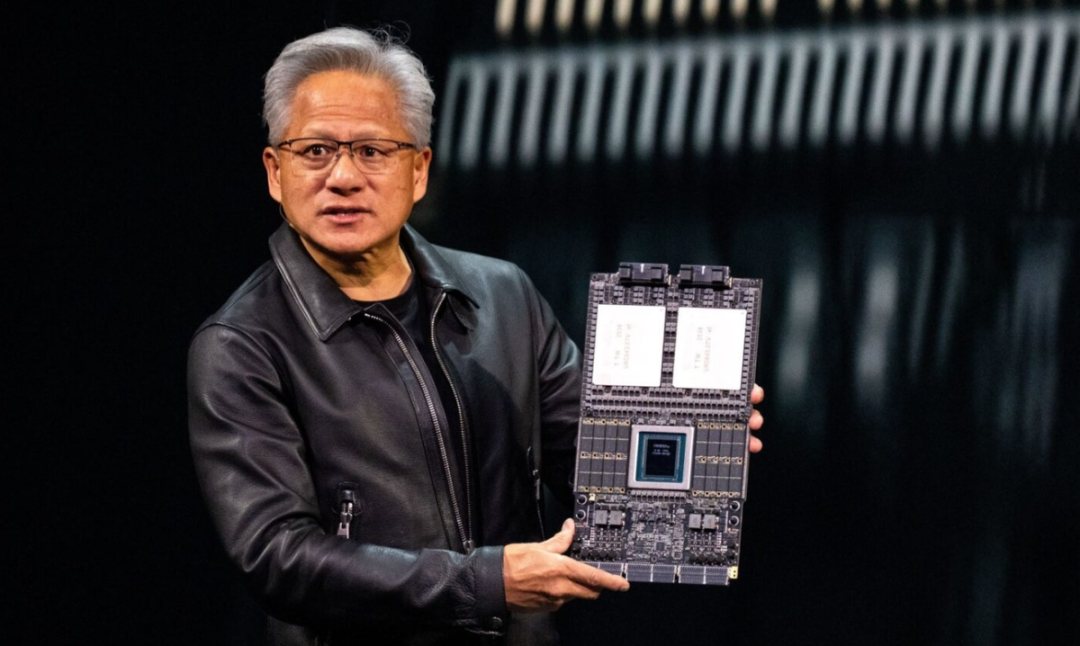 Vera Rubin SuperChip
底层芯片的变动,自然会影响所有基于此的AI系统。
比如一颗CPU、两个GPU组成的Vera Rubin Superchip超级芯片,576GB HBM4的带宽相应从44TB/s降至38.5TB/s。
比如两颗CPU、四颗GPU组成的Vera Rubin NVL4计算节点,1.1TB HBM4的带宽相应从88TB/s降至77TB/s。
比如36颗CPU、72颗GPU组成的Vera Rubin NVL72机柜级系统,20.7TB HBM4的带宽相应从1580TB/s降至1400TB/s。
另外,8颗Rubin GPU搭配Intel至强CPU组成的HGX Rubin NVL8服务器平台,受影响是最大的,不但HBM4带宽从176TB/s骤降至130TB/s,缩水幅度达26.1%,内存容量也从2.3TB减少到2TB(幅度13.0%)!
分析认为,这里容量的变化主要来自HBM4配置的调整。
NVIDIA最初为HGX Rubin NVL8平台规划的HBM4同样是12-Hi堆叠,单颗容量更大,后来改为更小容量的8-Hi堆叠方案,因为它虽然容量更小,但更加成熟。
至于为何单独调整它,可能是尽量减少对整体的影响。
这些不同级别的系统,NVLink带宽都是同样的缩水幅度,比如Vera Rubin SuperChip 6TB/s,Vera Rubin NVL72 216TB/s。
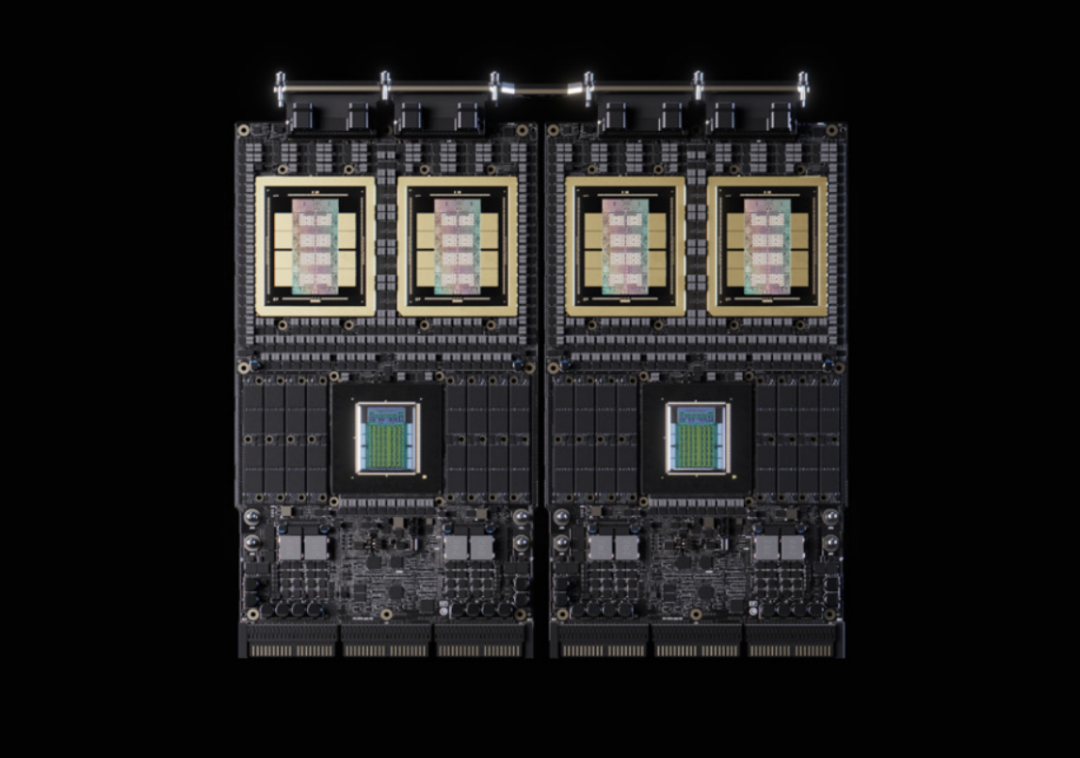 Vera Rubin NVL4
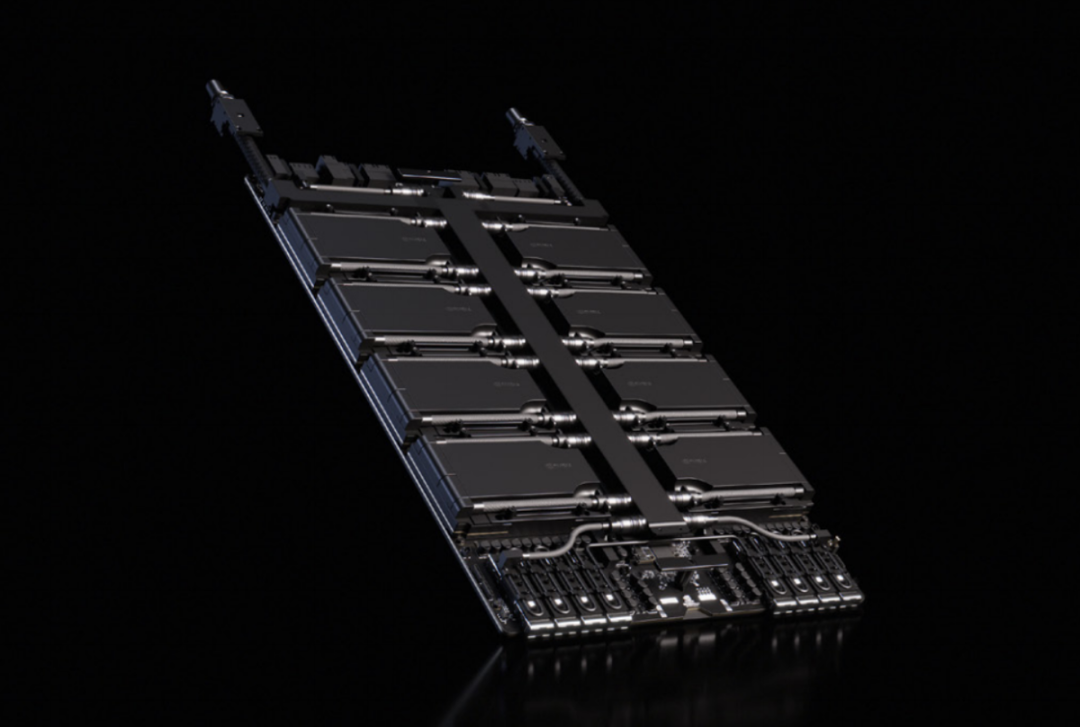 HGX Rubin NVL8
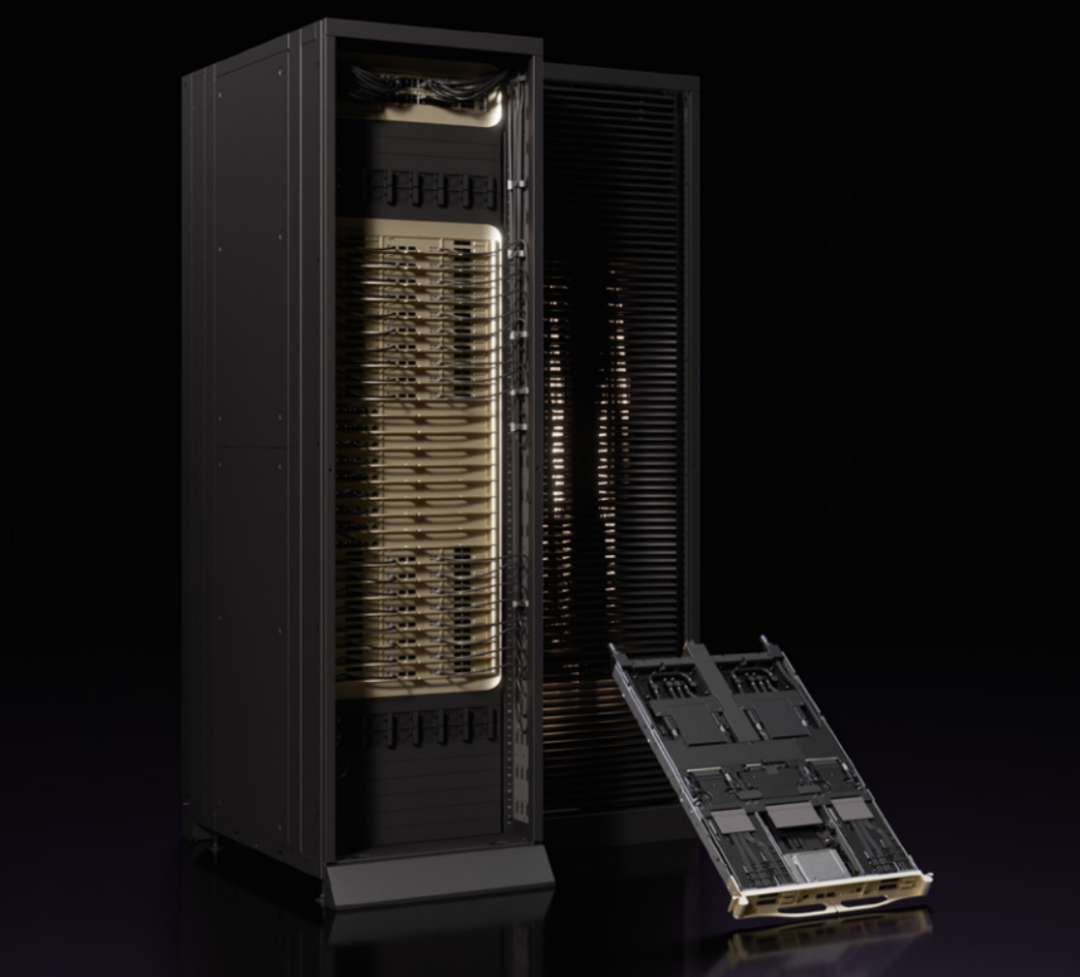 Vera Rubin NVL72
不过也有好消息,一是GPU计算能力普遍没有任何变动。
唯一例外的就是HGX Rubin NVL8,受到HBM4容量减少的影响,NVFP4精度训练算力从280PFLOPS降至270PFLOPS(幅度3.6%),FP8/FP6精度训练算力从140PFLOPS降至130PFLOPS(幅度7.1%)。
二是从超级芯片到服务器平台到机柜级系统,横向扩展网络带宽全部提升了12.5%。
比如Vera Rubin的网络带宽从0.8TB/s提升至0.9TB/s,HGX Rubin NVL8的网络带宽从1.6TB/s提升至1.8TB/s,Vera Rubin NVL72的网络带宽从28.8TB/s提升至32.4TB/s。
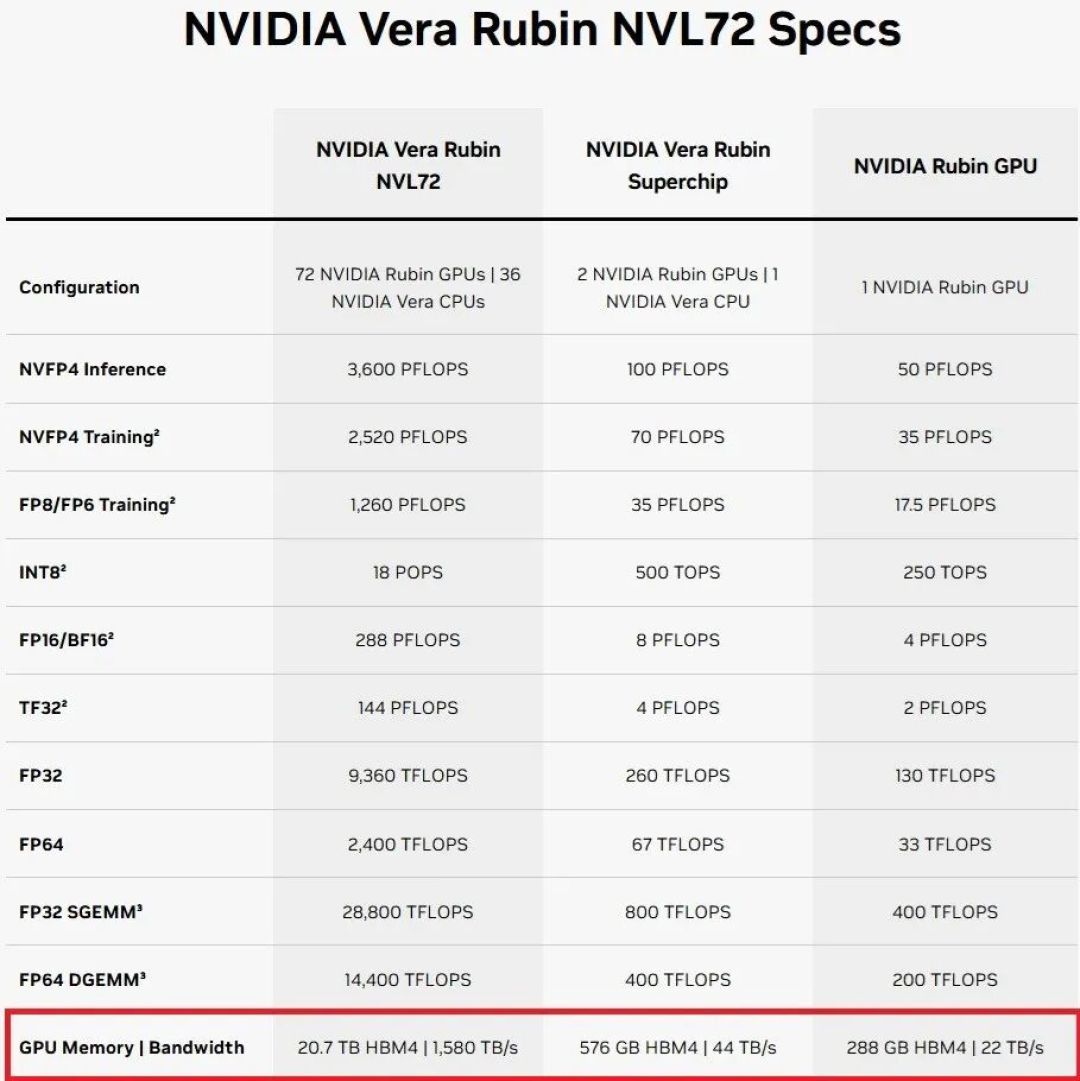 旧版规格
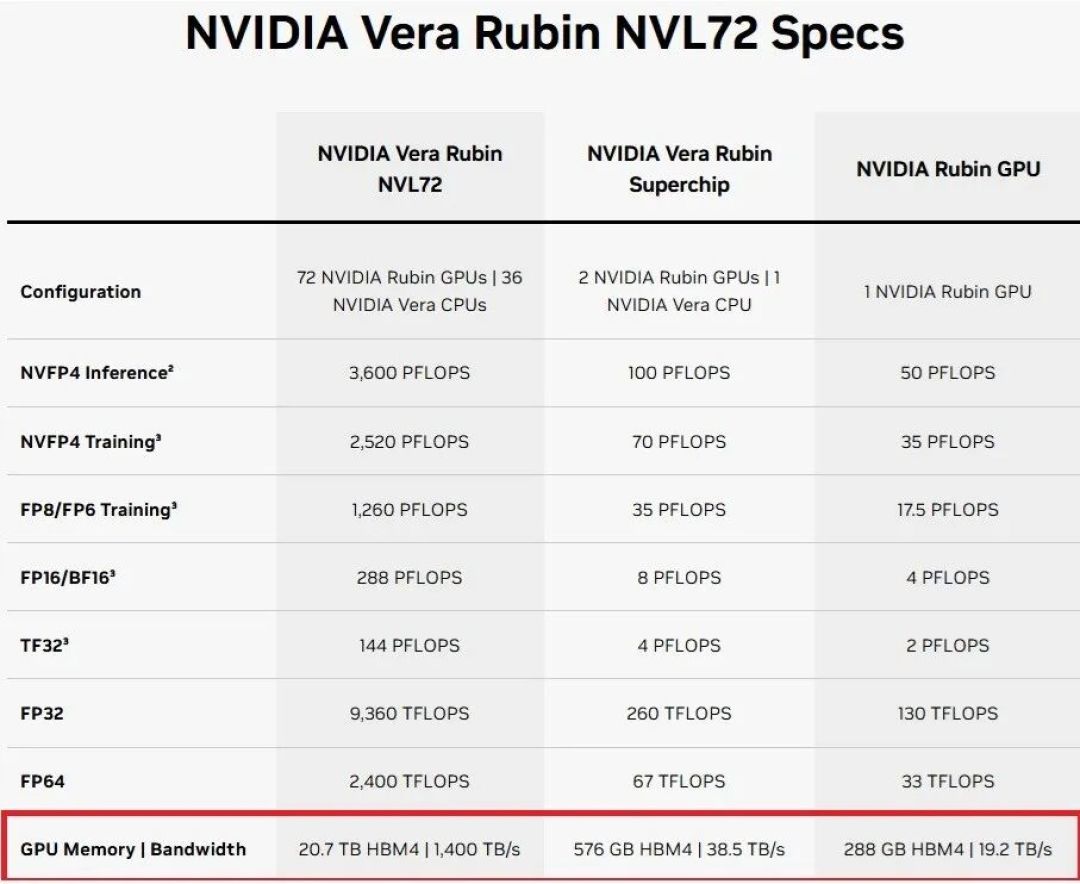 新版规格
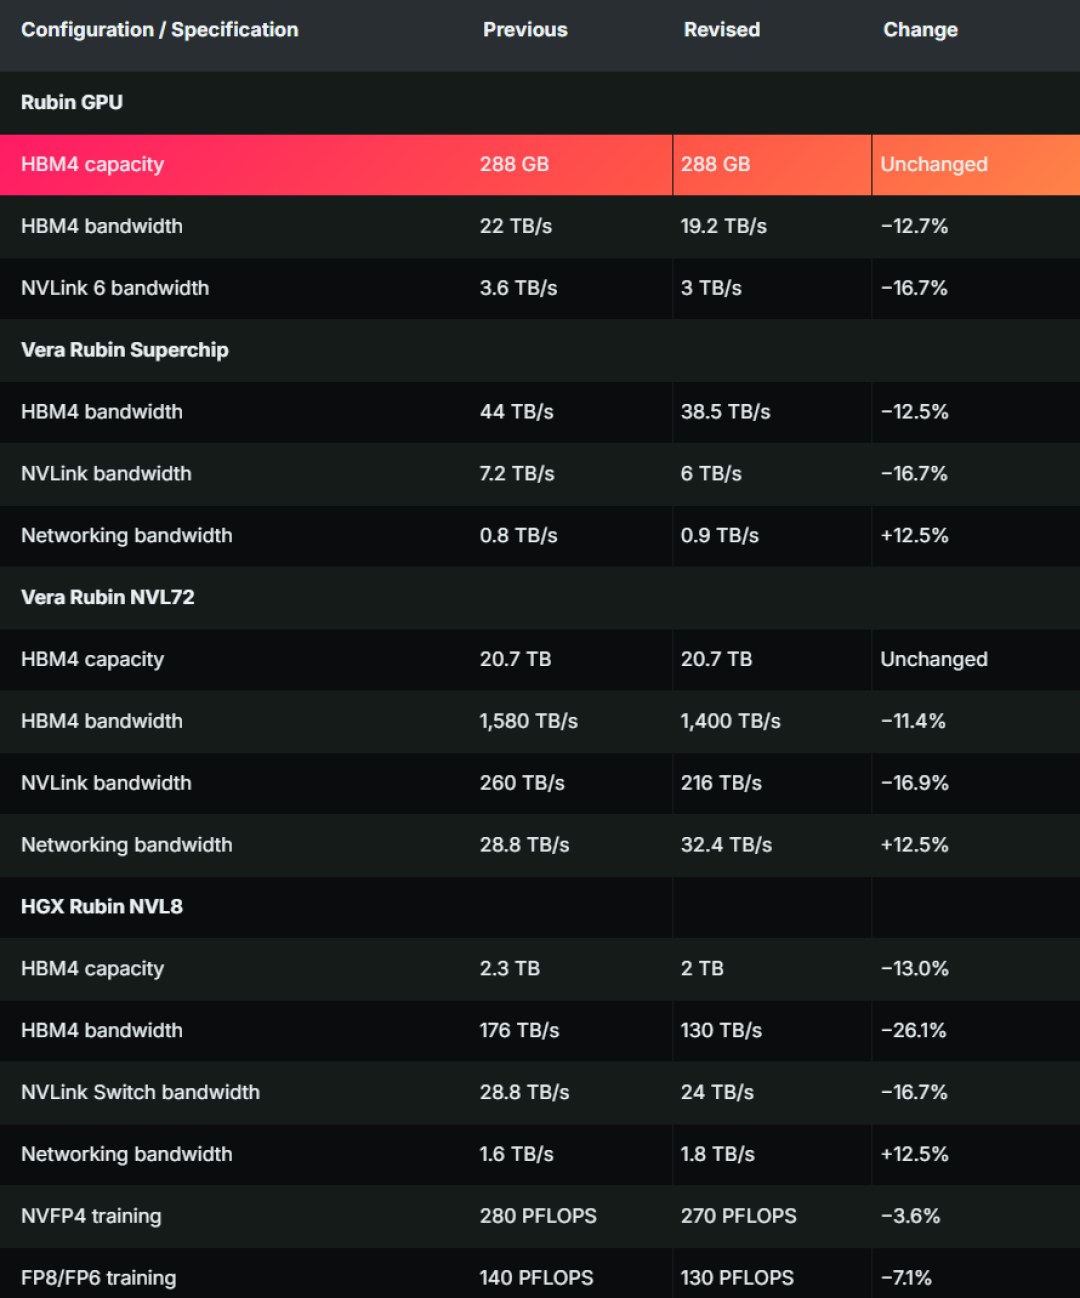 各个级别的规格变化对比汇总
NVIDIA没有解释这些变化的原因,但在芯硬件看来,都不难理解。
HBM4带宽方面,此前就有行业报告指出,各家供应的HBM4内存很难完全满足NVIDIA最初制定的带宽指标要求,面临极大的良率和产能压力。
NVIDIA主动放宽要求,自然有利于更充足的HBM4内存获得认证,从而满足量产需求,同时对性能的影响在可接受范围内,毕竟GPU芯片本身的算力基本没有缩水。
NVLink带宽的降低核心原因,倒不是单纯的成本或良率考量,而在于物理层的信号完整性问题,为此Nyquist频率从最初设计的56GHz降至47GHz。
Nyquist频率是信号采样的关键参数,降低它意味着对SerDes(串行器/解串器)、线缆、连接器材料的电气性能要求大幅降低,从而显著改善产品良率和系统稳定性,属于牺牲少量峰值带宽来换取更高可靠性和可制造性的权衡。
横向扩展网络带宽的提升,则是为了弥补机架内带宽的损失,提升大规模AI集群的通信效率。
总之,NVIDIA的这次规格调整是一套组合策略:
通过放宽HBM4和NVLink的带宽规格要求,优先保障芯片的制造良率、供应量、系统稳定性,同时通过提升横向扩展网络带宽,补偿机架内互联性能的损失,最终目标是确保Vera Rubin平台能够按时大规模、稳定地交付,并在整体系统性能上达到新的平衡。
尽管有所牺牲,Vera Rubin平台的各方面素质依然是上代Grace Blackwell的数倍之多,比如NVFP4推理性能5倍(每秒36亿亿次)、NVFP4训练性能3.5倍(每秒25.2亿亿次)、HBM4容量1.5倍、LPDDR5X内存容量2.5倍、scale-up纵向扩展网络带宽2倍。
根据修订后的规格,HBM4带宽依然是上代的2.5倍左右。
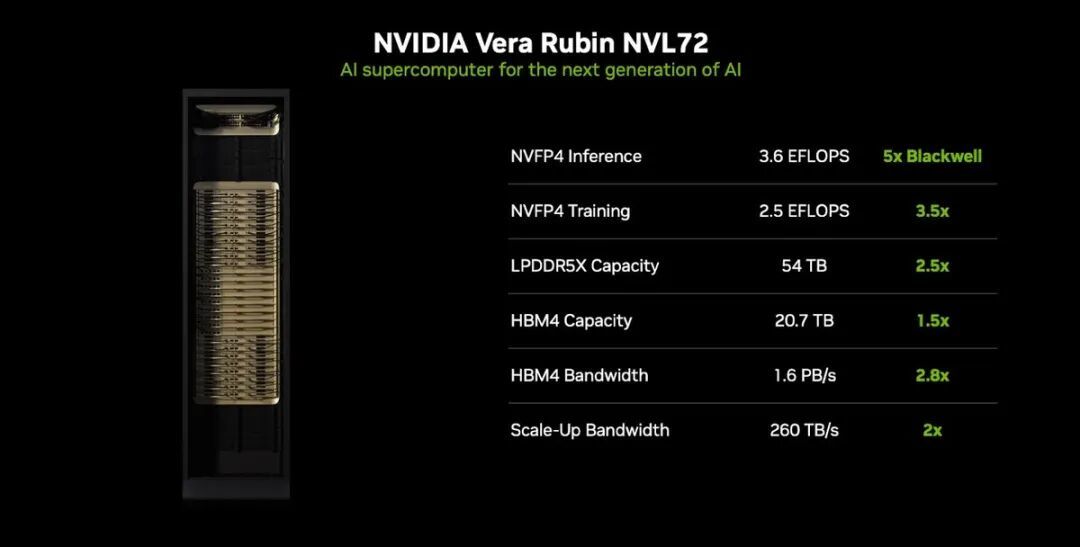
Vera Rubin的终极形态,自然是庞大的“AI工厂”,耗电功率可以达到100兆瓦级别。
它拥有大约4万颗Rubin GPU,搭配12PB HBM4内存和800PB/s带宽,以及最多30PB LPDDR5X内存、42PB NVMe SSD存储。
整个工厂的算力是异常惊人的,NVFP4训练、推理分别可达恐怖的1.4ZFLOPS(14万亿亿次)、2ZFLOPS(20万亿亿次)。
另外,FP8/FP6训练算力700EFLOPS(每秒7万亿亿次),FP16/BF16算力160EFLOPS(每秒1.6万亿亿次)、TF32算力80EFLOPS(每秒0.8万亿亿次)。
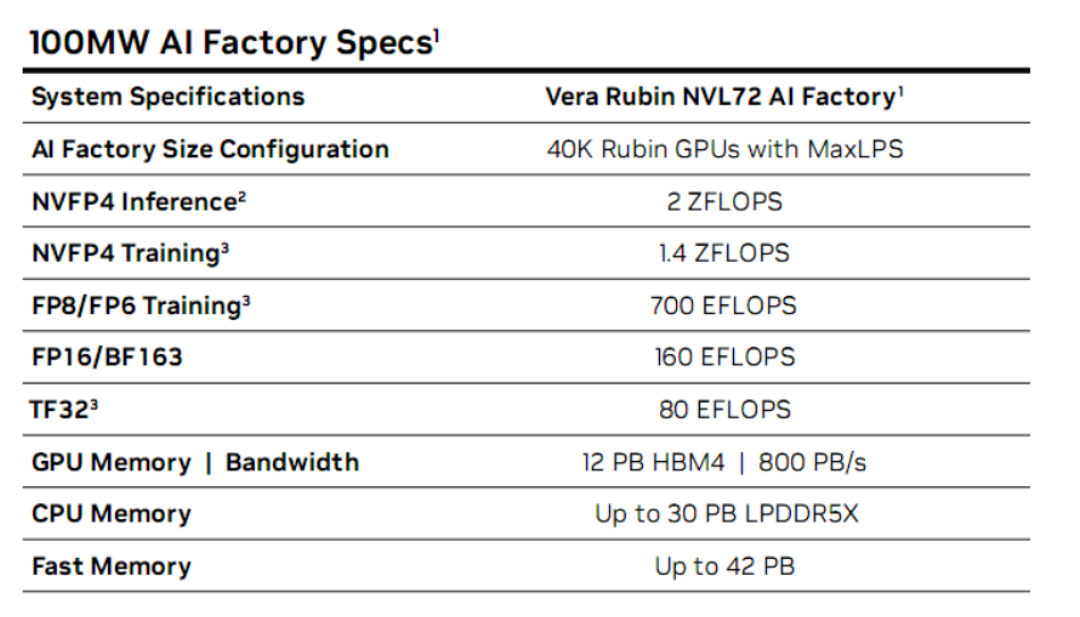 Vera Rubin NVL72 AI工厂规格
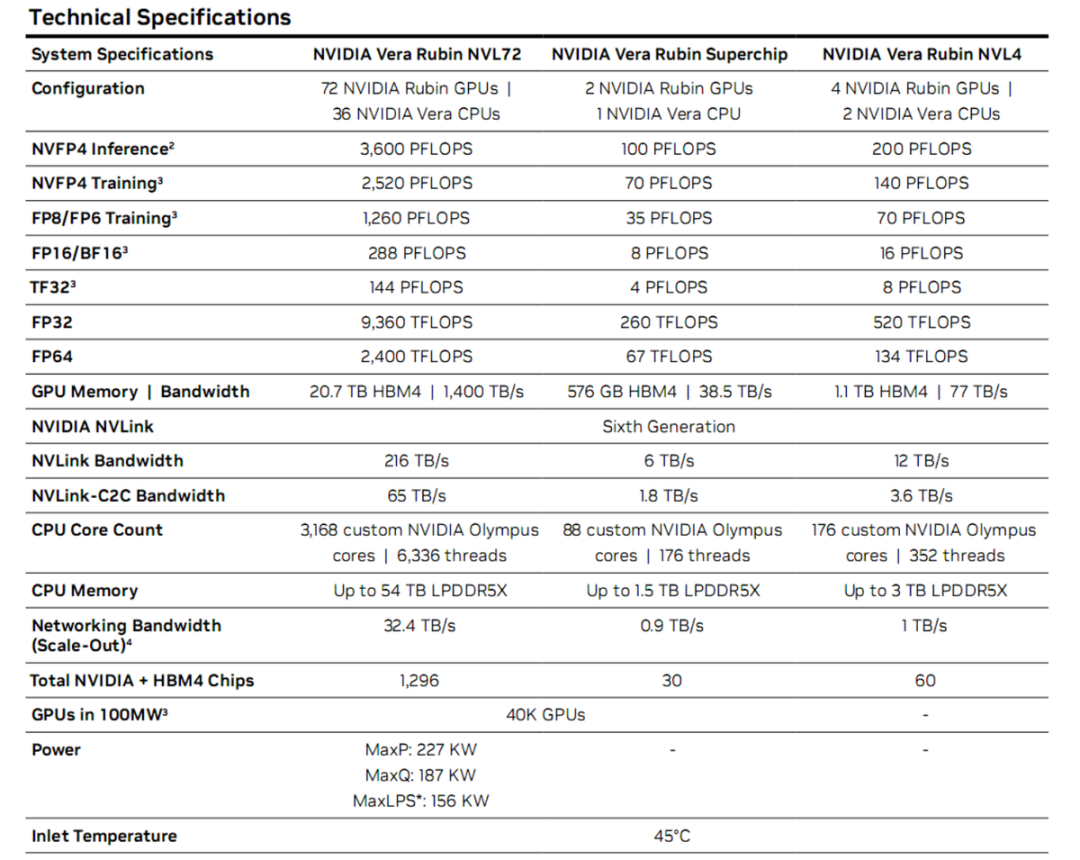 Vera Rubin NVL72/NVL4/SuperChip详细规格