











8
5
飞牛相册 AI 硬件加速实测报告
2026-09-13 20:04:25
0点赞
3收藏
2评论
飞牛相册 AI 硬件加速实测报告
自测为主,社区信息为辅。数据截至 2026-09-15:Intel 四代 A/B/C 实测已齐,AMD 侧待补基准(4.5 只有 GPU 被调用的证据,无速率与内存读数)。
测速流程与判定口径从略;本文只记结论与实测数据。
一、飞牛相册AI模块
相册 AI 是一组常驻本机、全部本地推理、不联外网的服务(表中前六行跑模型,后三行排查 GPU 调用时一起看):
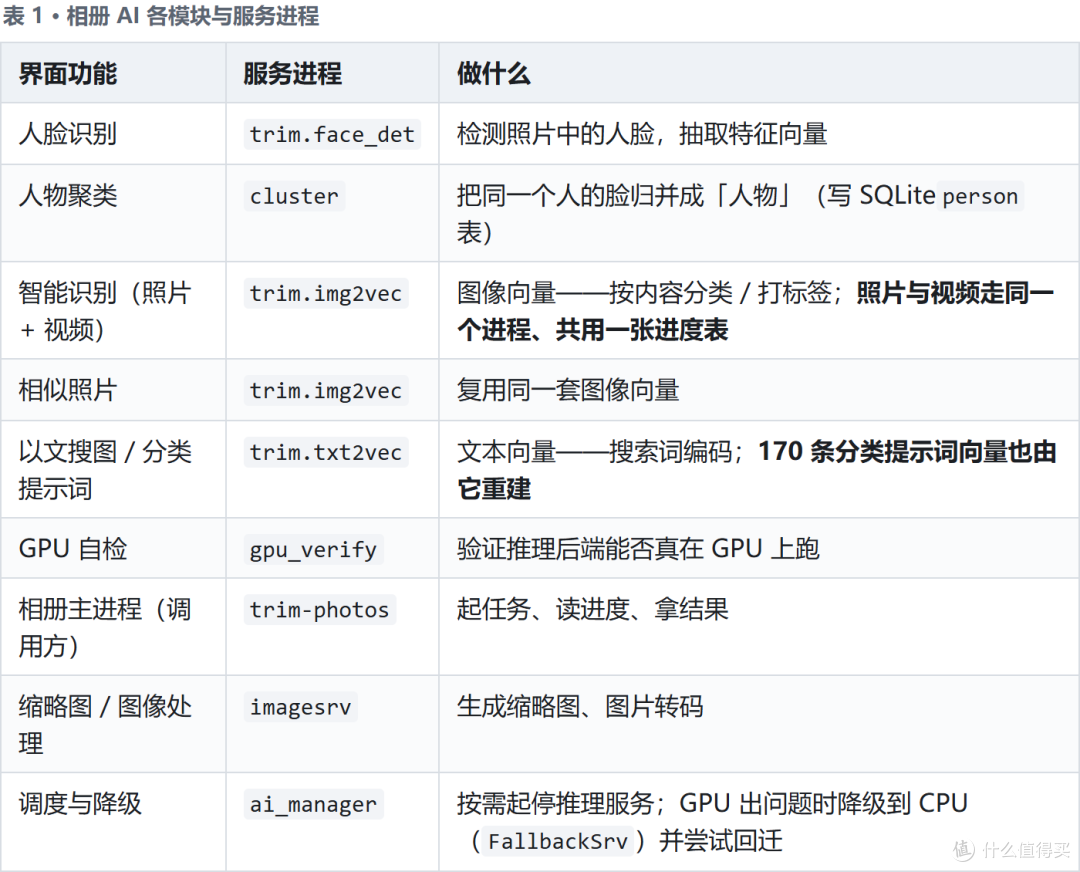
推理链路按平台分:Intel → OpenVINO、AMD → ROCm + MIGraphX,硬件门槛不同。
二、实测机器配置与可用性
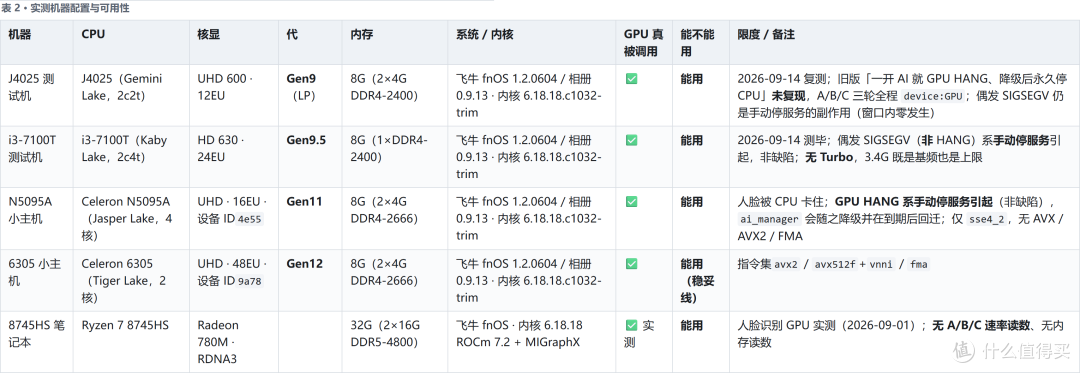
代次只能按 SKU 判,别拿 dmesg 那行 version 当代次——它报的是 display version(J4025 为 10.00、i3-7100T 为 9.00);i915 把三个版本分开报,同一台 J4025 的 i915_capabilities 实测 graphics version: 9 / media version: 9,AI 走的是渲染/计算引擎,OpenVINO 自报 GPU_UARCH_VERSION = 9.4.0(见 4.1);6305 自报 arch=v12.0.0(见 4.4),同代内部的 12.x 细分不按 SKU 猜。同代 SKU:Gen9 = J4025 / J4125 / J5005;Gen9.5 = i3-7100T / i3-8100 / i5-8400;Gen11 = N5095A / N5105 / N6005;Gen12 = 6305 / N100 / N150 / i3-N305。
发布年份也不代表架构:J4025 / J4125 属 Gemini Lake Refresh(2019-11 发布),比 i3-7100T(2017-01)/ i3-8100(2017-10)晚两年多,但核显仍是 Gen9 LP 的 UHD 600 / 605,Refresh 只提了频率——核心还是 14nm Goldmont Plus,无超线程。
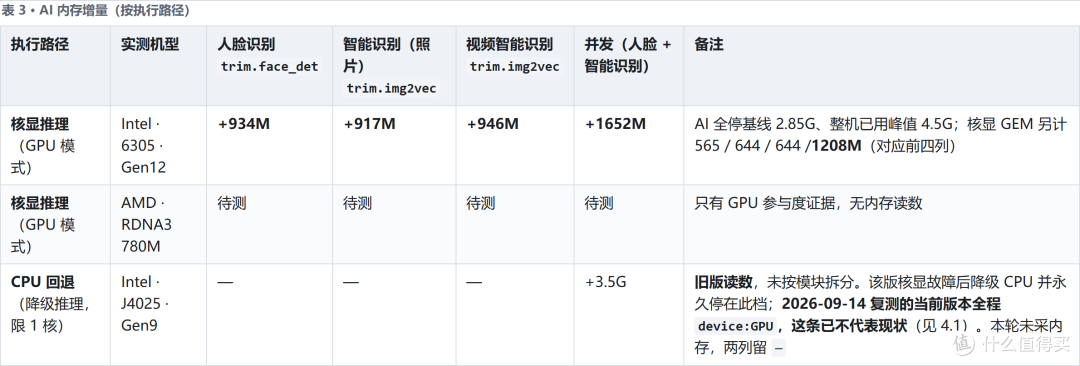
注 1:AI 内存增量按执行路径分记
注 2:素材同一批(1398 张 = jpeg 1331 + mp4 67),四台一致,fingerprint 各轮前后自洽。前三轮(6305 / i3-7100T / N5095A)经千兆 SMB挂载,J4025 轮改挂 6305 的 fnOS 共享(CIFS)——均非被测机本地盘。
三、实测性能总表(A/B/C 各 120 秒)
同素材、同规程,单跑 120 秒。
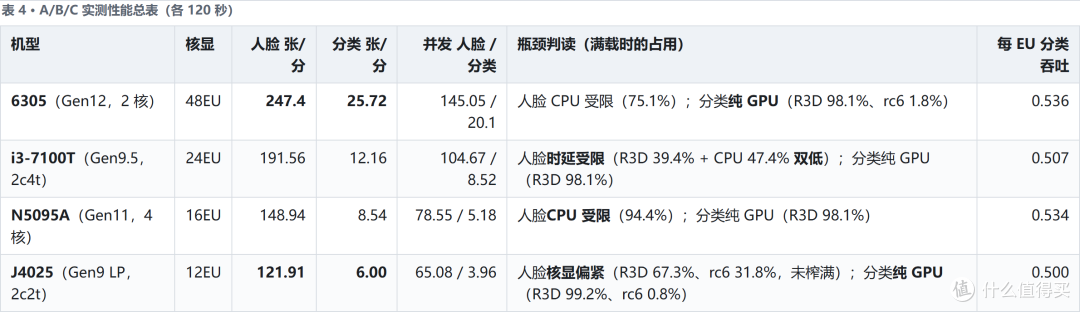
每 EU 分类吞吐四台重合(分类是纯 GPU 任务,故是唯一可跨机的相对指标):0.507 / 0.534 / 0.536 / 0.500,离散度 ±3.6%——img2vec 在这四代上是同一套执行效率,跨代差异全部来自 EU 规模。该式把 EU 数当规格比、不乘频率,应读作经验拟合而非架构结论。
并发衰减(单跑 → 并发)
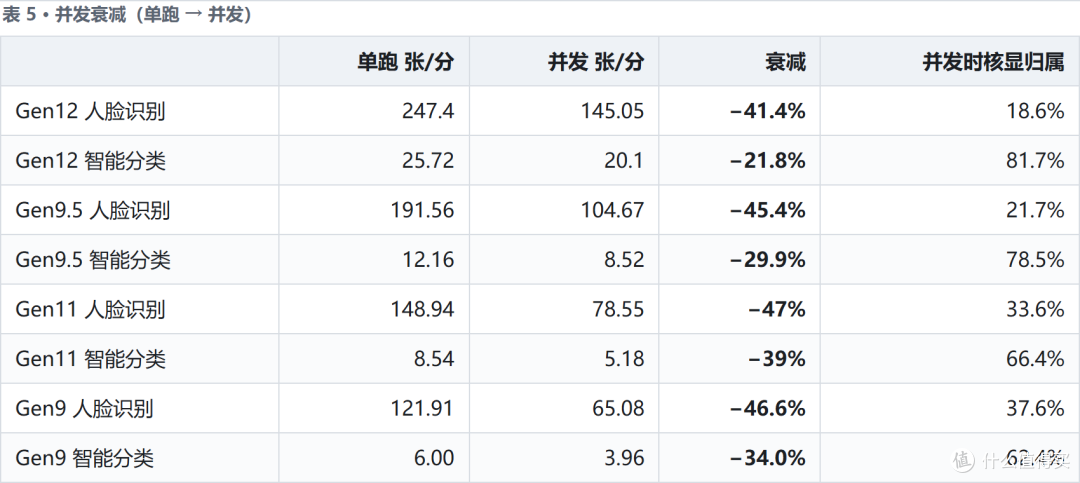
并发是分摊,不是过载:四代核显并发时都被榨满(客户端合计 97.9%–100.2%),两个服务按比例切时间——人脸都在 −41% ~ −47%、分类都在 −22% ~ −39%,十二轮零 HANG。
换机收益不均衡:Gen11 → Gen12 人脸单跑 1.66×(并发 1.85×)、分类单跑 3.01×(并发 3.88×);Gen9 → Gen9.5 人脸 1.57×(并发 1.61×)、分类 2.03×(并发 2.15×)。两档换机指向同一件事:分类是纯 GPU 瓶颈,换核显直接兑现(涨幅≈EU 比);人脸压不满核显,换 CPU / 核显收益都有限。
四、逐台实测详情
4.1 J4025(Gen9 LP)——能用(2026-09-14 复测,推翻旧版结论)
取证:2026-09-14 · 相册 0.9.13 / 系统 1.2.0604 · 内核 6.18.18.c1032-trim
旧版结论作废:旧版记录的是核显故障后飞牛降级 device:CPU 并限 1 核、永久停在 CPU,从未跑过 A/B/C:

该轮相册与系统版本都没记下来,是这台机器最大的证据缺口。当前版本上这套故障一次都没复现——三轮 A/B/C 的 device / device_end 全为 GPU,窗口内 hang=0 rcs0=0 fallback=0 recover=0,clients 每帧可见服务名与 PID。
性能数据(120 秒窗口)
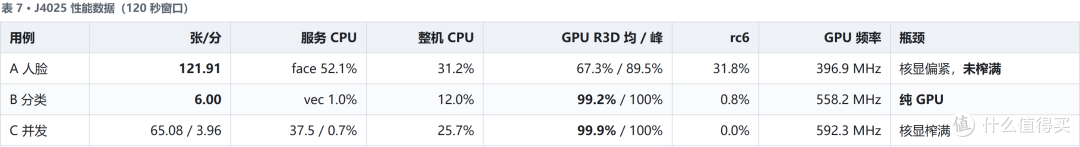
clients 归属:A → face_det 67.0%(60/60 帧);B → img2vec 97.4%(60/60 帧);C → img2vec 61.4% + face_det 37.0%。GPU 频率均值 396.9 / 558.2 / 592.3 MHz,A、B 轮峰值 526.9 / 614.1 MHz。
核显规格取证——用相册自带的 OpenVINO 直接问它实际在跑什么(2026-09-14 实测,ov.Core().get_property("GPU", ...)):
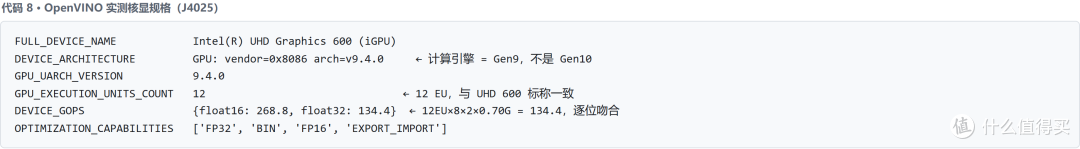
clinfo 一致:Max compute units = 12、OpenCL 3.0 NEO、驱动 24.35.30872.36。dmesg 的 display version 10.00(显示引擎)与这里的 arch=v9.4.0(计算引擎)不是一回事。
与 i3-7100T 横比(同素材、同相册版本,同为 2 核档)
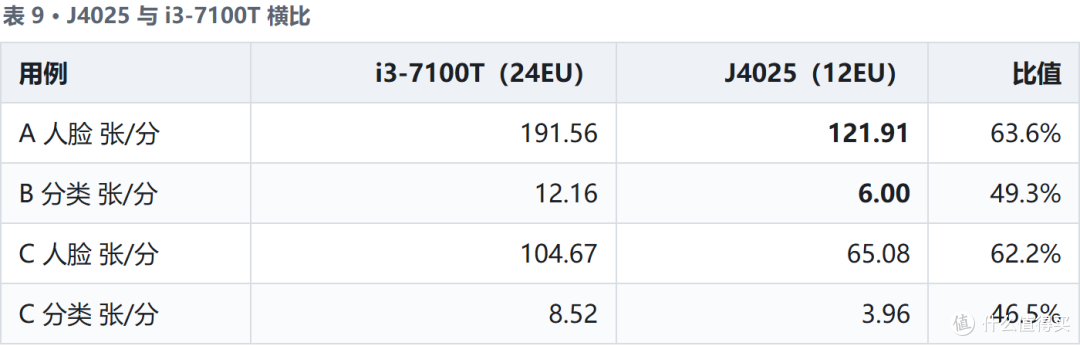
分类 49.3% ≈ EU 数之比 12/24 = 50%,又一处「分类速度近似线性于 EU 规模」的证据;人脸 63.6% 明显高于 EU 比,因为人脸本就压不满核显(A 轮 rc6 仍空 31.8%)。
发现的问题:
NPU 插件地雷本机复现,但不在推理路径上:本机 CPU 只有 sse4_1 / sse4_2、无 AVX(Goldmont Plus),ov.Core() 构造正常,但 available_devices 触发设备枚举时直接 SIGILL(rc=132);把相册内置的 libopenvino_intel_npu_plugin.so 改名后立刻恢复 ['CPU','GPU'],因果坐实(OpenVINO 2024.4 已知 BUG,官方已收录未修,见第六节)。推理路径不受影响——face_det / img2vec / txt2vec 三个二进制不含 available_devices / NPU 字样,A/B/C 十二个窗口内从未触发。
旧版「GPU HANG + ProgramBuilder build failed」的真因仍未坐实:旧版日志是 OpenCL / i915 侧签名(clWaitForEvents -14),与 NPU 的 illegal instruction 不是一回事(旧版日志里没有该签名)。本次复测这两个签名一次没出现,故旧版「i915 对 Gemini Lake compute 支持有缺陷」的归因只能标记为「旧版本、版本号未记录」,不能当作已验证的结论。
dmesg 那行 version 10.00 是显示引擎版本,不是显卡代次(Found geminilake (device ID 3185) integrated display version 10.00)——i915_capabilities 实测 graphics version: 9 / media version: 9,AI 走计算引擎(OpenVINO 自报 arch=v9.4.0)。J4025 不是 Gen10 显卡,按 SKU 是 Gen9 LP,与 12EU 的 UHD 600 对得上。GuC glk_guc_70.1.1.bin 已加载、HuC authenticated for all workloads。
内存带宽对本机有利:本机双通道,i3-7100T 是单条单通道(见 4.2)——核显推理吃带宽,横比时记住这一条。
实操:1398 张只跑智能分类约 3.9 小时(i3-7100T 约 1.9 小时);并发跑两者时人脸腰斩(−46.6%)。
4.2 i3-7100T(Gen9.5)——能用
取证:2026-09-14 · 相册 0.9.13 / 系统 1.2.0604
三轮 A/B/C 全部落在 device: GPU;clients 归属确认 face_det 61/61 帧、img2vec 64/64 帧、并发 img2vec 78.5% + face_det 21.7%;七项稳定性计数器增量全 0,fingerprint 三轮前后一致。
性能数据(120 秒窗口)
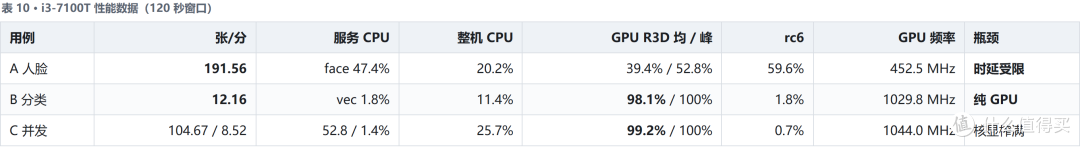
分类每 EU 吞吐 0.507;智能分类满载时 GPU 频率到过 ~1052 MHz(均值 1029.8)。
发现的问题:
口径:内核那行 device ID 5912 ... version 9.00 报的同样是 display version(本机显示引擎 9、J4025 是 10),不是显卡代次;本机渲染/计算引擎按 SKU 是 Gen9.5,理由见 4.1,别拿这行跨机比代次。无 Turbo——cpuinfo_max_freq = base_frequency = 3400000 kHz,3.4G 既是基频也是上限。本机是 8G 单条单通道(另三台双通道),绝对值别跨机横比。
4.3 N5095A(Gen11)——能用
取证:2026-09-13 · 相册 0.9.13 / 系统 1.2.0604
intel_gpu_top -J 确认 img2vec RCS 88%–105%、face_det 8.5%–53%、txt2vec 56 秒内完成约 80 次推理,三个服务均上核显。
性能数据(120 秒窗口)
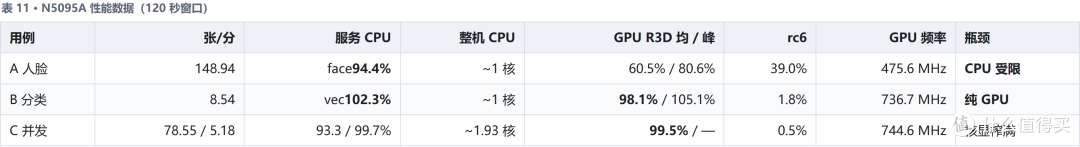
分类每 EU 吞吐 0.534。
发现的问题:
GPU HANG 与降级回迁都是手动停服务的副作用,不是本机缺陷——A/B/C 测量窗口内零发生。日志签名与「为什么会来回」见第六节。
4.4 6305(Gen12)——能用
取证:2026-09-13 · 相册 0.9.13 / 系统 1.2.0604
两模块 clients 归属确认:A → face_det 23.6%,B → img2vec 97.2%,C → img2vec 81.7% + face_det 18.6%。
性能数据 · A/B/C(统一素材包,120 秒窗口)
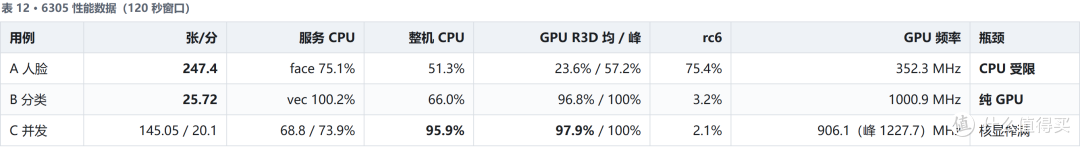
分类每 EU 吞吐 0.536。
真实库资源占用(2026-09-14,非 A/B/C 素材包——真实照片库,张/分不可与上表横比)
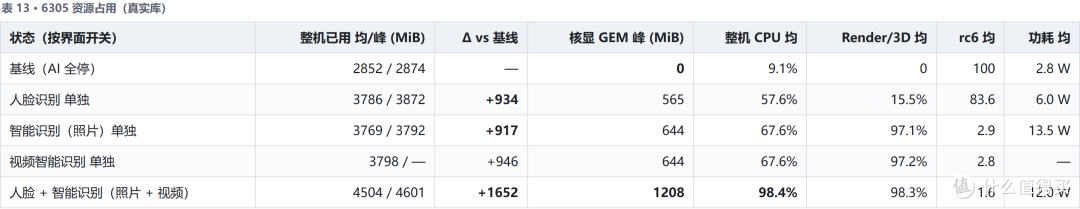
「已用」= MemTotal − MemAvailable(摘掉可回收缓存的标准口径);「核显 GEM」= /sys/kernel/debug/dri/0/i915_gem_objects 首行字节数,是本机 Intel 核显唯一的显存口径(无独立显存)。
发现的问题:
2 核是硬上限:并发时整机 CPU 95.9%,真实库场景 98.4%(2C/2T 打满)。并发跑人脸 + 智能识别,是拿人脸的产能去换智能识别的——真实库实测人脸腰斩(91.5 → 41.2 张/分,−55%),而 GPU 受限的 img2vec 几乎不掉(25.6 → 23,−10%)。
4.5 8745HS(RDNA3 780M)——AMD 实测可用
取证:2026-09-01 · 系统资源管理器 GPU 页 + rocm-smi --showuse。
ROCm 7.2 + MIGraphX,人脸识别 GPU 参与确认:GPU 22%、Compute 22%、65°C。无张/分数据,速率待补——这台只证明了「AMD 侧能真的调用 GPU」,没给速度。
五、机制背景与社区对照(辅助)
5.1 Intel 侧:降级机制与版本背景
无 GPU 加速时飞牛降级 CPU 推理并限 1 核。OpenVINO 的 CPU 推理按代次分级(Xeon = AVX-512、Core = AVX2、Atom = SSE),老 Atom 系最慢。版本背景:人脸识别模型 V1.0.1 起官方支持 Intel GPU(随相册 v0.8.50 / fnOS v0.9.18 生效),与 6305 实测(face_det CPU + GPU 并行)吻合;旧版「img2vec SIGSEGV 自杀」的修复版本见第六节。
5.2 AMD:能激活 ≠ 会调用(卡在 rocBLAS 内核)
「能激活」≠「会调用」——AMD 侧最容易踩的坑,分两层:
设备枚举层:装 ROCm 后 rocminfo 能列出核显 → 相册 AI 设置页开关点亮、显示「已启用」(v1.1.29 优化了启用重试与 GPU 型号显示,开关更容易点亮)。
推理执行层:rocBLAS 缺该 arch 内核 → MIGraphXExecutionProvider 加载失败 → ONNX Runtime provider 只剩 ['CPUExecutionProvider'] → 进程带着 --model_format MIGRAPHX --device GPU 启动却静默回落 CPU,rocm-smi --showuse 恒为 0%。
门槛在上游:官方宣传的「GCN5→RDNA4 全覆盖」指的是驱动层的识别与转码兼容,不等于 AI 推理后端有对应 kernel。ROCm 7.2 的 rocBLAS 自带内核只有这些架构:

限定:该列表来自社区排查 gfx90c 问题时的记录,不是官方权威清单——飞牛的 MIGraphX 是否自带某些 arch 的 kernel 只有实测能确认;已知反例 780M(gfx1103)不在列表内却实测可用。可确定的是上游态度:Vega 在 ROCm 6.x 之后已被 AMD 官方放弃,gfx902 / gfx909 从未进过官方支持列表。
社区实测与列表对照:
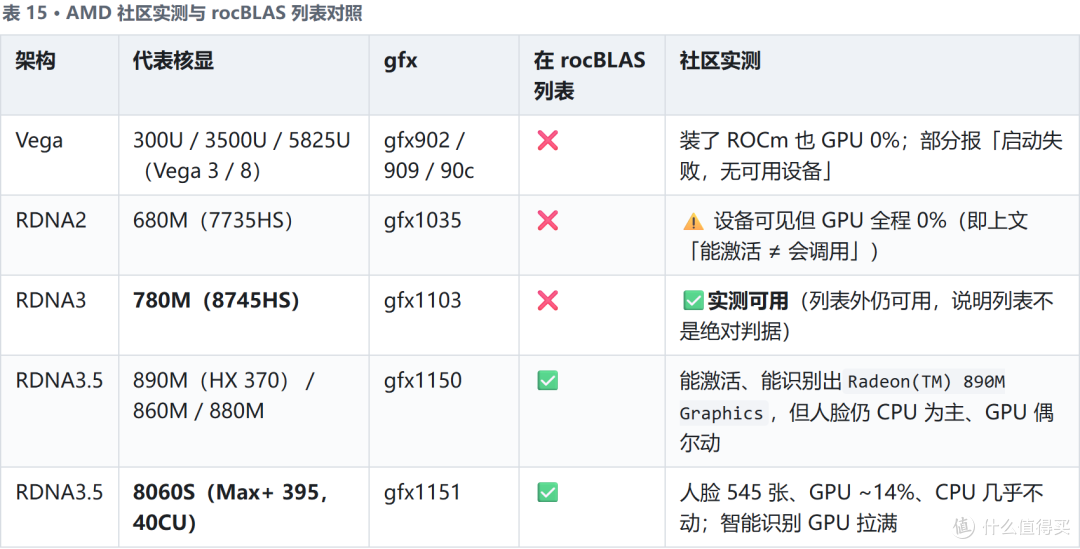
读法:可支持面是 RDNA3 及以上、且核显规模足够——同为列表内,40CU 的 8060S 实测优秀,16CU 的 890M 却调度不充分,进了列表只保证「能跑」,不保证「跑得快」。
飞牛社区《fnOS 系统支持显卡范围验证表》口径一致:相册 AI 支持以 RDNA2–RDNA4 为主;影视解码支持 GCN5 / Vega / RDNA1–RDNA4 及上述 APU——即 Vega 系在「影视」列、不在「相册 AI」列。
结论:列表用于预判,实测 GPU 占用才是终判。
前置条件:fnOS v1.1.29(2026-04-16)起支持 AMD GPU 做相册人脸识别与智能识别,需先在应用中心(不要手动下 deb)装 AMD ROCm 7.2 与 飞牛 AI 引擎(AMD MIGraphX)(落地路径约 /var/apps/trim.ai-runtime-amd-migraphx/),装完完整重启一次(仅后台刷新不加载新驱动)。该版本内核升到 6.18.18,升级过内核后需重装此前手动装的显卡驱动,否则设备列表可能为空。
六、飞牛系统 / App 层面的问题
以下问题与具体机型无关——是 fnOS 系统或相册 App 自身的行为与缺陷,跨机型一致,故从各机型小节里抽出来集中记。每条都注明发现日期与涉及版本;机型专有的问题(如 J4025 旧版那条 GPU HANG——归因至今未坐实,见 4.1)仍留在第四节对应机型下。
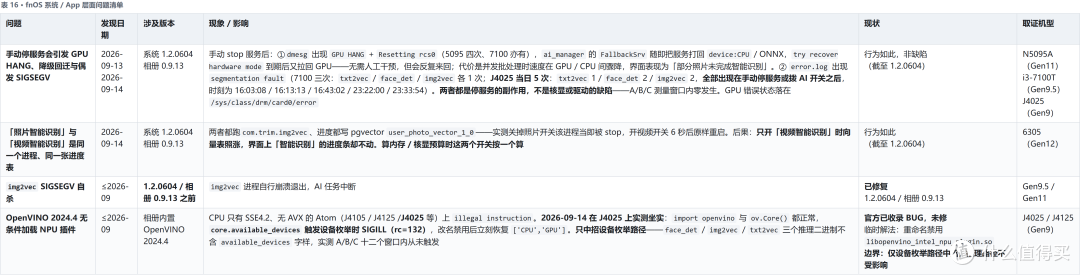
别把两个 SIGSEGV 混成一个:表中「img2vec SIGSEGV 自杀」是旧版已知 bug,1.2.0604 起已修;而 1.2.0604 上观测到的偶发 SIGSEGV(i3-7100T 3 次、J4025 5 次,跨 3 个服务)是手动停服务的副作用,与那个已修的 bug 不是同一回事,也不是稳定性缺陷。
七、核心结论与选型建议
Intel:核显 Gen ≥ 12 稳妥;Gen11 / Gen9.5 / Gen9 均已实测可用。
AMD:RDNA3 及以上有可用实证;Vega 全系与 RDNA2 核显预期回落 CPU。
任务瓶颈不同:人脸多受 CPU / 时延限制(face CPU 47.4% / 94.4% / 75.1% / 52.1%,GPU 只用 23.6%–67.3%);智能分类是纯 GPU 任务(R3D 96.8%–99.2%、rc6 掉到 0.8%–3.2%),随 EU 数近似线性(四台每 EU 吞吐 0.500–0.536)。只测一个任务就下代际结论会错。
换机收益不均衡:分类换核显直接兑现(Gen11→Gen12 单跑 3.01×;Gen9→Gen9.5 单跑 2.03×,逼近 EU 数之比 2.0);人脸压不满核显,换 CPU 或核显收益都有限(1.66× / 1.57×)。
内存门槛:相册「增强模型」需 ≥8G;6305 核显路径 AI 增量约 0.9G / 单模块、1.6G / 并发。
选型:
跑相册 AI(GPU 加速)——Intel 选 Gen12 及以上(Tiger Lake 的 UHD 48EU / UHD 730/770 / Alder-N N100、N150、i3-N305);AMD 选 RDNA3 及以上且规模越大越好(780M / 8060S);Vega、RDNA2 核显不要指望。若一次导入整库且要求无人值守跑完,Gen11 换 Gen12 值:折算 2.1 万张整库首扫,只跑智能分类约 14 小时 vs 41 小时。
只做存储、不用相册 AI GPU——AMD Vega 平台可接受,AI 走 CPU(限 1 核,慢;300U 那档 2.6 万张约 10–12 小时)。Gen9(J4025)已复测可用(见 4.1),但智能分类只有 6.00 张/分——能用,只是慢:整库 2.1 万张只跑智能分类约 58 小时,属「挂一晚上不够、挂一周末刚好」那一档。
Intel 现役推荐:性价比 N100 类;最强档 i3-12100 / i5-12500(AV1 全解码)。
附录 A:CPU 选型对比与相册 AI 吞吐预估
附录 A 为 CPU 选型对比。前 10 列为规格与参考跑分、非实测数据,仅供选机参考;「核显」列写作「型号 · 代数」——Intel 记 i915 代次、AMD 记图形架构,与「架构」列的 CPU 架构不是一回事(见第二节);末 3 列只评估 Intel 核显路径(2026-09-14 依四台实机读数重估),AMD 五行不给数(见下表后的注)。行序:Intel 按核显代次升序,AMD 按图形架构升序。
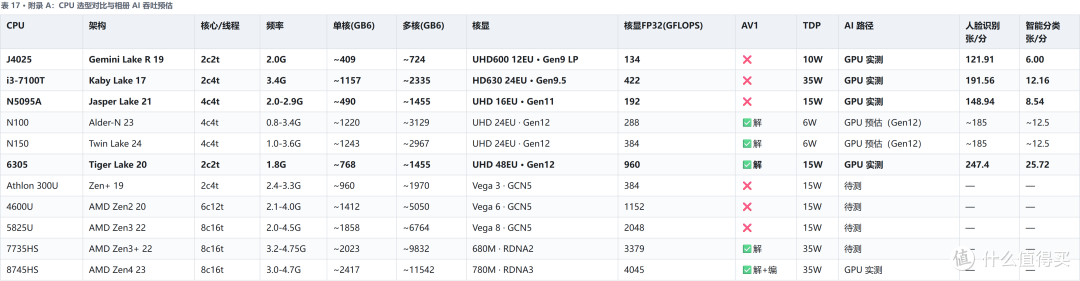
注(末两列的估法,2026-09-14 依四台实机重估):加粗 = 第四节实测值(同素材、同规程、120 秒窗口);~ = 按实测拟合式外推,不是实测;两列的 — = 本表不给数(AMD 五行未评估)。
Intel 两条拟合式(四点实测锚定:Gen9 12EU / Gen9.5 24EU / Gen11 16EU / Gen12 48EU):
智能分类 ≈ 0.51 × EU:纯 GPU 任务,跨四代每 EU 吞吐 0.507 / 0.534 / 0.536 / 0.500(离散度 ±3.6%),是同一套执行效率;不乘频率——核显频率从 558 到 1030 MHz 都不影响该式,属经验拟合,不是架构结论。
人脸识别 ≈ 370 × EU / (EU + 24):明显亚线性——EU 涨 4 倍(12→48),吞吐只涨 2.03×(121.91→247.4)。该式由 Gen9.5 / Gen11 / Gen12 三点拟合(最大残差 3.4%),J4025(Gen9,12EU)作为第四个独立点在 1.2% 残差内命中(预测 123.3、实测 121.91)——形态等于串行流水线:每张照片先付一笔与 EU 无关的固定开销(CPU / 时延,约 0.16 s/张),再付一笔与 EU 成反比的开销。EU 再大也只到约 370 张/分(拟合外推出的上界,非架构上限)。
人脸不能按规格排序推:四台实测机的 CPU 差异极大(2c2t@1.8G / 2c2t@2.0G / 2c4t@3.4G / 4c4t Gen11),按单核、多核、EU 任一规格线性排序都对不上——亚线性是实测出来的。
外推风险:N100 / N150 都是 UHD 24EU,落在实测区间内,风险小;且两者是 4 核,串行开销那项可能比 6305 的 2 核宽裕,实测有机会高于 ~185。
注(「核显」列口径):Intel 按 i915 代次记,但别拿 dmesg 那行 version 当代次——它报的是 display version,理由与实测见第二节。AMD 按图形架构记,Vega 三代同为 GCN5,与 RDNA2 / RDNA3 是否可跑 AI 的差异见第七节第 2 条。
注(跑分口径/来源):单/多核跑分由 GB5 改为 GB6,数据取自 cpu-monkey 聚合,并经 Geekbench 官方库交叉核对;核显 FP32(GFLOPS) ≈ 着色器数 × 2 × 核显频率,来源同上。
有争议的结论以正文实测为准。
如需转载注明出处
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~









校验提示文案
校验提示文案