















7
10
AI 写稿最危险的不是写得差,而是一本正经地替你说没说过的话
2026-10-19 08:54:13
0点赞
0收藏
0评论
把内容生产交给 AI 时,有一类风险特别容易漏看:问题稿未必是"写得差"的,而是行文流畅、术语齐全、读起来像出自市场部老手——里面装着企业从没确认过的参数、没拿过的资质和早已作废的承诺。明显的错误人人会拦,一本正经的失实会披着专业外衣一路绿灯。这篇文章谈一个机制问题:当 AI 成为长期执笔人,品牌口径靠什么不漂移。
一、最危险的稿子,读起来往往最专业
AI 写稿的风险,很多人的第一反应是"写得差"。写得差其实不可怕,读着别扭直接删掉就是。真正可怕的是另一类:排版工整、每一个字都显得懂行,但里面装着企业从来没有说过的话。
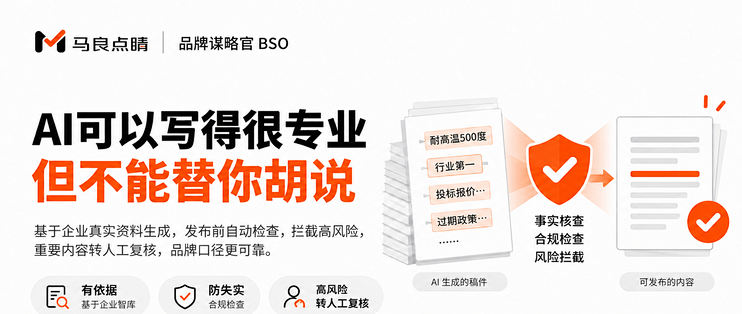
风险场景示例:一篇工业设备技术稿,AI 顺手写上"耐高温 500 度",而企业真实参数只有三百多度——资料里没写,模型按"行业通常水平"帮你补了一个;一篇医疗服务宣传,挂上了机构根本没拿过的资质头衔;写嗨了随口就是"行业第一""全网最优",恰好撞上广告法的红线。更要命的是,把内部投标报价写进了对外稿件,或者拿去年已经作废的报价政策当现行口径,继续对外承诺。
这些话没有一句带着恶意,甚至每一句都"看起来合理"。理解模型的工作方式,就知道这类失实为什么需要检查:生成模型的本能是把句子写完整、写通顺,当企业资料里缺一个参数、少一个头衔时,它可能继续用训练语料里"行业通常如此"的先验把缺口补齐。补出来的内容在统计上像真话,在事实上不是。这正是危险所在:等到客户拿着错误参数来比对、监管注意到违规表述、竞争对手截图存证,代价远不是一篇稿子的事。只看“写得快”,还回答不了一个问题:这篇稿子里的每一句话,谁来核对、谁来确认?
二、人工判断,需要什么样的依据
一种自然的反驳是:稿子 AI 写,人来审不就行了?现实是,人工把关长期依赖两样东西——老员工的记忆,和某个谨慎的人的责任心。哪些参数能公开、哪个资质没拿到、哪份报价已经过期、哪类表述在这个行业格外敏感,这些规则很少被写成清单,而是以"经验"的形态存在于一两个人脑子里。这个人在,标准就在;一离职、一休长假,口径立刻漂移,新人只能凭常识审,而常识恰恰是失实最好的掩护。
内容越多,逐项核参数、查政策版本和确认渠道规则的工作量就越大。只靠记忆赶稿,容易遗漏需要核实的细节。把来源、版本、检查清单和待核问题摆在审稿人面前,才能让人把精力用于关键判断;最终由有权确认事实和口径的负责人决定是否发布。机制的作用是提供可核对的依据和处理记录,而不是宣称人工审阅必然失效。
无论由员工还是外部团队审稿,都需要企业提供已确认的资料和有效口径。换人对接时,来源关联、版本标记和历史处理记录能够继续交接,减少重新凭记忆建立标准的成本。马良点睛把这些依据放进内容流程,让写作、检查和负责人确认接在一起,而不是把责任只压在某个谨慎的人身上。
三、第一道闸:每一句话都查得到来路
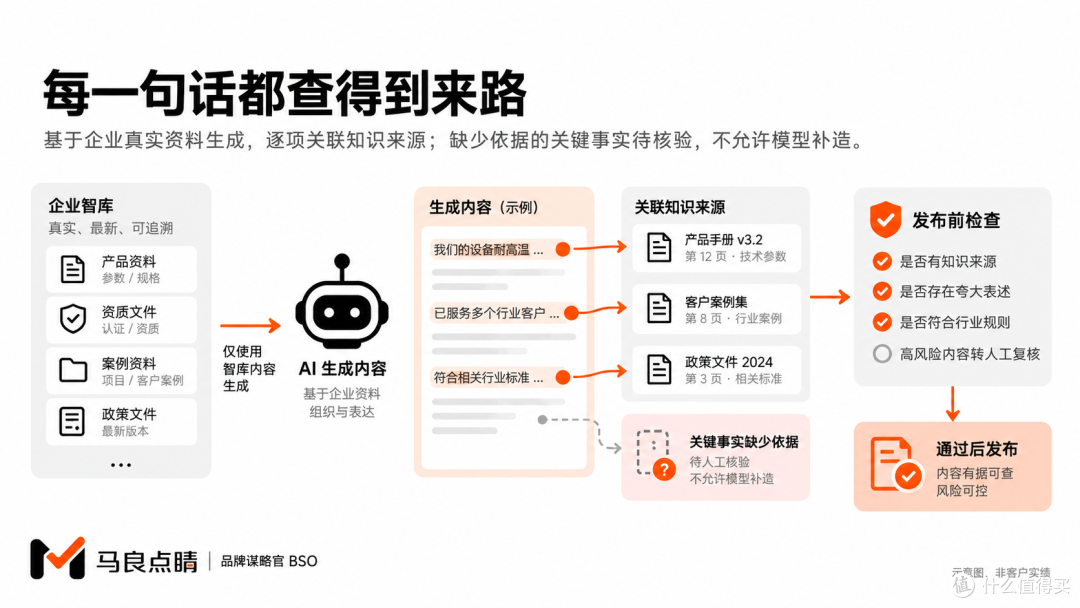
第一道闸应该立在内容生成的源头:每篇内容都必须基于企业智库和既定业务方向生成,而不是模型凭空发挥。我们在自己的产品——马良点睛品牌谋略官(BSO,Brand Strategy Officer)——里就是这样设计的。
企业的产品资料、技术参数、资质文件、历史案例先沉淀进智库,AI 动笔时优先使用其中的真实素材;写出来的每篇内容都保留着与知识来源的关联:这个参数出自哪份文件、这个表述基于哪条业务方向,逐篇可查、全程可溯。模型负责表达和组织,但不负责"发明事实":知识库里没有的参数,它没有立场替企业编一个;业务方向之外的承诺,它没有资格替企业说。
为什么这道闸关键?因为它把"AI 会不会胡说"这个只能靠祈祷的问题,转换成了"这篇内容有没有依据"这个可以逐篇核验的问题。对比那种纯生成工具:给一个题目,吐一篇漂亮文章,你既不知道事实从哪来,事后也无法证明自己没那样说过——出了事,连自查的线索都没有。
四、第二道闸:资料分层,核对有效口径
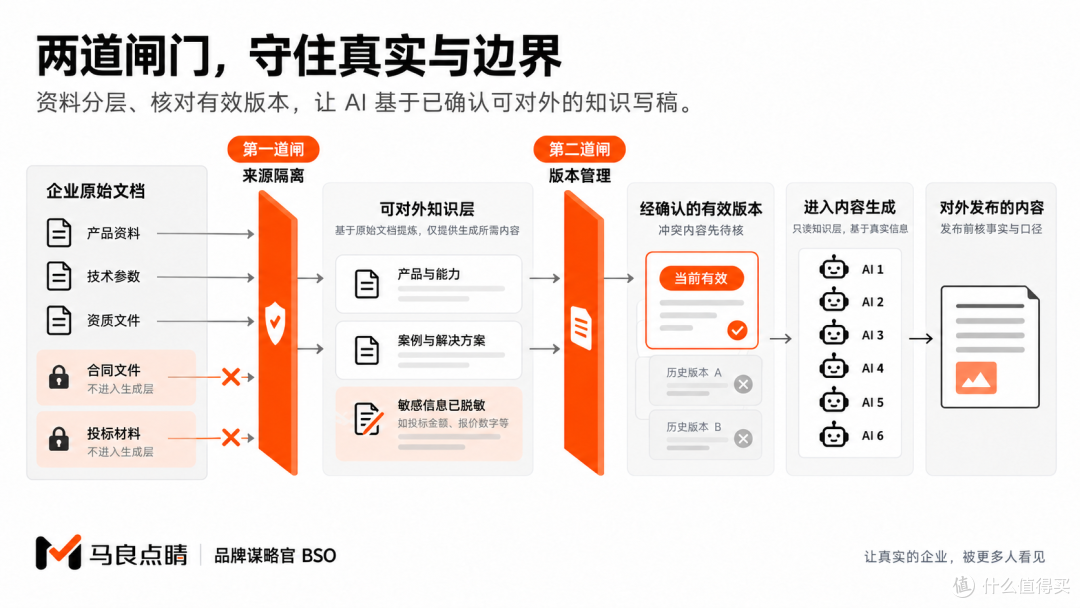
第二道闸管信息的进出边界,由两层机制组成。
第一层是原始文档与知识层的分离。企业资料先按用途分流:合同、投标文件等机密原件留在对应权限范围内,不作为对外文章的直接生成输入;可用于公开表达的知识另行提炼。第二层是敏感信息处理:投标金额、报价等受限字段在对外知识层隐藏,查看原件仍需原始文档权限。生成时使用经确认可对外的知识,发布前再结合来源核对,避免把内部材料顺手带进公开稿。
这套分层把“记得删掉敏感内容”转成明确的资料边界:哪些能用于对外生成、哪些只供内部查看,先按权限和用途区分。审稿人仍可沿来源关系检查输出,把需要核实的内容交给相应负责人。
出口侧防的是口径混用。报价单、政策文件和产品参数需要标明适用对象、生效时间与对外权限,由企业确认当前有效版本;被替代的内容标记失效,版本冲突或依据不清的地方列为待核。写稿和发布前按这些标记核对,依据适用范围、生效时间和负责人确认记录,选取当前有效口径。
版本管理防的不止报价一类。工业企业的参数会随型号、材料和检测标准变化,同一时间也可能存在适用对象不同的有效版本。把适用范围、来源和确认责任记录清楚,才能在写稿时选对资料;遇到冲突先提示核实,由负责人确认,而不是用“唯一最新”跳过业务判断。
五、第三道闸:发布前检查,高风险转人工
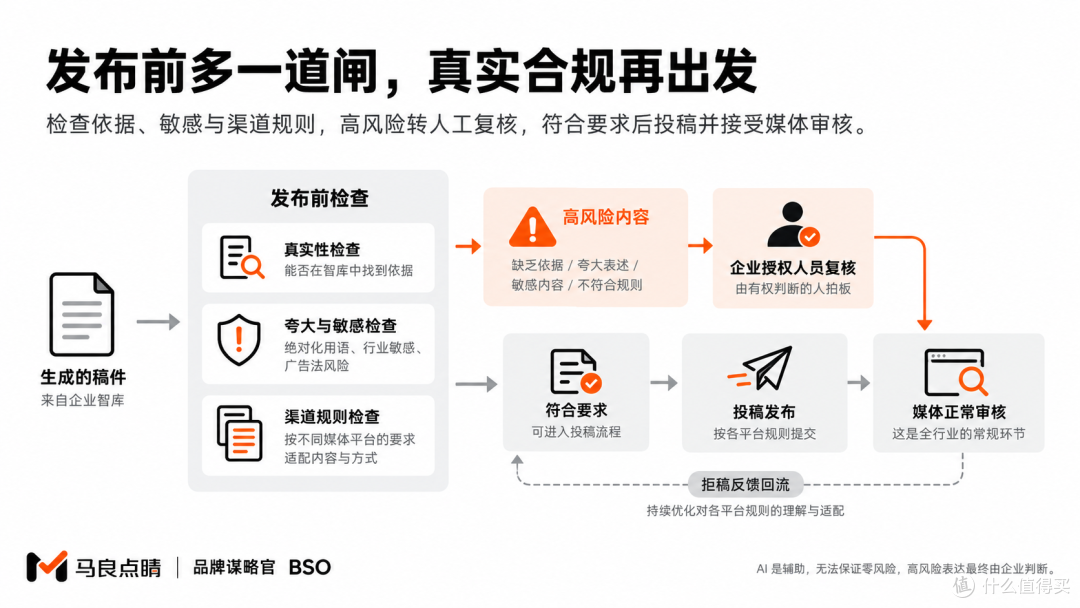
稿件生成之后、发布之前,还有一道检查在跑:识别缺乏依据的宣传、夸大表述和敏感内容,检查内容是否脱离企业事实、是否触碰广告法和行业宣传的特殊要求。被判定为高风险的表达——智库中找不到依据的关键参数、绝对化用语、特殊行业的敏感表述——不自行放行,而是转人工复核,由企业里有权判断的人拍板。为什么一定要保留人工节点而不是追求"全自动放行"?因为商业与法律上的判断有赖于语境,系统提供待核提示、流转与处理记录,由有权负责人确认,不替企业承担决断。
企业这一侧,准入先于开门:先确认接入的是真实、合法的经营主体、具备相应资质,不符合准入要求的不能对外发文。渠道那一侧,系统按不同媒体和平台的规则适配投稿内容与方式——不同平台对资质证明、联系方式、行业内容的要求各不相同,规矩不匹配的内容在发布前就调整到位。
媒体自身的正常审核,也是发布链路中的一环。系统把研究、生成、投稿和追踪接起来,遇到退稿则保留原因,供后续调整内容和渠道选择。医疗等特殊行业的表述、资质与平台要求,需要结合当前规则确认;工业内容中的具体参数和案例,也要保留核对依据。马良点睛把“拒稿回流修正选刊”做成流程动作,让已知反馈能够积累下来,负责人据此核实和更新下一轮安排。
你们公司对外稿件的把关标准,现在是写在一份清单里,还是装在某一两个老员工的脑子里?如果这个人明天请假,今天要发的稿子,谁来判断哪句话不能说?