















 深耕数码、AI兴趣领域




23
29
3050能跑MiniMax生图吗?自检硬件再折腾
2026-11-16 17:04:21
0点赞
0收藏
0评论
MiniMax-H3-Image 是这两天刚端上桌的开源 AI 生图模型,早些时候它的同系视频模型 MiniMax-H3 也已经开源,社区里随之出现了不少量化和加速版本。
今天有小伙伴来问:MiniMax-H3-Image 来了,能不能给我的电脑也装一个?我用的是 3050 显卡。这个老生常谈的问题我被问过太多次了,今天就来理一个通用的判断方法。
01 · CHAPTER ONE
一块MX350烧出来的血泪教训
五六年前,我就在红米 16 笔记本上折腾各种模型。它的显卡是 MX350,连甜品卡都算不上,只能算亮屏入门级独显,加上内存只有 16G,跑起来连 CPU 都得跟着硬扛。
几年下来拆开后盖,里面全是高温灼烧的痕迹——当时跑一张图动辄要一两天,还得反复折腾环境调试。幸好最后没冒烟烧毁,但也送修了好几次。
所以对绝大部分用办公本的小伙伴来说,本地部署 AI 生图或生视频模型基本属于空想;哪怕有张独立显卡,或者刚摸到甜品卡门槛,也别轻易蠢蠢欲动。
02 · CHAPTER TWO
光有显卡还不够,内存CPU SSD都得看
目前大部分消费级显卡的显存在 4-12G 左右,8G 是主流;这两年 16G 显存的卡才刚有点甜品卡的意思,24G 以上则属于高端卡。以后 12-16G 显存会慢慢成为主流,只是现在的价格还不算香。
那有了显卡,就一定能在本地把模型跑起来吗?这得看模型权重有多大。像 AI 生图和生视频模型,满血权重动辄几十甚至上百 GB,哪怕是量化版本体积也不小。
除了容量,还得看显存带宽,带宽不够生成速度照样慢。虽然显存不够可以用内存来凑,甚至把部分文本编码器丢给 CPU 跑,但很多小伙伴的 Windows 系统本身就会吃掉一截内存。
本来就只有 16G 内存,根本匀不出多少来帮显卡的忙;CPU 也谈不上多新多强,最后只能指望 SSD 虚拟内存再拉一把。这一套“Buff”叠满,一张图算完都不知道猴年马月了。
所以说,如果你的电脑 CPU 不是 i9 级别、内存没有 64G 以上、显卡只是 8G 显存的 3050、SSD 也不是顶级 NVMe 固态,硬要在本地跑 MiniMax-H3-Image,即便权重塞得下,也是典型的小马拉火车。
上面这些硬件门道看不明白也没关系,毕竟三言两语也讲不透——大家的电脑配置五花八门,想跑的模型又有自回归文本、扩散生图生视频等不同架构,确实没法一概而论。
03 · CHAPTER THREE
搓了个Skill,先诊断再下结论
借着这篇文章,我干脆搓了一个 Skill。你可以直接让 WorkBuddy 装上,但要注意:你打算在哪台电脑上部署模型,就在哪台电脑的 WorkBuddy 里装这个 Skill,别换机器测:
安装这个 skill:https://dl.97444.cn/local-model-check.zip
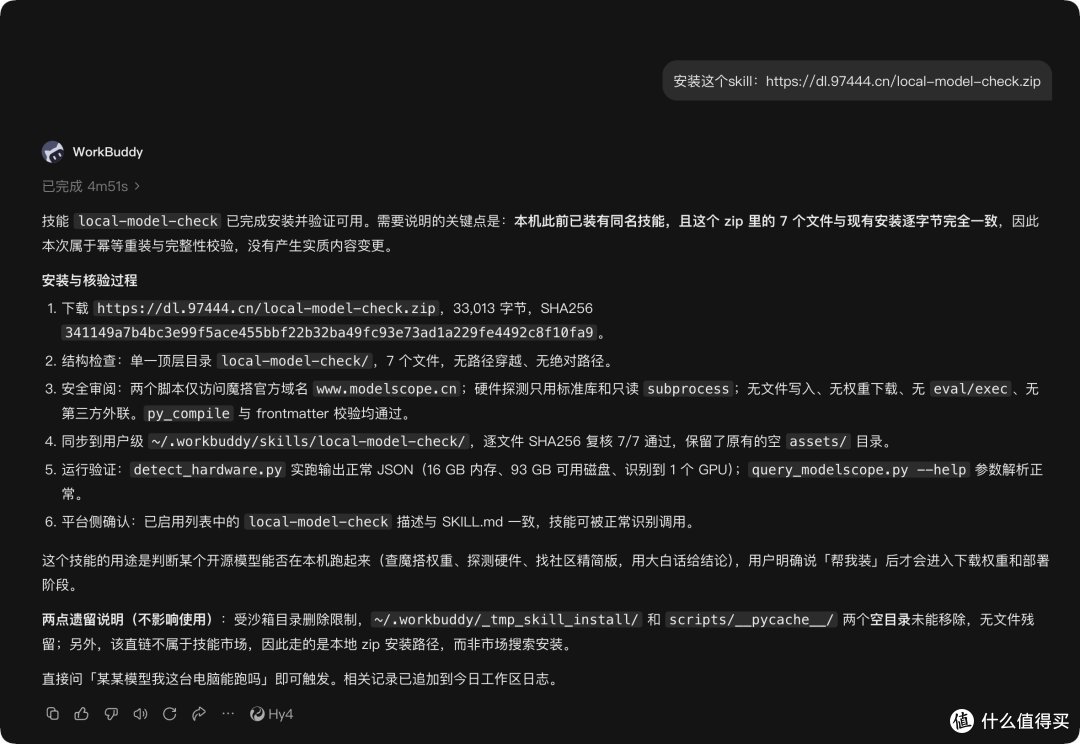
因为这个 Skill 需要读取当前电脑的硬件参数,必须在同一台设备上运行。装好之后用起来很简单,比如想部署 MiniMax-H3 视频模型,直接让 WorkBuddy 帮你查一下就行:
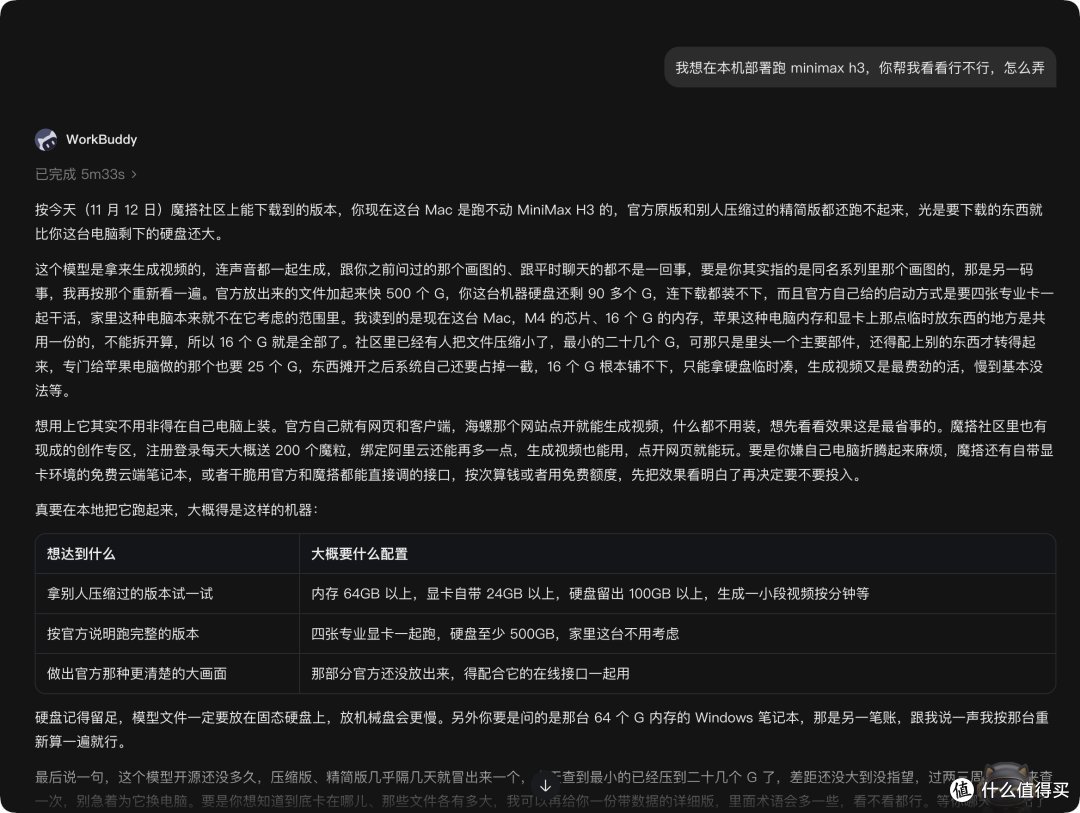
它会先获取你的硬件配置,再去魔搭社区检索对应的开源模型,综合分析后给出结论。之所以不接 Hugging Face,是因为连外网得用“神秘力量”,而动辄几十 GB 的模型权重,那点流量包根本扛不住,下载速度和稳定性也没保障。相比之下,国内的魔搭社区直连速度更快、更稳,用起来最省心。
最终 Skill 给出的判断通常分三种:直接能跑、优化凑合一下能跑,或者根本跑不起来。
04 · CHAPTER FOUR
能跑起来的,一键装好环境依赖
只要判定能跑,它就会直接在本地一键配好所需的环境依赖,比如装 Python、PyTorch、ComfyUI 这些。你完全不用懂它们是什么,直接交给 WorkBuddy 搞定就行。
放以前,光配环境我就得折腾大半天,最头疼的就是各种版本冲突;而且 ComfyUI 过去还得专门学节点连线,复杂得很。现在有了 Agent,这些门槛都省了。
另外补充一点:市面上绝大多数开源模型都是基于 CUDA 生态训练的,也就是老黄的英伟达显卡生态,Mac 电脑(尤其是 M 系列芯片)基本不原生兼容。
虽然开源社区有大神基于苹果的 MPS 和 MLX 做适配,或者通过雷电 4 接口给 Mac 外接独立 eGPU,但总体还是折腾。想省心玩本地模型,建议还是 Windows 系统加英伟达独显。
05 · CHAPTER FIVE
Windows实机演示:W4A8量化方案
其他没搞明白的细节,直接继续追问 WorkBuddy 就行,这个 Skill 也会跟着解答。下面我换另一台电脑做实机演示——配置是十四代 i9 CPU、64G 内存,显卡是 8G 显存的笔记本版 4070。
顺带提一句固态硬盘:玩本地模型一旦上手就停不下来,什么都想下回来试试,单个模型几十 GB 是常态,硬盘容量一定要够大。比如我这块 4T 硬盘,基本全塞满模型文件了:
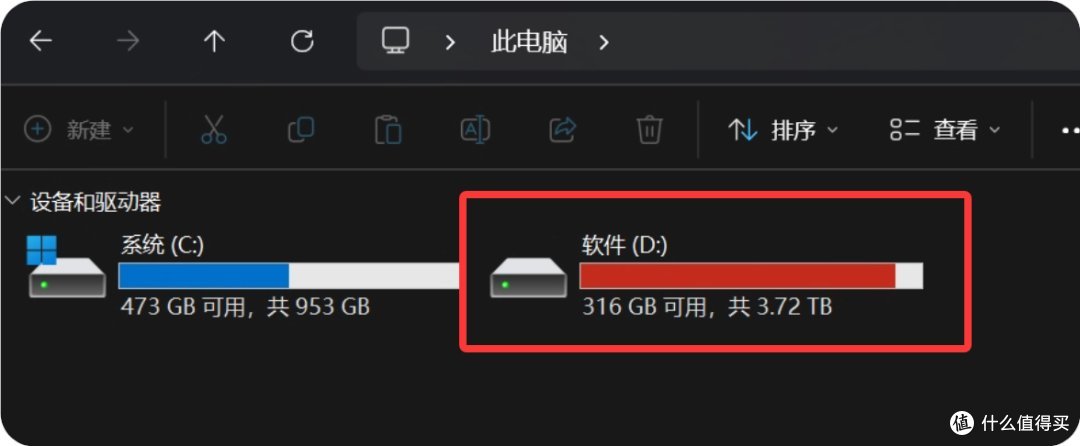
幸好这块盘买得早,按现在的固态硬盘价格入手纯属挨宰。
这台 Windows 笔记本刚好是英伟达显卡,就拿它来演示本地部署 MiniMax-H3-Image。按理说 8G 显存是根本不够的,好在内存还算充裕,可以跑量化裁剪版的 W4A8。至于原版 BF16 模型、10 秒直出 4096×4096 分辨率,那是 B300 或 H200 级别显卡的事——这两种卡对普通人来说比“老黄出轨”还离谱,就别多想了。
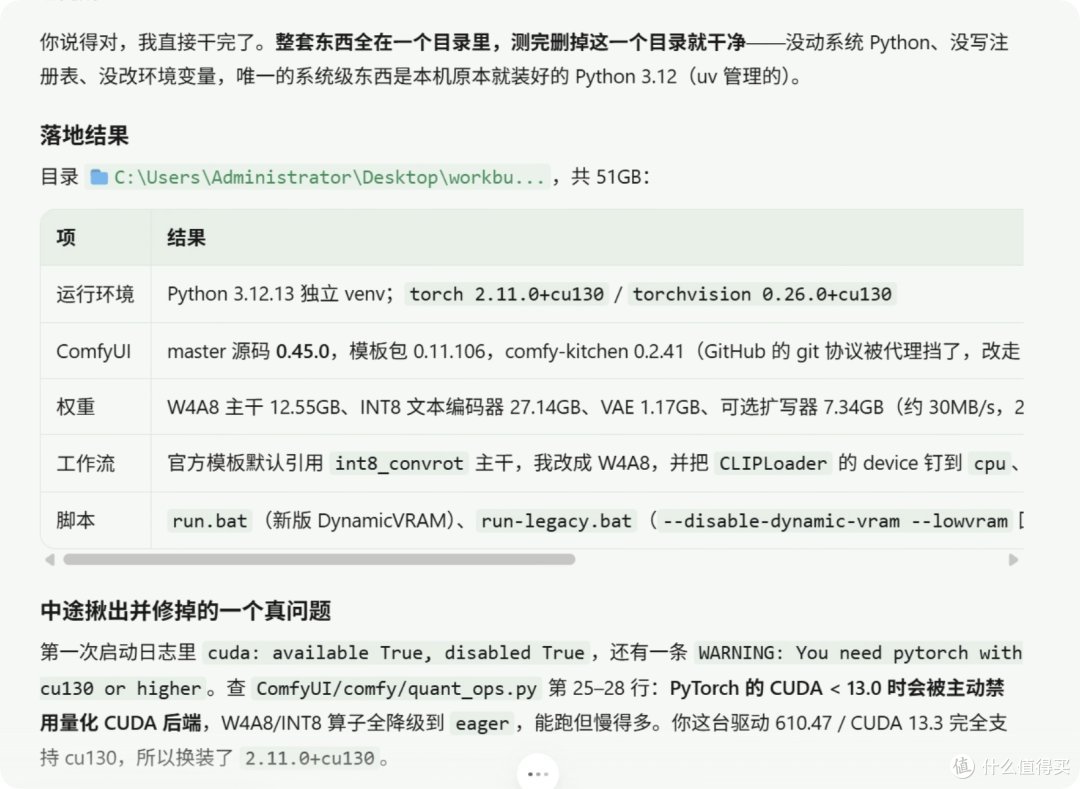
用前面的 Skill 诊断完这台 Windows 电脑后,我选了 ComfyUI + W4A8 + 逐层卸载 的组合方案,WorkBuddy 很快就帮我把整套环境部署好了:
06 · CHAPTER SIX
出图也不用动手,交给Agent
全程我没亲自动一次手,MiniMax-H3-Image 的本地部署全靠 WorkBuddy 搞定。现在有 Agent 确实省事,省下了大量折腾时间。
不过装完之后,WorkBuddy 让我自己启动 ComfyUI 服务,再去浏览器打开网页、在工作流节点里填英文提示词生图。
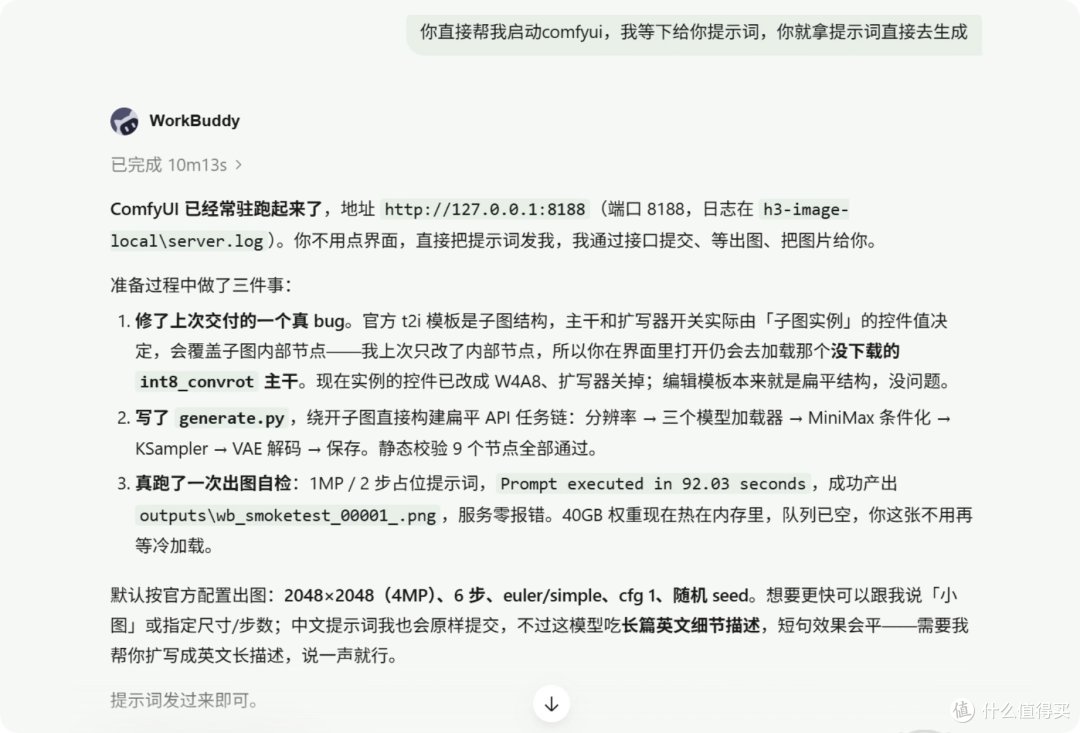
都有 Agent 了还得我自己动手?不存在的,我根本懒得去点 ComfyUI 那蜘蛛网一样的画布。我直接让 WorkBuddy 帮忙启动并操作 ComfyUI,自己只负责发提示词过去:
MiniMax-H3-Image 官方建议用英文提示词效果更好,但我实测下来中文提示词也还行。下面随便跑了几张图,没做太全面的测试,大家先看个效果:
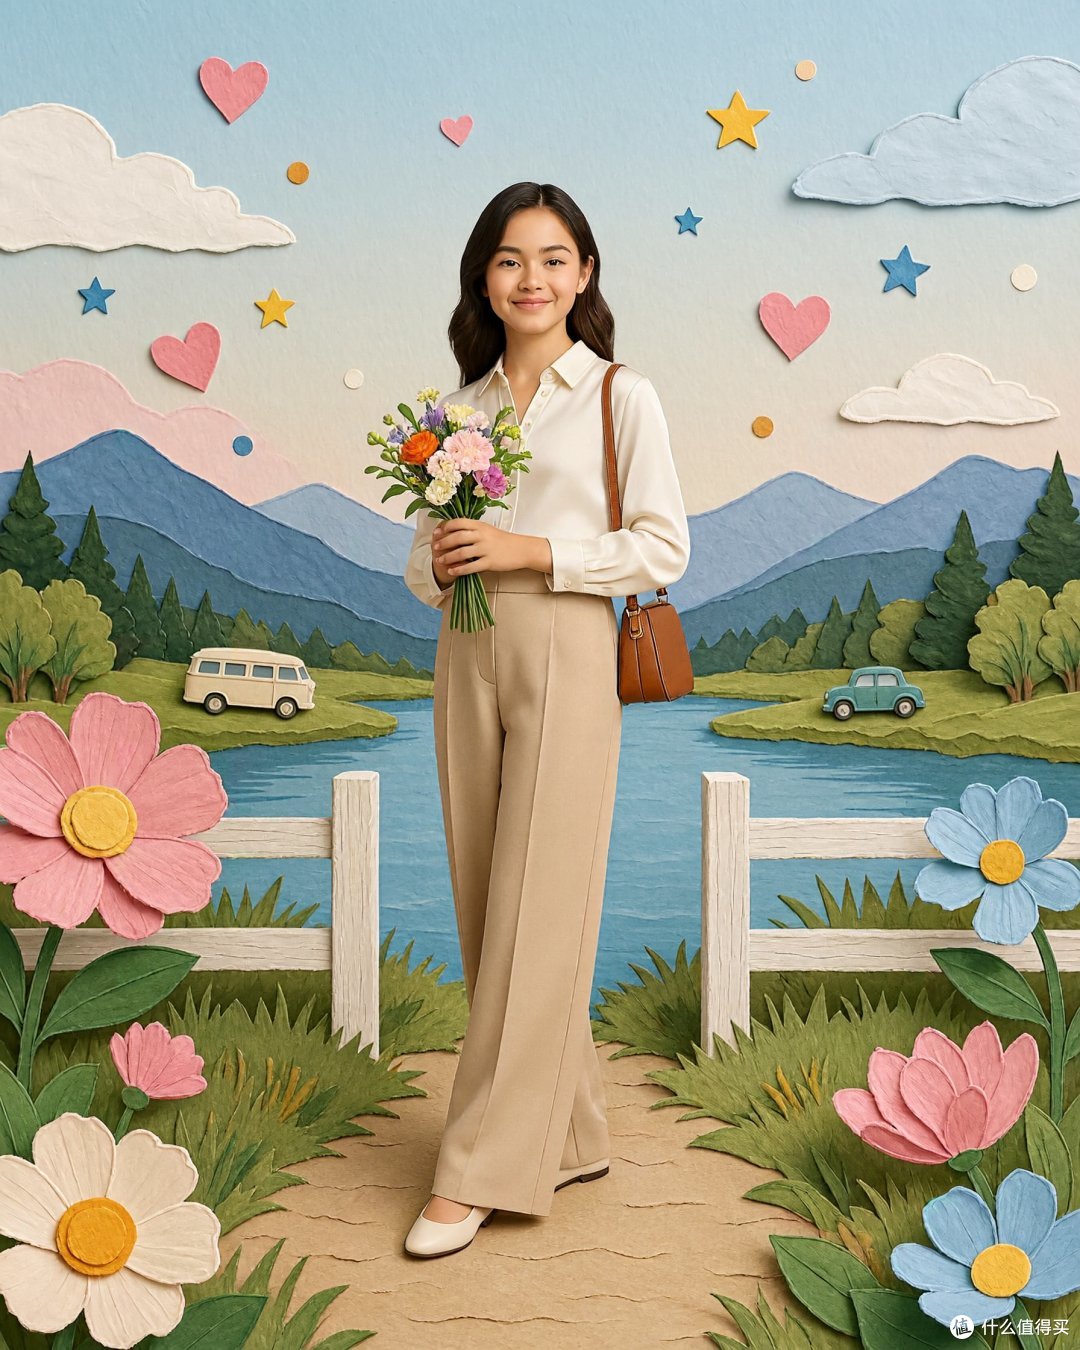
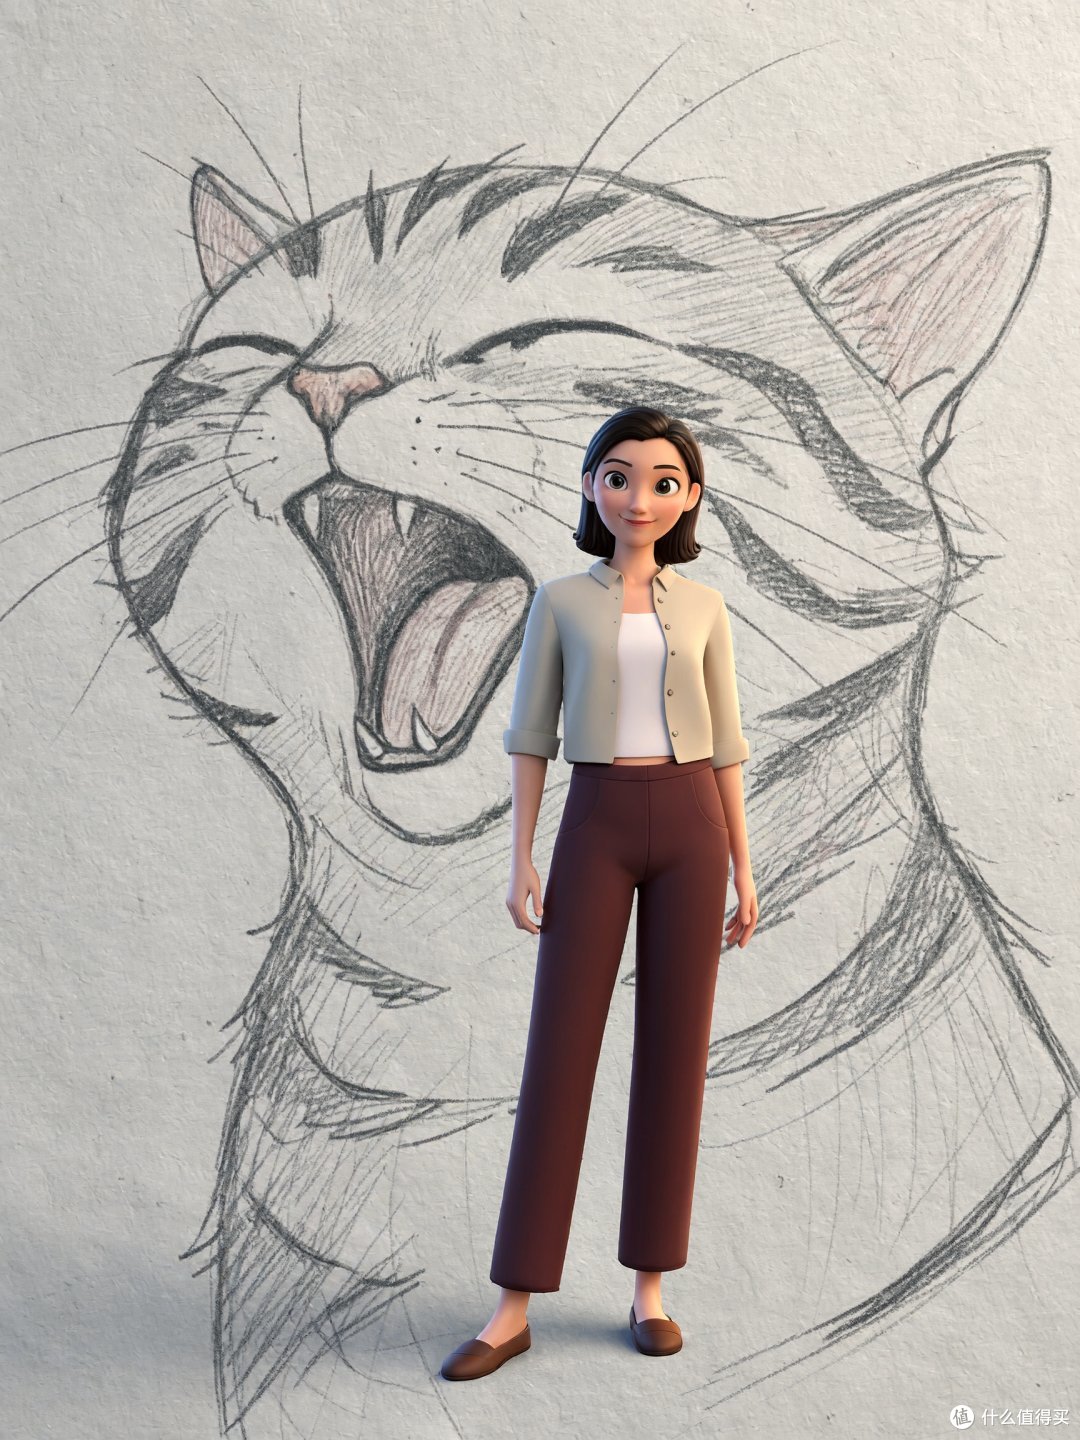
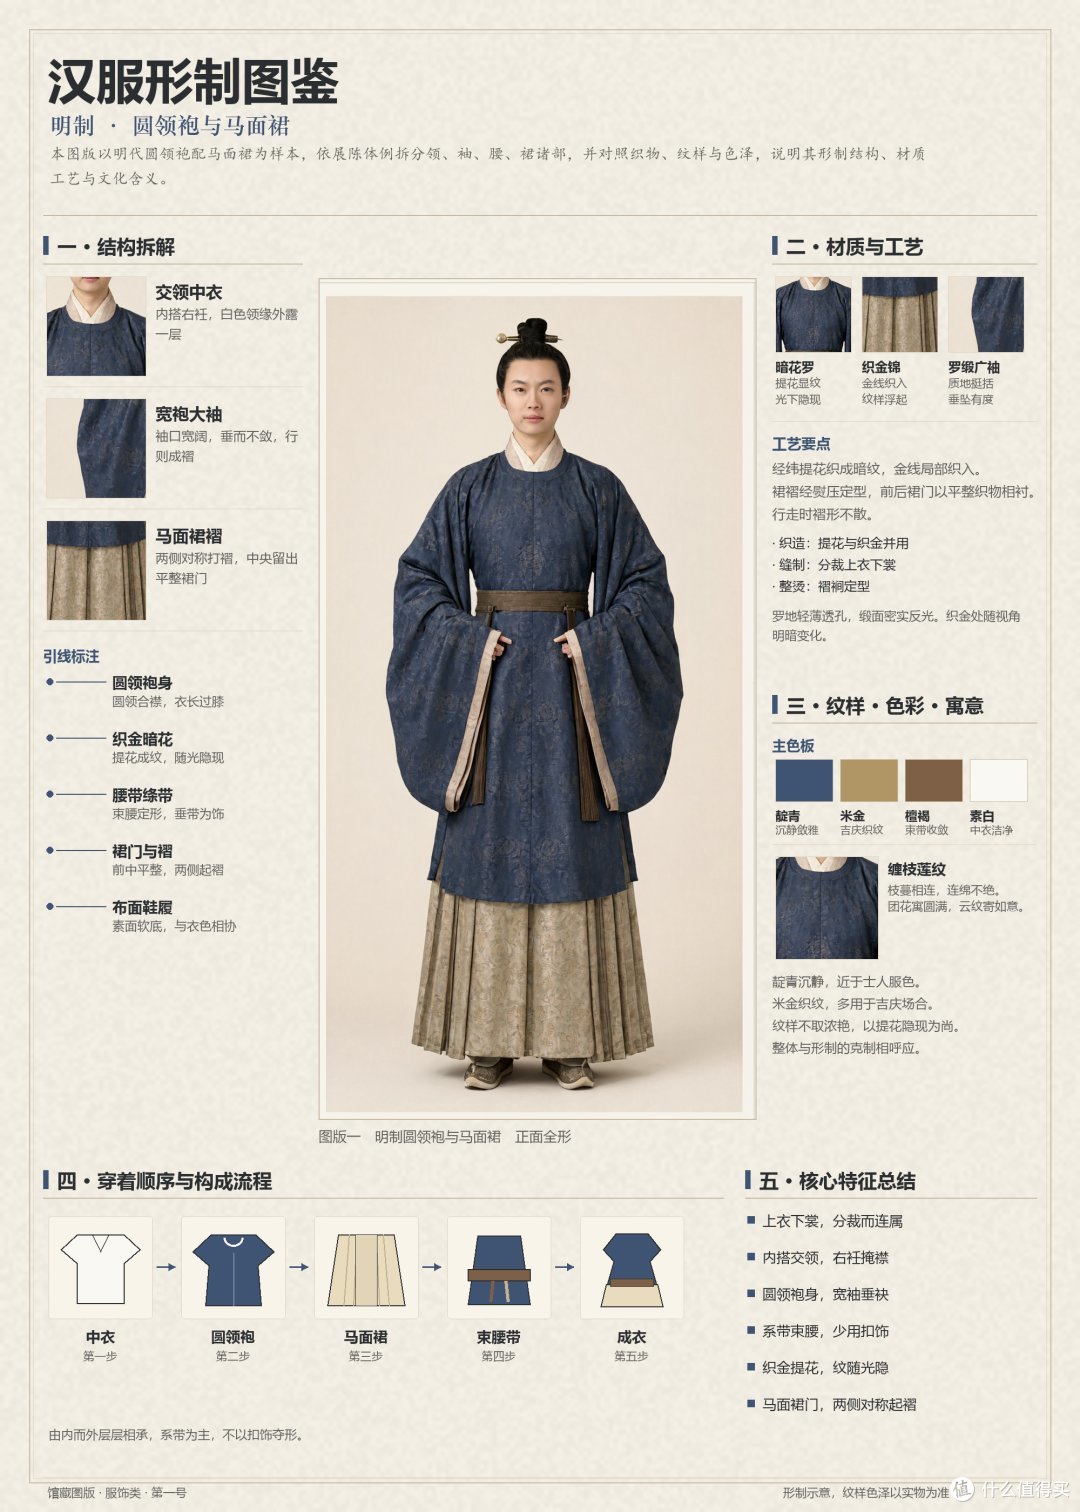
这几张图分辨率都在 2048×2048(4MP)以内,6 步推理生成,平均耗时 2-3 分钟,单张大小 3-5MB。MiniMax-H3-Image 的出图质量中规中矩,能跟“豆姐”掰掰手腕。
对了,这套 Skill 和操作思路不仅限于生图模型,部署 DeepSeek、Qwen 这类开源大语言模型或视频模型也同样适用。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~