














7
5
人形机器人要200GB内存,AI泡沫破了也不降价?
2026-10-01 21:44:14
0点赞
0收藏
0评论
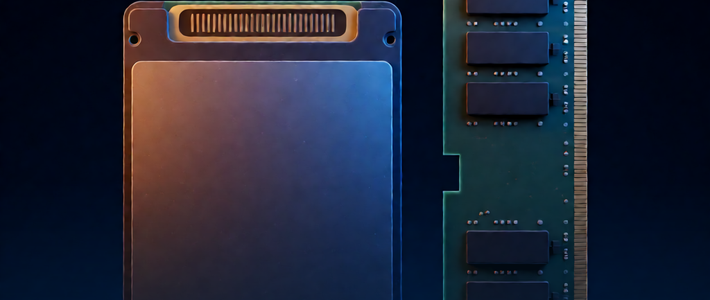
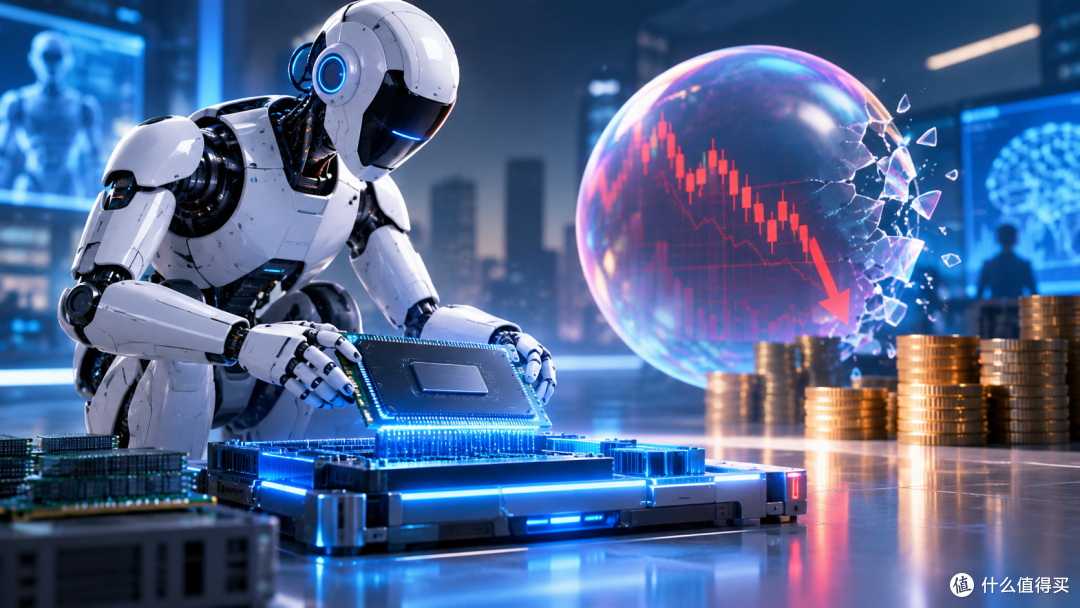
一台人形机器人,要吃掉超过 200GB 内存,外加好几 TB 闪存。
这个数字出自 10 月 1 日美光的财报电话会。同一场会上,这家公司给出了季度营收 542 亿美元、毛利率 87% 的成绩单,都是历史新高。
但真正值得琢磨的不是这两个数,而是紧接着的另一句话:内存的紧张,不会因为 AI 泡沫破了就自动缓解。
过去两年,很多人心里都装着一个默认剧本:这轮 AI 是热钱堆起来的,泡沫一破,芯片过剩,存储价格自然下来,然后电脑和手机跟着一起便宜。
美光把这个剧本否了。它给出的理由跟"AI 会不会凉"没多大关系,而是一件更慢、更难改的事。
200GB 到底是多少
先把这个数字换算成你熟悉的东西。
你今天用的旗舰手机,内存普遍在 8GB 到 12GB 之间;一台主流轻薄本,16GB 或 32GB;一辆还不错的智能电动车,智驾平台的内存大致也在这个区间。
200GB 相当于十几台旗舰手机加起来,或者六到十台笔记本。
美光在电话会上把自动驾驶和机器人放在了同一档:L4 及以上级别的自动驾驶汽车,内存通常超过 200GB,存储达到几个 TB,比今天的 L2+ 和 L3 级辅助驾驶高出"一个数量级";人形机器人"预计也将有类似的需求"。
一句话说清原因:车和机器人要装的不止一个大模型,而是一整套同时在线的模型。
拆开看,一辆 L4 车在路上跑的时候,感知模型要实时处理多路摄像头和激光雷达,预测模型要猜周围每个交通参与者的下一步,规控模型要给出动作,还有一个语音助手要在本地随时应答。这些模型得同时驻留在内存里,谁被换出去,谁就慢一步。
放到场景里更直观。你手机上的语音助手可以联网兜底,卡一秒没人受伤;一台两吨重的车不行,它的每一次判断都得在自己身上完成。
HBM 和普通内存,抢的是同一片晶圆
要理解内存为什么便宜不下来,得先知道一块存储芯片是怎么被造出来的。
一句话说清:HBM 和普通内存不是两条独立的产线,是同一条。
HBM 是高带宽内存,把多层存储芯片垂直堆叠、用硅通孔连起来,让 AI 芯片以远超传统内存的速度读取数据。它现在是训练和推理集群里最紧俏的部件。
拆开看,问题正出在"同一条产线"上。三星高管 9 月 29 日说,2027 年 HBM 将占到 DRAM 总晶圆产能的 近 30%,目前大约是 20%。他同时点明了关键:HBM 和标准 DRAM 共用同一条晶圆产能线,两者直接争夺相同的制造资源。
这意味着什么?同样的晶圆面积,做 HBM 能切出的可用容量,比做标准 DRAM 要少。堆叠和封装占面积,良率也更难做。厂商把产能往 HBM 挪一个百分点,市面上能买到的普通内存就少一块——不是被谁囤起来了,是物理上没造出来。
美光自己的说法是:行业 HBM 需求的增速,会持续跑赢传统 DRAM 直到 2028 年。
放到场景里,你明年想给台式机加一条内存条,价格由谁决定?主要由那些正在为 AI 集群抢 HBM 的采购方间接决定,而不是由内存条厂商决定。
真正卡住的不是钱,是洁净室
第二个慢变量比 HBM 更硬。
存储工厂不是想建就能建的。造 DRAM 要在洁净室里完成,而一座洁净室从规划、动土到跑出第一片合格晶圆,周期以年计。
美光在电话会上列了一串时间表,翻译成普通话就是:钱能马上花出去,产能不能。
爱达荷 ID1 工厂 2027 年中期开始晶圆产出,ID2 工厂要到 2028 年底;日本 DRAM 工厂扩建 2028 年底;台湾铜锣厂区 2027 年中期才有有意义的出货;新加坡的 HBM 先进封装 2027 年初初始产出;纽约首座晶圆厂的初始晶圆产出,预计在 2030 年。
美光管理层还补了一句容易被忽略的话:新晶圆厂在首片晶圆产出之后,通常还要再过几个季度,才会产生明显的量。
所以它才会说"看不到供需恢复平衡的拐点"。这不是情绪化判断,是排期决定的。
美光计划在 2027 财年上半年花掉约 250 亿美元资本开支,下半年更高,而且增量主要投向厂房建设,不是买设备。
这里有个可以搬到别处用的判断框架:想知道一个"紧缺"能不能缓解,看三件事——新建产能的物理周期有多长、现有产线转换产品时的损耗有多大、下一代产品对产能的额外要求有多少。三个变量里只要有两个是慢的,价格就很难是快的。
适用边界也得说清楚:这套逻辑适用于供给端被物理条件锁死的行业,比如晶圆制造、电力、航运。它不适用于产能几个月就能堆出来的领域,那种地方打脸来得很快。
三个流行的判断,需要重新校准
误区一:AI 泡沫一破,内存就会过剩降价。
这个说法有它的道理。存储行业过去几十年就是这么循环的:需求一冷,价格从高位掉下来,厂商减产,然后等下一轮。2023 年那轮就是活生生的例子。
但它解释不了这次的一个变化。压在产能上的需求,很大一部分不是随时能撤走的投机需求。美光已经签了 26 份战略客户协议,剩余履约义务约 1500 亿美元,客户资金承诺增至 320 亿美元,其中大部分是现金存款。这类协议带有照付不议的性质,2027 年超过 75% 的产出已经被客户提前锁定。
更准确的理解是:泡沫如果真的破了,被打掉的是对未来增长的预期和新增订单,不是已经签下的产能。而供给端的洁净室还在按自己的节奏推进。两边的时间尺度差了三年以上。
误区二:200GB 是眼下的需求,马上要来了。
听起来很有冲击力,也确实容易传播。自动驾驶和机器人对存储的胃口是真实的技术约束,不是编出来的。
但它解释不了当下。L4 级自动驾驶还没有大规模上路,人形机器人的年出货量也远没到"每台都装 200GB"的规模。美光自己给的措辞是"到本世纪末,物理 AI 将成为存储需求的重要驱动力"——时间点在本十年末。
更准确的理解是:这是一个已经写进产能规划、但还没写进当期出货的需求。它对价格的影响是预期层面的,不是当期的。
误区三:长约就是厂商在锁价。
这个判断混淆了两件事。长约锁的是供应量和价格区间,不是单方面涨价。美光披露的细节里,四分之三的协议营收有明确的价格框架、多数设了上限和下限,另外四分之一按市场价定期协商。
对下游客户来说,签长约买的是"到 2030 年还能拿到货",而不是便宜。供给紧张的年份,能拿到货本身就是价值;供给宽松的年份,价格下限保护的是供应商。
更准确的理解是:长约把周期波动的幅度压小了,代价是双方都让出了一部分弹性。
给物理 AI 算一笔账
数字喊出来之后,得自己算一遍,否则很容易被量级带跑。
假设一台人形机器人的内存配置就是 200GB。10 万台机器人,需要 20PB 内存。
这个量级是什么概念?一个装了 10 万张 GPU 的 AI 集群,每张卡配 192GB 的 HBM,HBM 总量大约是 19.2PB。
换句话说,10 万台人形机器人的内存需求,大致等于一个 10 万卡集群的高带宽内存总量。听起来不少,但别忘了:10 万卡集群现在是头部厂商单个项目就能达到的规模,而人形机器人要跑到年出货 10 万台,还需要时间。
如果出货量涨到 100 万台,需求就是 200PB。到那个量级,它才会真正在供需天平上占到一个位置。
这个算法的边界也要说明。它算的是容量,没有算产能占用效率。HBM 单位容量更贵、良率更难,同样容量占的晶圆面积比普通内存多,所以真实影响会比按容量比出来的更大一些。
方向是清楚的:物理 AI 是一个正在被提前定价的远需求,不是在抢今年的产能。
这件事对三类人,含义并不一样
对个人开发者,最直接的变化是内存这条成本线在往上走。以前攒一台能本地跑大模型的机器,内存是最容易凑合的一环;现在它变成了最贵的一环。应对方式不复杂:把上下文长度和并发数当成预算项来管,而不是当成默认无限的资源。
对企业采购侧,信号是长约的价值在上升。当头部厂商 2027 年超过 75% 的产出已被锁定,下半年才去谈采购的买方,议价空间会很有限。提前锁量、把采购节奏和产能节奏对齐,比等淡季压价更实际。
对普通读者,这件事最后大概率落在终端价格上。手机和 PC 的整体出货量在 2026 年可能出现两位数的下滑,但行业营收预计仍在增长,驱动力来自高端机型更大的内存和存储配置。翻译一下:便宜机型不会消失,但同等价位的机器,配置提升的速度会慢下来。
想持续跟这条线,盯三个信号
第一个信号,HBM 占 DRAM 产能的比例。三星给的路线是从现在的约 20% 走到 2027 年的近 30%。这个比例每上一个台阶,标准 DRAM 的可用产能就少一截。
第二个信号,新增洁净室的投产时间有没有提前。目前公开的排期大多落在 2027 到 2028 年,纽约那座甚至要到 2030 年。如果有项目明显提前,供给侧的紧张叙事就得重新算。
第三个信号,物理 AI 的实际出货。看 L4 车型的落地数量和机器人厂商的量产节奏,而不是看发布会上的参数。
这三个信号分别对应产能结构、供给增量和需求真实性。单独看任何一个都会失真。
你现在的电脑或手机是多大的内存?如果明年换机时,同等价位只能买到和今年差不多的配置,你会提前买,还是再等等?
如果觉得今天这篇有启发,点个在看,顺手转发给需要的朋友;想第一时间收到推送,可以星标我⭐。
关注我,每天陪你聪明看世界 —— 看懂热搜,玩懂AI。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~





