
























7
5
DeepTalk|从算力内卷到智能效率:重新理解Agent时代的Token
2026-09-30 19:18:35
0点赞
0收藏
0评论
如今智能体成了热点,很多人比的仍是「谁的模型更大、更强」。真正决定能不能规模化落地的,往往不是参数量,而是每一次调用消耗多少 Token,这些 Token 最后有没有变成调用方能用的结果。
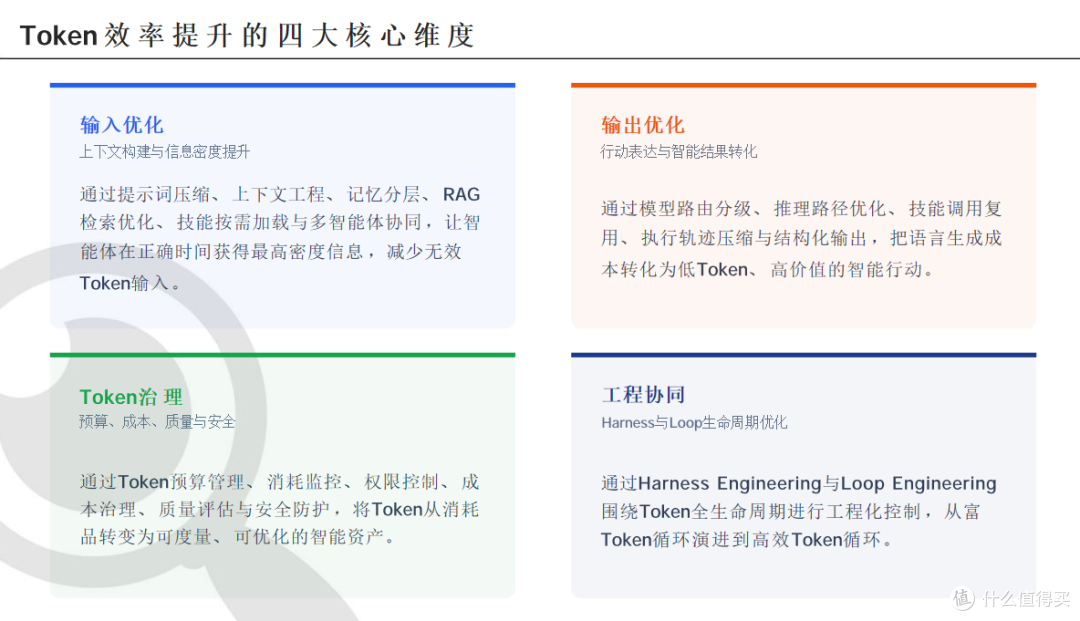
大模型时代,Token 是生成文字的燃料。到了接入这一层,它还是思考、工具调用和返回结果的计量单位。输入决定上游看见什么,输出决定调用方拿到什么。推理、失败重试、缓存未命中,都会变成持续消耗。要提高这些消耗对应的效率,不能只多接几家模型,而需同时推进输入约束、输出约束、Token 治理和路由工程:
行业竞争也在沿同一方向演进:算力竞争(谁堆得动GPU)→模型能力竞争(谁更强、更通用)→Agent能力竞争(谁能稳定完成复杂任务)→Token智能效率竞争(谁用更少 Token 交付更复杂结果)。深兰正在做的,就是模型前面的这一层:不生产模型,而是决定一次调用走哪条渠道、按什么协议出去、最后记在谁的额度上。
一、Token 和智能体,是燃料与发动机
Token 决定 Agent 的表达和推理边界:上下文够不够、推理链拉不拉得开、行动指令写不写得清。同样 1 万 Token,可能打在失败重试上,也可能打在一次成功的调用上。在我们正在落地的这层接入里,渠道决定上游,令牌和分组决定谁能调用、能用哪些模型,模型映射把调用方的模型名落到具体上游。任务越长、重试越多,消耗往往越高。可以把它想成:Token 是燃料,决定能力上限;这层接入是发动机,决定使用效率。燃料不够,再强的上游也跑不远;路由和计费太糙,Token 再多也在空转。
消耗 ≈ 任务复杂度 × 推理深度 × 行动次数 × 协作数量
关键不是少调用,而是把「语言生成成本」变成一次可结算的有效调用。输入 Token 决定上游知道什么,输出 Token 决定调用方拿到什么。中间要经过鉴权、选渠道、协议转换、计费和记日志,再把结果送回去:
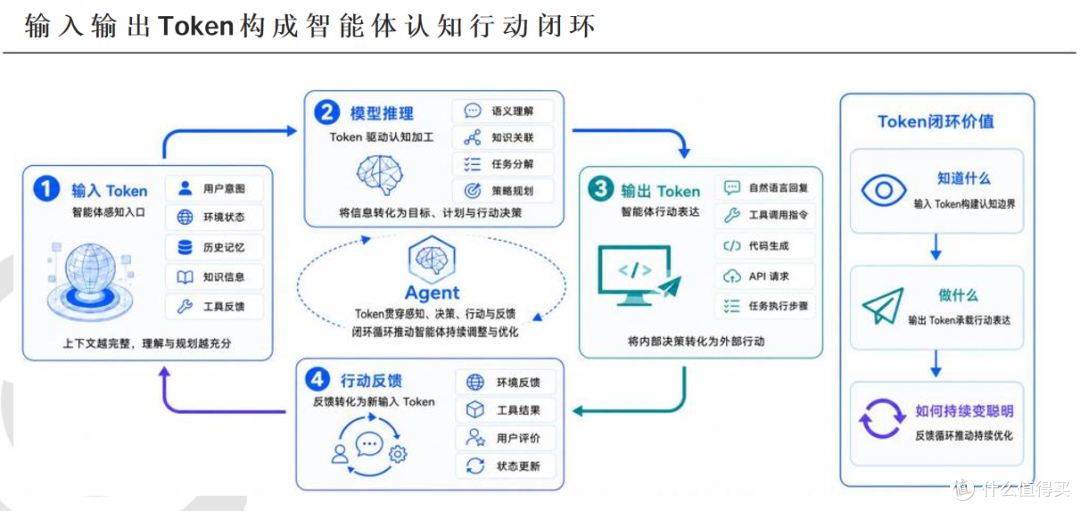
二、输入 Token:上下文构建与信息密度调用方看到的往往只是一次请求;真正进入上游上下文的,是请求体里的全部内容:输入Token = 用户意图 + 对话历史 + 任务上下文 + 知识检索 + 记忆 + 工具信息 + 规则约束Agent 越复杂,系统提示词、历史和工具定义,往往比用户那句话更占窗口。检索和记忆留在业务侧;请求一旦进入我们这一层,就会按 Token 计入额度。数量多不等于更聪明。真正起作用的是:质量 × 相关性 × 组织方式。低质量 Token 只会加快扣费。下面六条,是请求进入之前就要做好的事:
1.提示词压缩:从长篇说明书,变成最小必要指令集。超大请求在入口处被拦住。
2.上下文工程:采集 → 筛选 → 压缩 → 动态加载,避免把知识、工具和历史一次写进请求。重复前缀应尽量命中缓存
3.记忆压缩:短期对话和长期记忆分开,不要整段回放。用量日志用来对账,不要再塞进下一轮上下文
4.RAG 优化:少召回、准召回。检索发生在进入之前,送往上游的应当已是片段,而不是整库
5.工具按需携带:本次用到的工具定义才放进请求。令牌上的模型限制,用来收住能调用的范围
6.多智能体协同:不同角色使用不同令牌和分组,额度和模型范围彼此隔离,只传递结果摘要
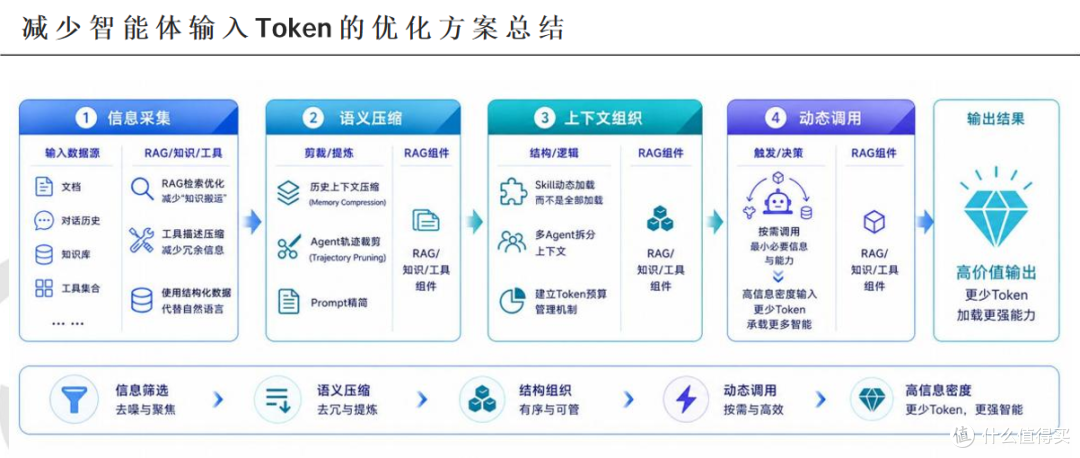
一句话:输入优化拼的是信息密度。
三、输出 Token:从语言生成到任务执行普通模型用 Token 生成答案;智能体调用在抵达上游前,还带着规划、工具参数和多轮消息。思考预算、工具返回和失败后的再次调用,都会扩大额度消耗。输出要变成调用方能解析的协议:OpenAI、Claude、Gemini 之间的格式转换,就做在这一层。降低输出消耗,重点不是把回答写短,而是让调用变成可执行结果:思考力度按任务分级,调用方不必为每家上游重写协议,失败重试有次数上限。
1.模型路由:简单任务走轻量渠道,复杂任务走大模型渠道。路径是任务识别 → 渠道与模型映射 → 加权选择 → 失败再换渠。
2.推理优化:想得更有效,而不是想得更多。用思考力度或思考预算控制推理 Token
3.工具调用:工具参数保持结构化字段,经协议转换后仍可被程序直接使用
4.轨迹压缩:日志留下模型、渠道、Token 和是否命中缓存,不把整段过程再计进下一轮
5.结构化输出:用统一协议替代各家长篇方言,使结果可被程序直接解析
一句话:输出优化拼的是结果密度。
四、Token 治理:从消耗品到可经营资产我们把上游的一次调用,收成可分配、可结算的额度。治理落到六个动作:预算、监控、权限、成本、质量、安全。目标只有一个:在保证调用可用的前提下,让Token可控、透明、高效、安全。
• 预算:用户额度和令牌额度给出上限。分组倍率决定同一笔用量实际扣多少。• 可观测:看板和日志要能看到哪个模型、哪条渠道、是否命中缓存,以及这次调用是否成功。
• 权限:正确的用户、正确的令牌、正确的分组、正确的模型范围。
• 成本:按量、按次和缓存命中分开计。渠道价格、缓存倍率和分组倍率,用来对齐能力与账单。
• 质量:失败才重试,重试次数有上限,避免用重复调用掩盖上游故障。
• 安全:调用令牌和上游 Key 分开保管;日志不记录可用密钥;请求体设上限。要把这套治理运转起来,还需要一条闭环:采集 → 分析 → 预算 → 控制 → 优化 → 评估。这样 Token 才能从上游账单,变成可度量、可优化的额度。
五、工程协同:Harness 与 Loop 的生命周期优化如果模型决定「智商」,我们要决定 Token 怎么被鉴权、路由、转换、计费和记录——请求进入、选渠道、上游推理、结果返回、额度结算、日志退出。Loop Engineering 管的是循环本身。消耗大致来自:重试次数 × 每轮上下文 × 推理输出 × 工具回传。优化不是把模型变弱,而是从失败后原样重打大模型的 Token-rich Loop,演进到加权选渠、有限重试、缓存复用、只在必要时换更大模型的 Token-efficient Loop。
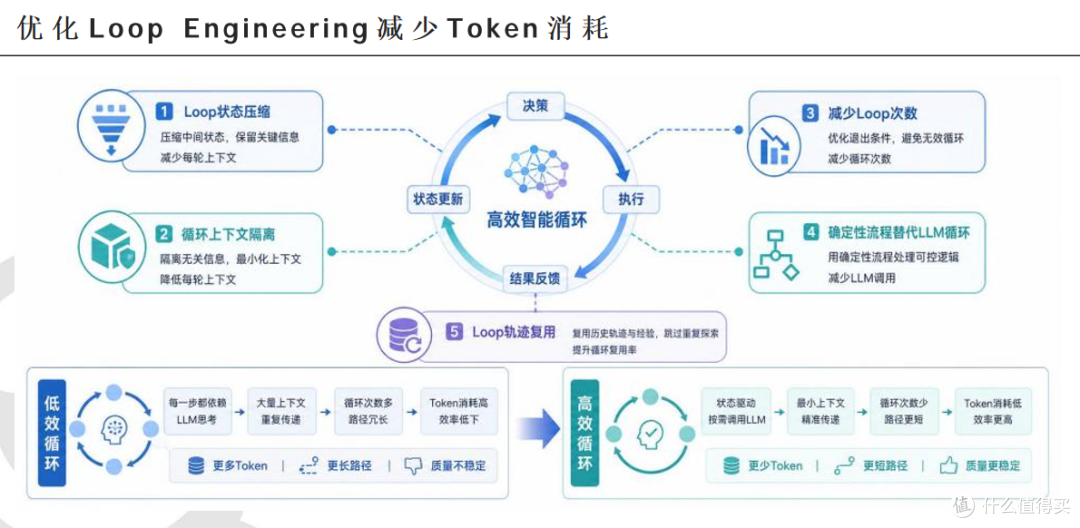
写在最后算力可以买,模型可以换。深兰科技要拉开的差距,是同一笔额度里能完成多少次有效调用。输入把信息密度做上去,输出把协议和行动做稳,治理让消耗变得可度量、可约束,工程则让重试少空转。别再把 Token 只当成上游的计价单位,而要当成可经营的数字能源。






