





 深耕数码兴趣领域




8
5
深度学习硬件指南,解析我的DL调试专用机NUC12飞龙峡谷+RTX3060/RX6800
2022-08-20 14:49:57
84点赞
293收藏
40评论
上次介绍了新买的NUC12 extreme i7,这次就来说说这个机器的具体用途,因为主要用途还是深度学习,所以就顺便聊一聊深度学习的硬件选择。一般聊到深度学习都会默认想到服务器,继而想到CUDA,专业卡。这么想倒是没错,但是深度学习并不是一来就上服务器开跑,也不是绝对只能用CUDA,更不强求专业卡
简介
一般来说,调试所需要的时间和跑训练的时间基本是三七开,而且不保证本地代码能跑通,直接上服务器也没有什么用,反复上传浪费的时间精力更多。所以一般做深度学习开发会准备两台机器,一台是主力服务器,这个一般都是单位或者老板固定租用,要个人拥有这样的服务器至少需要20W的预算,而且不包括机房的环境维护费用,这部分如果是学生或者打工人就别自己操心了。另一台机器就是本地调试机,这台机器的主要作用就是保持和服务器的虚拟环境基本一致,在本地即时调试代码获得反馈。这机器大部分时间都是开着断点模式改代码找bug,保证上传服务器的代码只需要简单几条命令就能开跑,不会跑一半报错前功尽弃
显卡选择上也并不是绝对的CUDA,因为AMD的ROCm 5.x更新之后也是比较好用,安装比CUDA更为便捷一些,RX6800和RX6800XT之流的RX显卡也能进行深度学习
至于专业卡这个问题,我非常不推荐只搞深度学习的朋友买专业卡,专业卡最大特点是管大管够的双精度和驱动支持,但是对于深度学习这种日常单精度甚至半精度的应用来说,专业卡的长处基本就只有大显存一点了。而Geforce和RX这些游戏卡都是能深度学习的。


硬件介绍
主机部分是上次买的intel NUC12 Extreme Kit,这个机器有非常不错的IO能力,显卡也兼容300mm双槽显卡,公版卡自然是不在话下


桌面的使用面积并不算大,总体积8.4L,跟大一点的ITX差不多,但是更修长,对比了一下15寸的电脑,长度上是差不多的


这一代NUC12 飞龙峡谷用的是桌面级CPU,i7版本是12700,在i9版本上的10G网卡也保留了下来,非常适合一个网线插主路由下面,上传数据非常快。背部的两个type-C都是TB4的接口,扩展接口或者接显示器都是可以的。正面的4个接口涵盖也比较广,我的相机用的也是SD卡,所以NUC12这个卡槽也还用得上


拆机,之前用来调试的是一张华硕的RTX3060dual mini o12G,这张卡是比较典型的ITX显卡,所以在机箱里面显得比较空。


很多朋友一直有个误区,就是觉得搞深度学习一定得用很高端的显卡,然而实际上只要是支持CUDA就能搞。不需要训练的话,对性能的需求并不算很高,而且作为调试机,不是主力训练机的话,实际上显存的需求比性能更重要。因为深度学习训练的显存压力来自两个方面,一个是模型参数,一个是tensor缓存,这两者都会随着模型参数和输入规模增大而急剧膨胀。一般要调试肯定会要求模型和输入与主力训练机上的一致,这样不容易出NaN bug,所以面对显存数倍于调试机的时候,买一张显存足够容纳常规模型的显卡还挺关键的。
A卡的游戏卡这边显存倒是给的很大方,4000多的RX6800都有16G显存,如果用ROCm的话就能获得这个优势。而N卡的细分就要难受很多,RTX3060 12GB显存属于是与性能不匹配的大狂牛级,反而造就了他在深度学习方面的些许优势。与之相比,要获得12G显存在Geforce产品线里至少要加钱一倍买3080 12GB,诸如3060Ti和3070这些8GB显卡是没太大吸引力的。3090 24GB如果作为调试显卡就有点太奢侈了,一般都当主力用。


如果要买专业卡,我的评价是建议先看看预算,因为专业卡买来那就是真专业用途,价格更贵游戏更卡,想清楚自己是不是确实需要专业卡带来的其他应用上的优势。首先AMD的Radeon WX是没有额外优势的,需要AMD的MI加速卡才是AI优化,这个卡一般是给主力训练机用的,新手拿着这个开机都是个问题。而N卡的RTX A2000的核心和显存基本和3060保持一致,但是价格贵了一倍,深度学习用不太上Quadro的ECC显存和专业bios,不过要是有其它专业卡需求的话是可以考虑的。RTX A4000 16GB在Quadro里是不错的选择,显存和性能都很够用,6000多的价格一般人咬咬牙也能承担。A5000和A6000更适合主力训练机,显存大性能强,规格也适合服务器机柜。而且专业卡相对来说更保值,可以参见Pascal的专业卡现在什么价,P6000 24GB降价这么久了还得一万一张,而同一代的TitanXp已经跌得马都不认识了


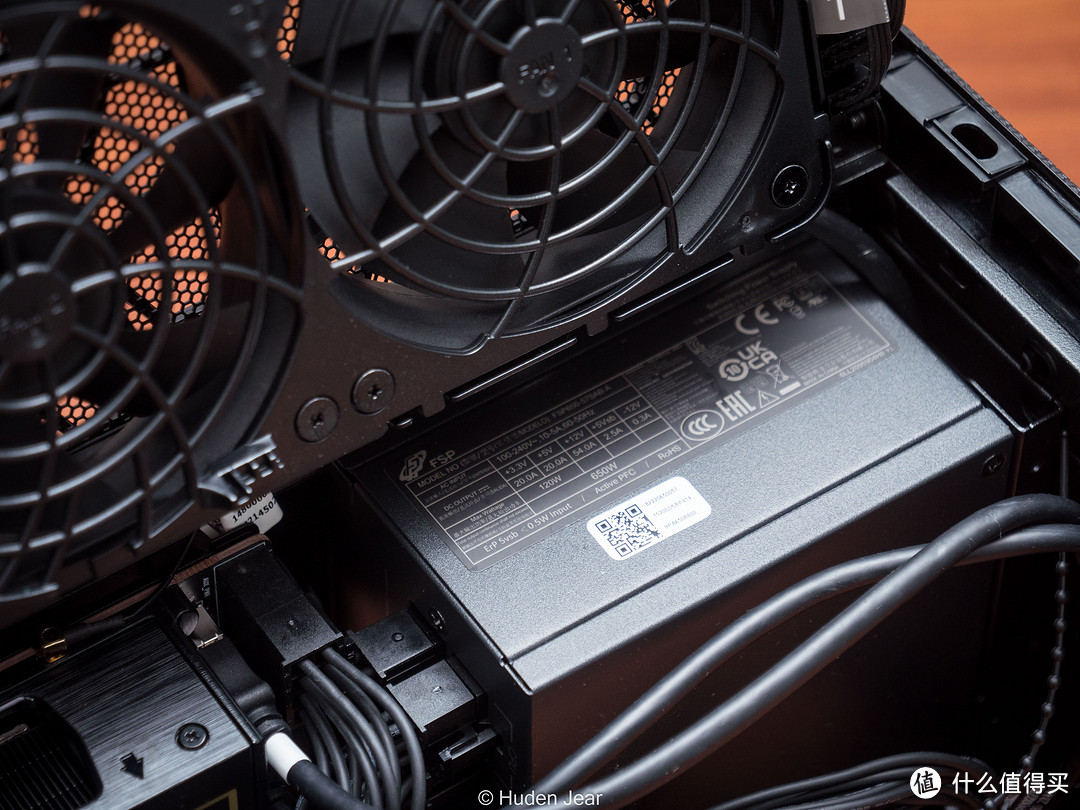


NUC12的计算板是独立导风罩,所以不用太担心散热,3条m.2+两个sodimm,装两个系统再放个数据盘也没什么问题


基本测试
搞深度学习代码调试的电脑的CPU性能要求其实不算很高,不用上HEDT或者服务器CPU,桌面级主流性能的CPU就够了,i5 12400或者5600X都是挺正常的选择,我这个NUC12用的是12700。不过要跑大规模训练的话,建议按照每张卡4个CPU物理核心来配置CPU

调试机比较需要的是IO能力,保证随时能快速的从服务器端下载数据,或者从本地同步代码到服务器,带宽越大越舒服,延迟越低越舒服,现在一般机器都有有线无线两张网卡,保证有线速度至少能达到千兆就好,NUC12 Extreme 的网卡是万兆的,10Gbytes的数据秒传还是非常舒服的


Windows深度学习?
win是目前应用最广的操作系统,有非常完善的图形界面,而且绝大部分游戏都只能在win上跑。如果你的深度学习调试需求非常轻度,只需要稍微改改代码,或者目前还处于学习阶段的话,比较建议使用windows。在win上安装CUDA和装驱动没什么本质区别,在CUDA中是包含了一个验证驱动的,如果驱动版本更低建议更新CUDA的驱动,如果已经有更高版本的驱动就不用安装了。如果不使用VS,安装选项中的VS integration是可以取消的,这个组件在安装的时侯可能会报错


安装好了可以用软件检查一下是否正常,或者使用nvcc命令查看。而CUDNN可以自行安装,在调试机上属于是可选项


一般用的深度学习环境解决方案是pycharm+anaconda,这两个都是非常常用的软件,pycharm有社区版,也可以申请教育优惠,而anaconda则是免费的


装conda用pip乃是人间常态,不得不品尝

装好了就可以搞代码开始跑了,代码跑起来很简单,跑得好跑得快才是关键,这些都得靠不断地学习才能积累经验,没有谁是一来就会设计实验然后跑大规模训练的

win上的深度学习虽然操作系统更熟悉,而且安装也比较方便,但是可惜的是win上的CUDA性能并不是最强的。首先win上就面临一个问题,那就是显存占用,作为主力的显卡会分出0.75G的显存给桌面显示,某些程序还会占用更多的显存,比如浏览器,这让本身就不富裕的显存更显得捉襟见肘(要是只有8G显存光是桌面就占了10%)。还有一个问题是win的内存调度问题,在多个进程同时调用某个内存位置的时候,win上的python有时候会主动再为这个内容开一个地址,这就导致深度学习中很多多进程处理过程速度都会比linux上稍微慢一些


跑代码有很多种方法,作为调试机,一般是推荐使用pycharm的debug模式,可以快速定位错误查看变量具体数值,代码能跑通了再使用命令行


使用nvidia-smi命令查看使用情况,win上空间使用大的问题还是比较明显的,再linux上占用只有5.3G的模型win上需要7.7G,一些原本可以同时跑两个的模型现在只能跑一个了。某些朋友要问了,为什么要同时跑多个呢?因为深度学习过程中显卡并不是100%占用的,除了训练阶段的IO阶段外,训练之间的val阶段占用也相当小,为了充分压榨显卡性能,同时跑两个模型是可以考虑的一种方法


ROCm+Linux深度学习?
本来想吧NvCuda在Linux上的过程也写写的,但是感觉太重复赘余了,除了安装过程有些不一样之外,其他基本都是一样的,而且网上的教程大概有1000000个,各个版本都有,各种bug也都是老生常谈,所以我就省略了
那么下面这个环节讲什么?现在我们来聊聊AMD的最新科技,ROCm5.x。首先是支持,目前5.x的版本已经支持了包括RX6800XT,RX6800,RX6900XT的一系列显卡,AMD也提供了一个AMDGPU管理软件,让ROCm的安装非常方便。而ROCm目前是只支持Linux的,要解决也非常简单,普普通通装个双系统就可以了(确信)。对于DL老鸟来说,装Linux双系统基本如喝水,所以也不是什么问题了

NUC12的显卡支持让RX6800公版正好能放进这机箱,非常合适,留给线的空间也很充足


简单说一下ROCm对系统和环境的选择。首先Linux上用AMD显卡是不用装驱动的,Ubuntu上面集成了非常完善的AMD开源版本驱动,所以装好了就能识别,不用像Nv一样单独打驱动。而目前ROCm所支持的版本已经到了ubuntu 20.04 5.13.0,基本就是最新的,非常不建议更新5.15.0,会在安装的时候遇到build bug

软件仍然选择Anaconda和Pycharm,这两者在Linux上的安装都是非常容易的,教程也很多,就不多赘述了,比较建议新装conda的用户换一下下载源

Linux上的conda环境是可以从同系统的conda中扒出来,比如这个环境就是直接从主力机上复制下来的,只需放到conda的环境文件中,就能像创建的系统一样通过命令激活,pycharm中也是能找到并使用的。还有一个比较建议装的东西是htop,有比较丰富的系统信息,查看CPU和RAM,查看GPU的可以用rocm-smi命令


下面简单说一说ROCm,这个东西是AMD所提出的一个开放式AI加速库,所有的代码挂在github上面,非常开源,现在支持也算是比较好了,从ROCm、MIopen的版本迭代来看就会发现AMD对此的投入也是越来越多,看来是真的有钱了,有钱就是好说话


而目前ROCm终于来到了5.x版本,终于支持了最新一代的RX6000系列的一些显卡,支持速度并没有CUDA那么快,这也是没有商业化的加速库的问题之一

至于ROCm的速度,骑士这个是不用太担心的,早在几年之前还在Vega构架的时候,就能跟当代的P100有来有回,而后面的测试来看,现在RX6800也是非常有竞争力的,基本和同级的显卡持平

安装步骤大概如下:
首先确认自己的系统版本是否为ubuntu20.04 5.13.0-xx。不建议ubuntu18,目前5.x版本是跟着20版本来的,文档会更丰富一些。非常不建议更新5.15.0系统,因为ROCm对应的amdgpu dkms支持是5.13.0版本的,在5.15上会遇到bug,如果你更新了新版本内核,请直接删掉谢谢,顺便把自动更新关了,做开发的Linux开自动更新真的没必要

其次是确认自己的apt-get是否已经更新,ROCm的依赖包含一些系统组件和编译器,需要自行安装build-essnetial,这一点和其他的加速库是一样的
然后使用下面这些命令(从文档里面抄的)
sudo apt update && sudo apt-get dist-upgrade (后面这个命令原本是sudo apt dist-upgrade,但是会更新系统内核并导致bug所以改成了apt-get)
sudo apt-get install wget gnupg2
sudo usermod -a -G video $LOGNAME
echo 'ADD_EXTRA_GROUPS=1' | sudo tee -a /etc/adduser.conf
echo 'EXTRA_GROUPS=video' | sudo tee -a /etc/adduser.conf
echo 'EXTRA_GROUPS=render' | sudo tee -a /etc/adduser.conf
sudo wget https://repo.radeon.com/amdgpu-install/22.10/ubuntu/focal/amdgpu-install_22.10.50100-1_all.deb
sudo apt-get install ./amdgpu-install_22.10.50100-1_all.deb
sudo amdgpu-install --usecase=dkms
amdgpu-install -y --usecase=rocm
sudo usermod -a -G video $LOGNAME
sudo usermod -a -G render $LOGNAME
echo 'ADD_EXTRA_GROUPS=1' | sudo tee -a /etc/adduser.conf
echo 'EXTRA_GROUPS=video' | sudo tee -a /etc/adduser.conf
echo 'EXTRA_GROUPS=render' | sudo tee -a /etc/adduser.conf
echo 'export PATH=$PATH:/opt/rocm/bin:/opt/rocm/profiler/bin:/opt/rocm/opencl/bin' | sudo tee -a /etc/profile.d/rocm.sh
到这里安装就已经完成了,重启一下,使用rocm-smi以及rocminfo两个命令即可查看是否安装成功


接下来是安装深度学习平台,一般时使用的torch,现在torch已经更新了5.x的安装命令,可以直接从官网照抄,下载安装速度也是全满的,非常舒畅。如果要使用tensorflow,需要在官网上下载文件本地安装。现在Torch的稳定版已经完全同步了ROCm的适配更新,而且老版本也是有留档的,不用担心跑扒下来的代码自己的torch版本不支持


目前安装rocm默认使用的py310版本,所以在创建的时候可以直接创建3.10版本的虚拟环境,如果是已经创建好的环境,可在torch官网下载3.7-3.9的对应版本,然后执行本地安装


还有一个可选的东西是MIOpen库,这个库可以加速ROCm的加载过程,降低延迟,提高对应型号显卡的训练速度,跟CUDnn一样对于调试过程不是必须的。MIOpen和ROCm一样都是开源的,所以即使AMD只发布了支持GFX1030(也就是RX6800及以上的显卡支持),但是实际上可以通过自己改代码来实现RX6700XT到RX6500XT的显卡ROCm支持,这在某位知乎大神的操作下已经成为了现实


ROCm的具体使用如何呢?虽然显卡完全不一样,但是在torch里面为了使用方便,所有和rocm相关的东西都有cuda的同义对象,比如cuda.device之类的方法,即使之前的代码中含有使用cuda的语句,也是可以直接开跑不需要再替换的

比如这个作为benchmark的代码,代码中也使用了大量cuda的方法,比如查询版本和cuda设备这些,都是可以不改代码直接跑的

来看看RX6800的深度学习测试成绩


网络上还有一些其他显卡跑出来的成绩,比如这个是单张A100的成绩

这个是RTX3090单张的成绩

这个是实现了ROCm支持的RX6700XT的成绩

下面两个是我自己在Linux上测的RTX3060的成绩


最后来看看成绩汇总吧,我的评价是,ROCm跟CUDA相比已经没有表观上的鸿沟了。深度学习性能测试的差距跟实际的性能差是比较相似的,因为3090和A100就是比RX6800强不少,深度学习也对应的强一些很正常。RX6800和RX6700XT相比强一些也能佐证,这个测试结果并没有什么么大问题。而RTX3060的性能也就停留在调试阶段了,正如上面所说他的12GB显存是和实力不相匹配的大狂牛,所以在调试阶段可用,真要跑大规模训练还是得用RTX3090或者RX6800以上级别的显卡
总结
深度学习这个话题大家都很熟悉,而实际上随着目前各种深度学习平台的逐渐发展,加上网上各种教程都是老生常谈,FastAI一直在简化深度学习的过程,要入门深度学习的学习成本是相当低的。而此时需求就来到了硬件这一边,选择比较合适的调试或主力训练硬件是一个一个困扰很多小白的问题,上面我也列出了很多选择,这里就不重复了,总的来说,购买相应的硬件只需要服从下面这些原则:
1.符合自己的预算和应用需求。就玩玩风格迁移不需要买A100,要搞大规模训练没办法用RTX2060,从自己的预算和用途出发来选择
2.区分好调试需求和训练需求。如果是学生或打工人,先问问老板有没有服务器,有没有分配的个人电脑;如果是老板,先问问学生或者打工人性能需求是怎样的,需要不需要调试和训练分立
3.不强求某一种平台。不要因为周围都用CUDA/ROCm就觉得非xxx不可,实际上代码是可以通用的
目前ROCm安装的教程比较少,如果有ROCm安装的问题,或者硬件选择的问题,可以随时评论区提问,这样issue大家都能看到

作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~









校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案