























16
17
16GB内存的PS5,把27B模型跑到了20字/秒
2026-10-17 22:28:20
0点赞
0收藏
1评论
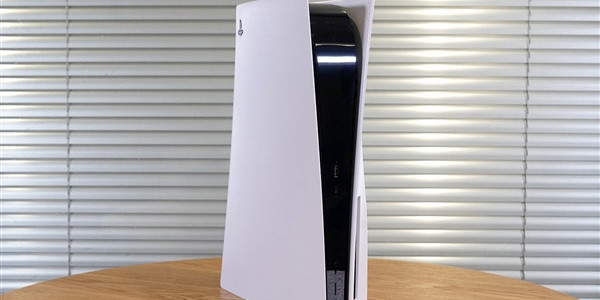
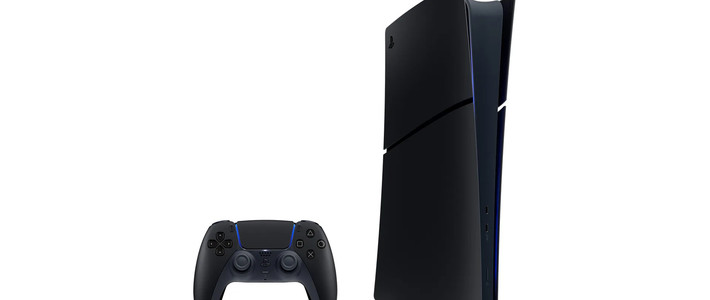
上周五深夜,Reddit 的本地模型板块冒出一个帖子:越狱 PS5 的 GPU 上跑 Qwen 27B,大约 20 token/s。发帖人把开源项目 fork 下来改了几行,做成能在主机上直接启动的原生应用,帖子附了四张仪表盘截图,数字停在 20.9。
国内媒体转得很快,IT 之家今天下午的稿子把它叫作 PS5LM Plus。一台 2020 年上市、如今多半躺在电视柜里吃灰的机器,就这么接过了 270 亿参数模型的活。不是机房,就在客厅,GPU 跑满 100%,CPU 占 2%。
一个 token 折合一到两个汉字,20.9 token/s 落到纸面就是每秒二三十个字,比我自己看小说还快一点。我把截图翻回去又看了一遍,想不通的是那 54GB 的原始权重,最后被塞进了哪里。
先把这件事的真身看清
PS5LM 最早由一位工程师把 llama.cpp 移植过来,早期版本依赖破解后的 payload,主要靠 CPU 计算。跑 27B 模型时,它平均每分钟只能吐 1 个 token,等一句话出来能去泡杯茶。
这次的改动做了两件事。一是把 Mesa 里的 AMD RADV 驱动搬过来,通过 Vulkan 让 llama.cpp 作为原生应用跑在 GPU 上;二是绕开原来的内存分配限制,可用内存从大约 6GB 提到 11.4GB。
答案在量化。他把 Qwen3.8-27B 换成 IQ2_XXS 版本,权重文件 6.77GiB,塞进 11.4GB 可用内存刚好还留得出上下文空间,64K 窗口开着,速度落在 20.7 到 20.9 之间。同一个人后来又试了质量好一点的 UD-Q2_K_XL,9.15GiB,窗口砍到 32K,速度掉到 20.3。
模型越小跑得越欢,这条线在测试表里看得清清楚楚:
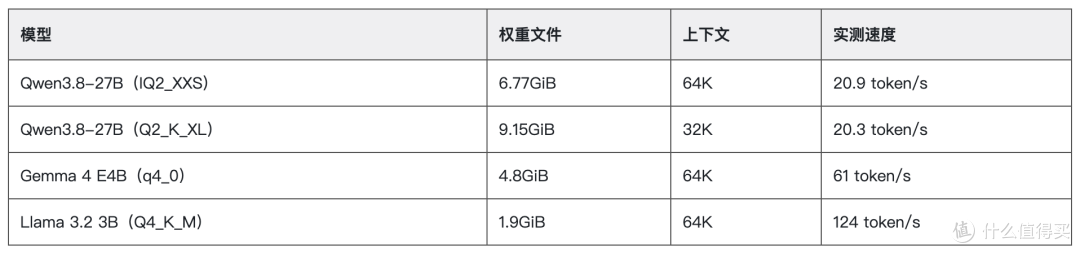
3B 的小模型轻松破百,27B 卡在 20 出头,这个分布不是巧合,它指向同一个解释。
决定出字速度的,是内存带宽
生成每一个 token,模型都要把全部权重从内存里读一遍,算出下一个字,再读一遍。所以速度的上限可以用一句除法估出来:内存带宽 ÷ 模型体积。
PS5 的 GDDR6 统一内存带宽是 448GB/s。6.77GiB 换算成 7.27GB,448 除以 7.27 约等于 61 token/s。实际跑出 20.9,是理论值的约三分之一,差额来自 KV 缓存读写、驱动层开销,以及 Vulkan 后端本身的效率损失。
小模型的对照更能说明问题。Llama 3.2 3B 的 1.9GiB 约合 2.0GB,理论上限 224 token/s,实测 124,效率接近 55%。模型越小,固定开销摊得越薄,所以占比更高。
这套估算法可以反复用:查设备的有效内存带宽,换算模型量化后的实际体积,两者相除得到理论速度,再乘三分之一到二分之一,就是你会摸到的真实值。它的适用边界也很清楚——只对逐字生成有效,读长 prompt 的预填充阶段走的是另一套账。
顺带解释另一件事:为什么早期纯 CPU 版本一分钟才一个 token。CPU 走系统内存通道,能用的 6GB 还要和其他部件抢,带宽只有几十 GB/s,路径也更长。换到 GPU 上,吃的就是那 448GB/s。
贴子里还有一张图更值得看:GPU 占用率 100%,CPU 只有 2%,风扇转速拉满,而整机 10.28 TFLOPS 的算力其实没被榨干。它在等内存把权重送过来,搬得慢,算得再快也只能排队。
20 个字每秒,够不够用
按中文折算,20.9 token/s 大约每秒二三十个字,比多数人的阅读速度快,聊天时几乎没有等待感。
但"跑得动"和"跑得好"是两件事。IQ2 是把权重压到 2 比特附近的极端量化,短问答还能撑住,长链推理、代码补全、多轮改稿这类活儿,出错率会明显上去。开发者自己也在帖子里展示了 32K 和 64K 两种上下文的取舍,上下文开得越大,留给 KV 缓存的余量越少。
还有几层代价,新闻里通常一笔带过。想跑原生 llama.cpp 得先越狱,主机和 PSN 账号都有被封的可能;越狱吃的正是特定系统版本的漏洞,一旦升级通常回不去;16GB 统一内存要和系统、图形显示一起分,模型一换大就装不下。
它能干的事其实挺明确:当一个离线实验台。接上局域网 8081 端口,用浏览器聊天,或者通过兼容 OpenAI、Anthropic 的接口让 Codex、Claude Code 这类工具连过来,跑一些不想联网的小任务。
这件事真正有意思的地方
我更在意的是它翻出来的硬件账本。
同样是十几 GB 统一内存,主机 APU 的带宽是 448GB/s,同价位的轻薄本用双通道 DDR5,带宽通常只有它的一半不到。这本来是游戏帧率逼出来的设计,现在被推理借走了。
llama.cpp 这类推理框架抹平硬件差异的进度,也比大多数人以为的快。一个 Vulkan 后端,就能让任何跑得动图形的 GPU 变成推理设备,不需要厂商配合写驱动、出 SDK。谁有带宽,谁就能上场。
本地推理的门槛正在换位置:从"你有没有一张好显卡",换成"你的带宽和容量装不装得下这个模型"。对普通人的影响是,手里那些被淘汰的旧设备,可能还有第二次被使用的机会。
机会有边界。主机没为长时间满载推理设计散热和电源,厂商也不会为越狱设备提供任何支持,稳定性全靠社区那群人。把它当实验室里的玩具可以,当生产工具不行。
两个容易看错的地方
第一个误区是"游戏机能跑 27B,显卡可以不用买了"。
这个说法有它的道理:16GB GDDR6、448GB/s 带宽,纸面上确实接近一些入门独显,三千多块的整机价格也比一张中端显卡便宜。
但它解释不了一个关键差别:量化等级。显卡跑 27B 通常用 Q4 量化,权重在 15GB 上下,质量损失可控;PS5 只能退到 IQ2,权重压到 6.77GiB,省下的体积是从模型质量里抠出来的。同样叫 27B,出来的东西并不在一个水平上。
更准确的理解是,它是一个"能出字"的下限演示,不是"能干活"的生产力工具。
第二个误区是"算力越强,出字越快"。
这也有一半对。你发一段长 prompt 进去,模型要在预填充阶段把整段话算一遍,这一段确实吃算力,TFLOPS 高的机器明显更快。
可逐字生成阶段是另一套逻辑,瓶颈在带宽。PS5 的 GPU 之所以占用 100%、速度却上不去,是因为它在等数据,不是在算。想判断一台设备能不能跑某个模型,拿带宽除以模型体积,比盯着 TFLOPS 靠谱。
顺便算一笔电费
按 20.9 token/s 算,一百万 token 要跑 13 个多小时。PS5 满载功耗按 200 瓦上下估,这段时间大约 2.7 度电,按 0.6 元一度,成本一块六。
同期调用能跑 27B 级别模型的云 API,一百万 token 的价格也在个位数到十几元这个区间。省钱并不是这件事的理由。
真正值钱的,是断网也能用、数据不出门、不用排队等额度这三样。前提是你愿意接受风扇声、机身发热、账号封禁和反复折腾。
如果你家里正好躺着一台不玩的 PS5,我建议先做一件事:查清楚它的系统版本和越狱工具的适配情况,再决定动不动手。越狱吃的就是版本漏洞,升上去大概率回不来。
你更愿意把旧设备改成自己的实验台,还是按月付钱用云服务?
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~








校验提示文案
校验提示文案