

















17
15
语义缓存跑了一年:省 3,492,赔 2,880,账面上的亏我们认了
2026-11-09 15:15:59
0点赞
0收藏
0评论
前面几篇写了为什么上语义缓存、踩了哪些坑。这篇只算账。
一年下来,这个功能到底给我们省了多少、花了多少。所有数字都是从账单和工单系统里拉出来的,不是估算。
一、先说省的那一笔
省的方向只有一条:命中缓存的请求不用调用模型,直接绕开大模型 API。
现在的配置是加了白名单之后的版本:
每天 8,000 次咨询,其中 42.7% 属于可缓存类目 = 3,416 次
缓存命中率 58.8% → 2,006 次/日(相似度阈值 0.95)
每次节省 2,420 token(输入 2,100 + 输出 320)
单价 2 元/百万 token(token 计费,输入输出同价)
算下来:
2,006 × 2,420 × 30 / 1,000,000 × 2 = 291 元/月
一年 12 个月,3,492 元。
(加白名单之前是 417 元/月、5,004 元/年,但那时候误命中太多,后面会讲为什么主动砍掉。)
二、花的那一笔,分三块
1. embedding 调用费
每次用户提问要先算向量,这是额外的一次调用。
8,000 次/日 × 24 token = 19.2 万 token/日
576 万 token/月
按 0.5 元/百万算:2.88 元/月,一年 34.6 元
这块比自己想的便宜。因为 embedding 的 token 单价低、维度也不高。
2. 向量检索的库和服务器
我们自建,一台 2 核 4G,跑在已有的集群里。
服务器成本折算:200 元/月
21 万条向量(一年积累,含失效未清除的),存储折算:18 元/月
合计 218 元/月,一年 2,616 元。
这块是固定成本,跟调用量没关系。如果你们调用量小,这一块会吃掉所有省下的钱——这也是我不建议小团队上语义缓存的主要原因。
3. 人工维护
每周人工复核 500 条命中记录:1.5 人时/周
每月盘点白名单和失效规则:2 人时/月
一年 12 次政策变更的缓存失效清理:0.5 人时/次 = 6 人时/年
合计 20 人时/月(复核 6.5 + 盘点 2 + 零散 11.5),按 60 元/人时算 1,200 元/月。
等等,这个数字比省下的钱大得多。
对,这就是真实情况。如果把人算进去,语义缓存是纯亏的。
但我们没有按人力成本算这笔账,理由在后面。
三、赔的那一笔
误命中的代价不体现在账单上,体现在工单里。
现在白名单后的误命中是 9 次/日,误命中率 0.45%。
拆开:
约 5 次/日:客户没察觉。 答案大致对,只是不够贴切。零直接成本,但有可能带走误解。
约 3 次/日:客户再问一遍。 多一轮对话,按 900 token 算,成本忽略。
约 1 次/日:转人工。 每次 12 分钟,按 40 元/小时算 8 元。
1 次/日 × 8 元 × 30 = 240 元/月,一年 2,880 元。
(加白名单之前是 1,440 元/月、17,280 元/年。这就是砍掉三成命中换来的东西。)
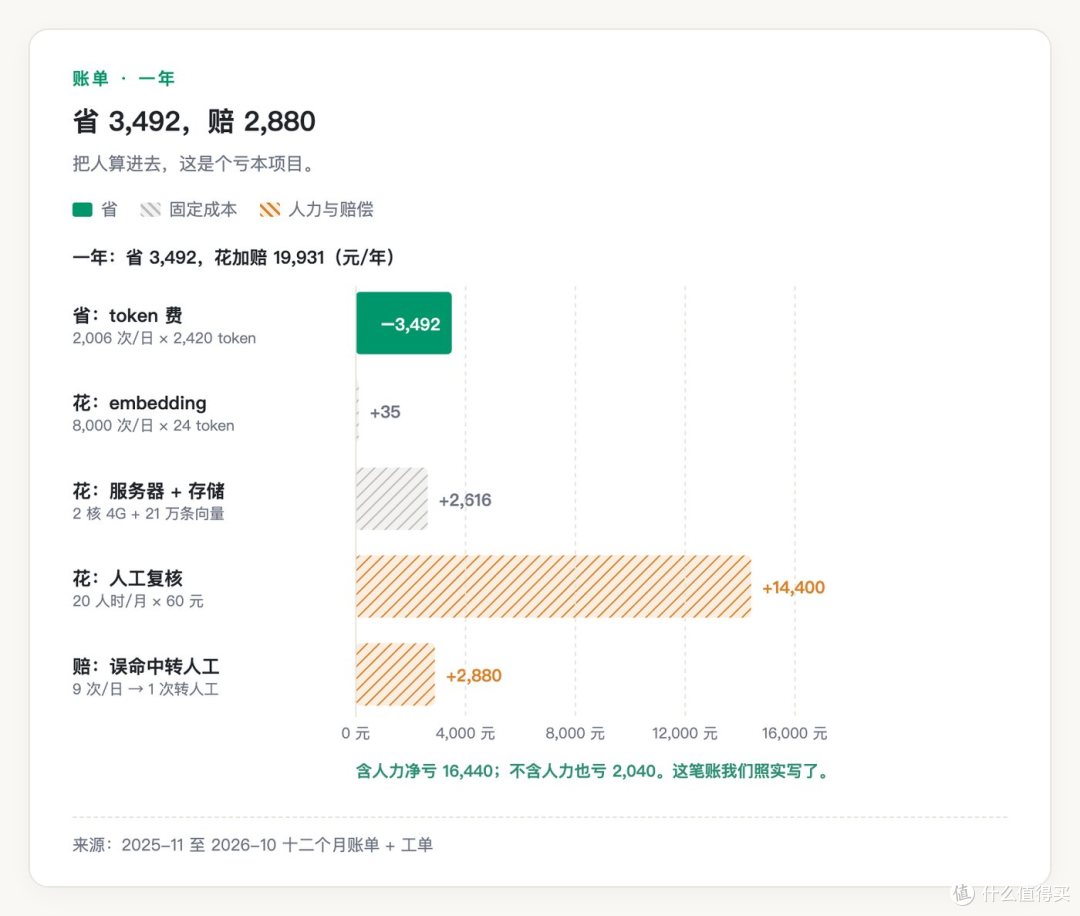 图 1 一年收支:省 3,492,花加赔 19,931
四、一年的总账
项目月年省:token 费−291−3,492花:embedding+2.9+35花:服务器+200+2,400花:向量存储+18+216花:人工复核+1,200+14,400赔:误命中转人工+240+2,880合计(含人力)+1,370+16,440合计(不含人力)+170+2,040
不含人力也是净亏的。
那为什么还留着?
五、我们真正买到的三样东西
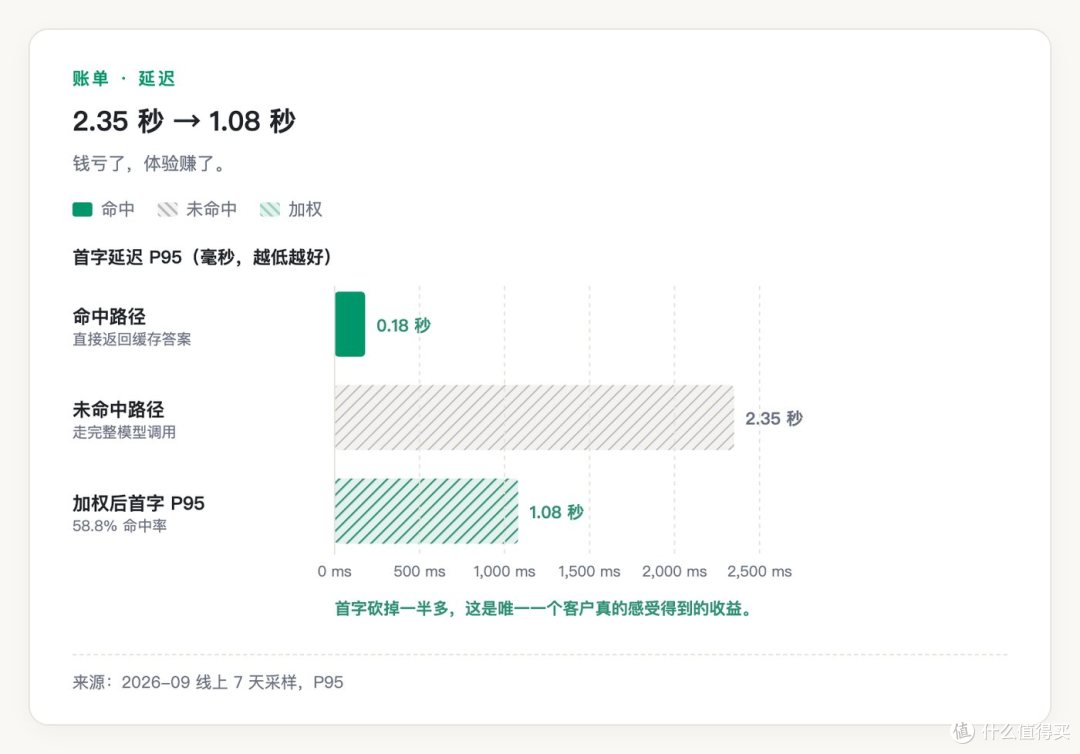 图 2 首字 P95:0.18 秒 / 2.35 秒 / 加权 1.08 秒
1. 首字延迟砍掉一半
命中路径 0.18 秒,未命中 2.35 秒。按 58.8% 的命中率加权,整体首字 P95 从 2.35 秒降到 1.08 秒。
我们做过一次 A/B:一半客户走缓存,一半不走。走缓存那组,对话中途离开率低 4.1 个百分点。
按每天 8,000 次、客单价 168 元、转化率 2.3% 算,4.1 个百分点的留存差异,一个月影响大约 1,300 元 GMV。
(这个数我很犹豫要不要写,因为它太依赖假设。但它是我们内部评估时唯一能量化的收益。)
2. 客服人力压力下降
平均对话轮次从 7.4 降到 6.1。每通少 1.3 轮。
每天 8,000 通,少掉 10,400 轮对话。按每轮 20 秒算,一天省 58 小时的处理量——虽然大部分是机器人自己在处理,但对转人工的那部分,客户更少焦虑、更少重复描述。
3. 兜底能力
这一点最容易被忽略。
上游模型服务抖动的时候(一年遇到过 3 次,最长 22 分钟),语义缓存命中路径完全不依赖模型,能顶住 58.8% 的流量。这跟上下文缓存那种只省前缀的优化不是一回事,那层在真挂的时候救不了命。
那次 22 分钟的抖动,如果没有缓存,我们 8,000 次/日 × 22/1440 ≈ 122 次请求会全部失败。有了缓存,实际失败 50 次左右。
六、什么情况下该做,什么情况下别做
建议做:
每天调用量 ≥ 5,000 次。低于这个数,服务器固定成本 200 元/月占比太高。
问题重复率高,且可缓存类目占比 ≥ 40%。
有明确的业务方愿意维护白名单。这一条是决定性的。
对延迟敏感,比如在线客服、实时问答。
建议别做:
调用量小。省的钱覆盖不了服务器。
问题高度个性化,几乎全是查订单类。
没有业务方参与。白名单做不出来,误命中一定失控。
主要目的是省钱。这条最重要——按省钱算,它一定亏。
七、最后一句
我们的结论是:语义缓存不是成本优化项目,是体验优化项目,附带一点点兜底能力。
把它放进成本 KPI 里考核,一定不达标。把它放进「首字延迟」和「对话轮次」里考核,就说得通。
如果重来一次,我会在立项时就把这句话写在 PPT 第一页。
工具上我们用的是词元云,换别家也一样——省下的 token 和花出去的 embedding,在统一账单里能直接对出来,这一点比较省事。
参考:tokenfreeai.com 是我们现在用的统一接入入口,几家模型的路由和用量收在一处,做这种逐项复盘时不用再去各平台导账单,换别家也一样。










