








6
20
学生党每月 30 块用上长文本模型:我把一份真实账单拆给你看
2026-10-29 16:24:35
0点赞
0收藏
0评论
先说钱:我这个月在大模型上花了 27 块 4 毛。
不是我抠,是上个月花了一百六,觉得不对劲,就把账单拆开看了一遍。拆完发现,钱不是花在"用 AI"上,是花在"不会用"上。
这篇文章写给三类人:写论文的研究生、要读大量资料的自媒体、想接 AI 进自己工具的学生开发者。不讲原理,只讲怎么把账压下来。
先说我踩的三个坑,每一个都在烧钱
坑一:同时订了四家的会员。
Kimi、通义、DeepSeek、还有一个做图的,一个月加起来一百多。实际统计了一下,七成的使用集中在 Kimi(读论文),两成在通义(问日常问题),DeepSeek 那个月只开了两次。
订阅制的可怕之处就在这:不用的也照扣。四个会员里有两个是"备着",备了半年。
坑二:以为"会员"能覆盖 API。
我一开始用 App 里的会员,后来想在 Cursor 里用,才发现在 App 里付的钱在 API 上一分不算。这两套计费是分开的。等于我又开了一份支出。
坑三:把整个 PDF 反复上传。
这个最贵。我第一次用的时候,习惯性每问一个问题就重新上传一次 PDF。问十个问题,就是读了十遍同一篇论文。
改法一:把"会员"换成"按量"
做出这个决定之前我算了一笔账。
一个学术会员一个月 30 到 50,官方 API 按量算,我这种用量一个月 10 到 20。原因很简单:我一天真正需要问的问题就那么几个,多数时候是"这段话什么意思""这个方法和我看到的另一篇有什么不同"。
按量计费的好处是把"备着"这个成本去掉了。不用就不花钱,用一次几分钱。
坏处是心里没底。所以我加了第二件事。
改法二:一篇论文只上传一次,然后连续问
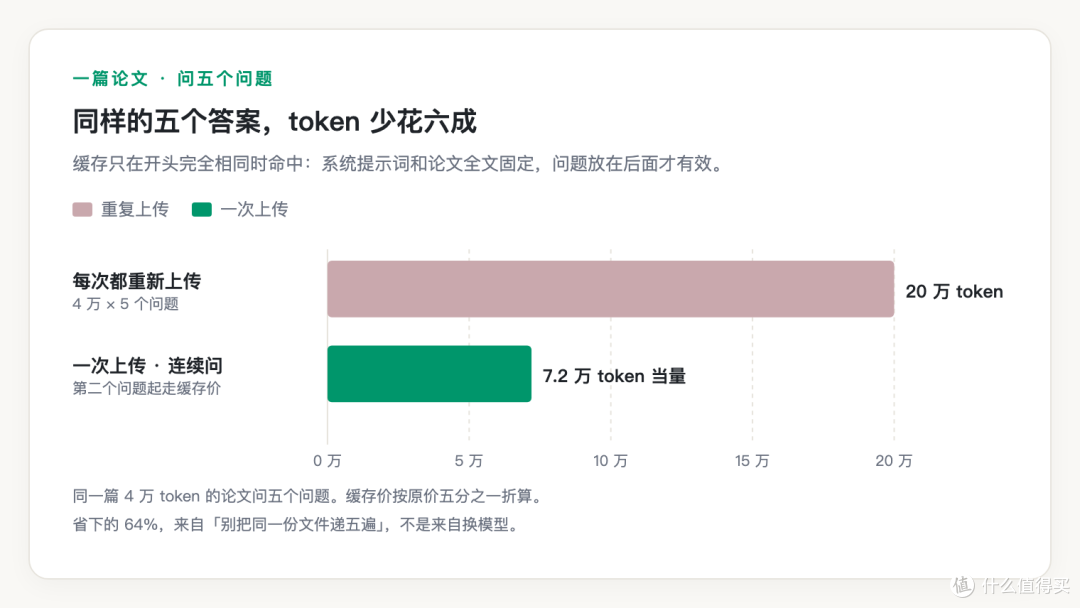 图 2 同一篇论文问五个问题的 token 对比
lieflat F5 水平条形图图 2 同一篇论文问五个问题的 token 对比下载原图
这一条能省一半以上的钱。
大模型 API 按 token 收费,token 是"你递给它的内容量"。同一篇论文(假设 4 万 token),你问五个问题:
每次重新上传:4 万 × 5 = 20 万 token 的输入
一次上传、连续追问:第一问 4 万,后面四问如果缓存命中,按便宜的价算
Kimi 的缓存是这样的:如果你每次请求的开头(系统提示词 + 论文全文)完全一样,后面的问题不同,第二次开始算缓存命中。缓存价是原价的五分之一。
我实测下来,一篇论文连着问五个问题,比每个问题单独开一次对话便宜 60% 到 70%。
注意两个细节:
不要在开头加"今天是几号"这种每次都变的话。 一变,缓存全废。
缓存有存活时间。 Kimi 默认是 5 分钟,所以连着问才有用,隔一小时再问就重新算了。
改法三:贵的模型只用在"真的要它想"的问题上
这是我这个月发现的第三个省钱点,也是最反直觉的一个。
读论文的时候,问题其实分两种:
定位型:"这篇论文的数据集是哪个?""作者用的 baseline 是什么?"——答案在文里,需要的是找得准,不需要推理。
分析型:"这个方法和另一篇的差别在哪?""如果我把样本量减半,结论还成立吗?"——需要模型真的想。
第一种用中等模型完全够,第二种才值得上贵的。
我一开始所有问题都丢给最贵的那个,一个月多花了几十。分区之后,花费掉到原来的六成,答案质量感觉不出来区别。
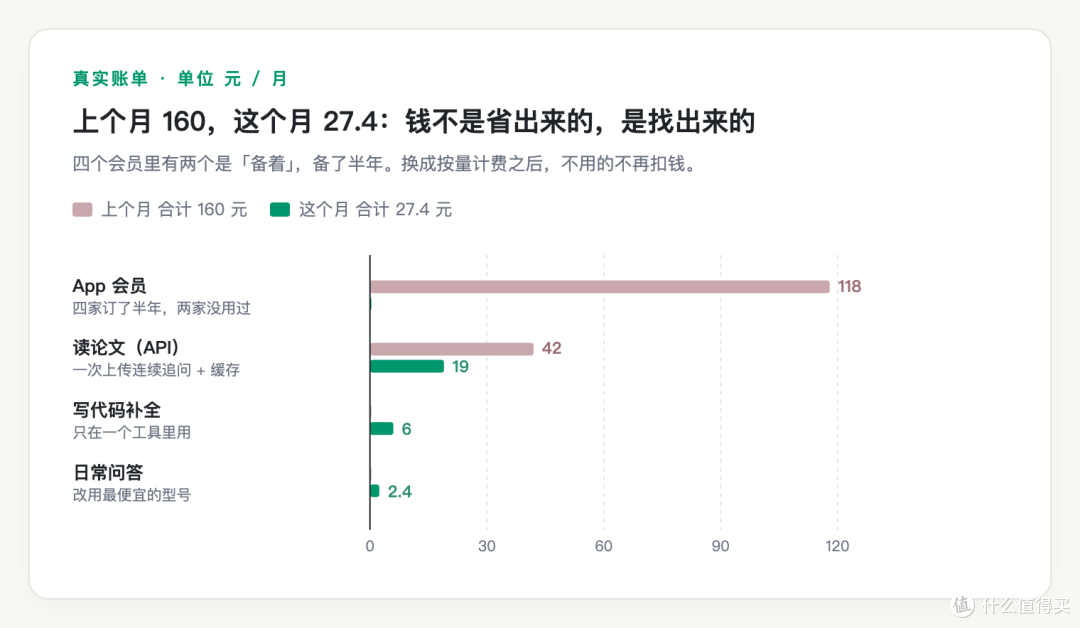 图 1 四类支出:上月 160 元 vs 本月 27.4 元
lieflat F5 双向条形图图 1 四类支出:上月 160 元 vs 本月 27.4 元下载原图
我的真实账单
项目上个月这个月怎么降的App 会员118 元0全部退订,改成按量读论文(API)42 元19 元一次上传连续追问 + 缓存写代码补全06 元只在这一个工具里用日常问答包含在会员里2.4 元用最便宜的型号合计160 元27.4 元
不是省出来的,是把三笔冤枉钱找出来了:没用的会员、重复上传、用错档位。
那 30 块到底怎么花(具体操作)
如果你想复制这个方案,步骤是这样的。
第一步,先想清楚你主要在干什么。 读论文、写代码、做图、日常问答,选一个最主要的。一个场景一个工具,别贪多。
第二步,拿一个 key。 如果你要在工具里用(Cursor、Dify、Cherry Studio 之类),需要 API 的 key。官方渠道要注册实名,几家就是几套流程。图省事的话可以用统一接口,一个 key 接多家,切模型改一个字段——我用的词元云(https://tokenfreeai.com)就是这个路子,充 30 块能用挺久。
第三步,先充最小额。 别一次充一百。充 30,跑两周,看用量再决定。
第四步,把便宜型号设成默认。 只在"真的需要想"的时候手动切贵的。
第五步,控制住"每次重新上传"的手。 一个文档一次对话,在里面连续追问。
30 块能干多少事,换算一下
按我这个月的实际用量:
一篇 40 页的论文,完整读一遍加问七八个问题,大约 1 块 5
一天读三篇,一个月 90 篇,大约 40 块——超预算了,所以我没有每天读三篇
写代码补全,一天几百次小请求,一个月 6 块(这种短请求单价极低)
日常问答,一个月 2 块多
结论:30 块够一个研究生正常读论文 + 偶尔写代码,前提是一次上传连续追问。
如果你的量更大,比如要读 500 页的书、要批量处理几十篇文献,那 30 不够,得按 100 到 200 准备。但那是"业务量",不是"日常用"。
有几个坑要提前说
别买"无限次"的会员。 这种通常是 App 侧的限制版,API 用不了,而且算力高峰期会排队。
别一次充太多。 平台会调价,模型会下线。充多了用不完是沉没成本。
便宜模型不是万能的。 我试过用最便宜的读一篇方法论很绕的论文,它的回答确实流于表面。该花的钱还是得花。
注意计费单位。 所有价格都是"元/百万 token",不是"元/次"。看到"0.5 元"要问清楚是每百万还是每次。
最后一句
省钱这件事,省的不是那点 token 钱,是"用了不心疼"这个心理门槛。
我以前不敢问,怕问一次几毛钱。现在知道一次几分钱,问得就随意多了。AI 这种东西,用得越多越有用,用得越少越显得鸡肋。
30 块买到的是这个自由,不是算力。
附:我自己在用的三套提问模板
省钱省到最后,省的是"少问几次"。问得好,一次顶三次。
读论文,第一问:
你面前是一篇论文。请只根据原文回答,不要补充你的知识。用下面四段输出:1)它要解决什么问题;2)它的方法核心是哪三步;3)实验里最强的对比对象是谁,强在哪;4)作者自己承认的局限是什么。每一条都标出原文所在的小节名。
这个模板的好处是"不要补充你的知识"这一句。不加这句,模型会自作主张地给你一堆背景,那些不是论文里的,读起来像论文,实际是它编的。
读论文,追问:
第 3 节里提到的那个指标,和表 2 里的数据对得上吗?如果对不上,差额是多少?
这种"对账式"的问题特别能检验它是不是真的读了。模型如果没读,会顺着你的话编;读了的话,它会指出表里到底是哪个数。
读不懂某一段:
把这一段原文贴在这里。请用高中生能听懂的话解释,不要用比喻,不要举别的例子,只解释这一段在说什么。
加"不要用比喻"是因为模型很爱打比方,比方打多了你就更糊涂了。
写代码:
我要实现 XXX。先不要写代码,先用三句话说明你的思路和你会用到哪个库。等我确认后再写。
这一步能省掉大量返工。模型一上来就写两百行,你看着不对再让它改,来回三轮,token 白烧。
附:我怎么判断"这个钱花得值"
省钱不是目标,省钱之后还敢用才是。
我给自己定了一个很土的判断标准:这个月我从 AI 那里拿到的、能直接用的东西,值不值这 30 块。
这个月的清单:改完了一段自己写不顺的方法论综述、读懂了三个不熟的统计方法、把一段跑不通的代码调通了、写了两篇稿子的初稿。值。
上个月虽然花了一百六,但清单上只有两三条,因为大部分钱花在"备着但没用"的会员上。
所以真正的敌人不是价格,是沉默的成本:自动续费、买了不用、重复上传、档位用错。这四个加起来,比任何一次"贵一点的调用"都贵。
附:如果你也想退订,怎么退才不慌
先别急着全退。
我当时的做法是:把四个会员全部退掉,然后只留一个按量的 key,用两周。两周之后回头看,有没有哪件事因为退订做不了了?
答案是没有。Kimi 的 App 免费版也能聊天,我真正需要的是"读长文档"和"接进工具"这两件事,这两件按量都能做,而且更便宜。
这个测试方法的通用版本是:任何订阅,先停一个月,看你会不会想它。 想了,说明是真需求;没想,那就是自动续费在替你做决定。
对学生来说,这一个月可能就是一顿饭钱。但对"我到底需要什么"这件事的认知,比省下的钱值钱。