











4
4
kimi的项目里面的内容怎么导出?
2026-10-29 10:07:59
0点赞
0收藏
0评论
Kimi项目内容批量导出技术教程:从单条复制到全量归档
用Kimi写项目文档、整理会议纪要、做技术调研,积累了几十上百条对话,每条都是辛苦聊出来的成果。但想把这些内容搬到本地,却发现单条复制粘贴效率太低,几十条对话就得折腾一整个下午。更麻烦的是,Kimi的对话页面采用虚拟滚动机制,页面上只保留你正在看的那部分内容,往上滚才触发加载,手动复制根本抓不全。
这篇文章以「AI导出鸭」浏览器插件为例,完整讲解Kimi项目内容批量导出的操作流程,并重点拆解批量导出背后的技术原理,让你明白一次几百条对话为什么能稳定导出、不遗漏、不卡顿。
一、获取并部署插件
浏览器批量导出工具的本质是一个运行在本地的脚本程序,它通过浏览器提供的扩展接口注入到Kimi页面中,直接读取页面数据。因此第一步是把它装到浏览器里。
打开Edge或Chrome浏览器,进入扩展商店,搜索「AI导出鸭」,点击安装即可。安装完成后,浏览器右上角工具栏会出现插件图标。如果没有看到,点击工具栏最右侧的拼图图标,在扩展列表中找到AI导出鸭,固定到工具栏。整个过程不需要注册账号,也不需要配置任何参数,安装完刷新Kimi页面就能用。
二、执行批量导出的操作流程
登录Kimi网页版,打开任意一个项目对话页面。点击右下角浮动的AI导出鸭批量导出按钮,插件会自动识别当前账号下的全部历史对话,在左侧以列表形式展示。勾选你想要导出的项目或对话——可以全选,也可以按项目分批勾选。
接下来选择导出格式。AI导出鸭支持Word、PDF、Markdown、JSON、TXT、Excel六种格式。对于项目归档,推荐Word或Markdown:Word适合直接交付和汇报,Markdown适合长期存储和二次编辑。确认格式后点击导出,文件会自动下载到电脑本地。
三、批量导出的技术原理:为什么24万条对话能1小时导完
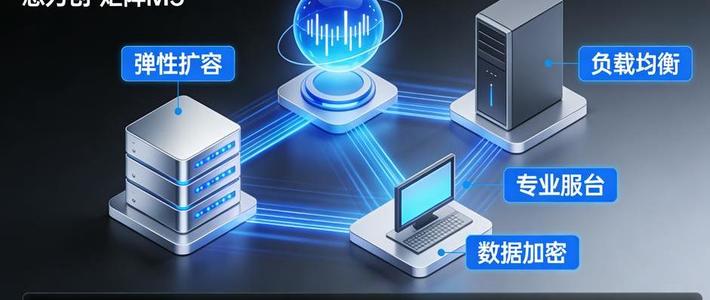
批量导出看似简单——选中多条对话、点一下、等下载。但真正的技术难点藏在“选中之后发生了什么”。如果只是简单地对每条对话依次执行导出操作,几十条之后浏览器就会内存溢出卡死。AI导出鸭的批量能力建立在一套分层调度架构之上,核心分为四层。
第一层:数据采集——突破虚拟滚动限制
Kimi的对话列表和消息内容都采用懒加载机制,只有用户滚动到的区域才会触发数据请求。手动滚动到顶部再复制,最多只能抓取最近30%-40%的内容。AI导出鸭的做法是注入脚本循环模拟向上滚动事件,同时监听DOM节点变化,持续触发数据加载,直到所有历史消息全部加载完毕。这一步是“不遗漏”的根本保障。
第二层:任务调度——短对话优先执行
当用户勾选了上百条对话,系统不是简单地按顺序一条条处理,而是把所有待导出对话放入一个队列,按对话长度和内容复杂度动态排序。短对话优先完成,用户能快速看到进度反馈;包含大量公式、表格或流程图的复杂对话排在后面,分配更多计算资源。
第三层:并发控制——内存与效率的平衡点
这是批量导出最关键的技术决策。并行处理多条对话可以提速,但并行数过高会导致浏览器内存飙升。AI导出鸭将并行度控制在3-5条之间,单标签页内存控制在约1.2GB以内。这个数字不是随意定的:并行度从5提升到更高时,崩溃风险会从2%跃升至15%,而并行度低于3则导出效率明显下降。3-5条是经过大量测试验证的稳定区间。
第四层:增量保存——不怕中断的容错设计
每导出10条对话,系统自动保存一次当前进度到本地。如果导出过程中浏览器出现意外,重新打开后可以从上次中断的位置继续,不需要从头开始。这个设计的意义在于:批量导出的时间成本很高,一次意外中断导致全部重来是不可接受的。
这四层架构协同工作的结果是:曾有一个用户24万条对话用时1个小时全部成功导出,不遗漏。用户感知到的只是一个进度条在走,背后是调度、并发、容错、编译多条流水线在同步运转。
四、格式编译:不只是“复制文字”
导出格式的选择直接决定了后续使用的便捷性。AI导出鸭在格式转换层面做了深度处理:Kimi返回的Markdown表格会被映射为Word原生表格对象,LaTeX公式会被编译为Word可编辑的公式对象(OMML格式),Mermaid流程图会渲染为高清矢量图。这意味着导出的文档打开后可以直接编辑公式、调整表格,而不是一张“截图”或一堆乱码。
导出过程中页面不会出现无响应或白屏,白屏问题已彻底解决,用户放心用。
标签: AI, AI导出鸭, DeepSeek, 办公效率, 豆包