








8
25
谷歌Gemini 4 Carbon登顶全球第一:第一批能用上的人不是你
2026-10-30 03:29:04
1点赞
1收藏
0评论
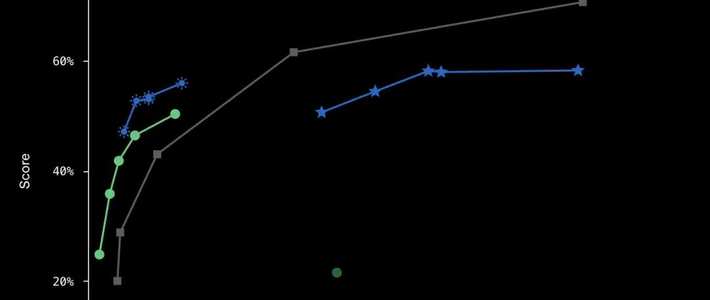
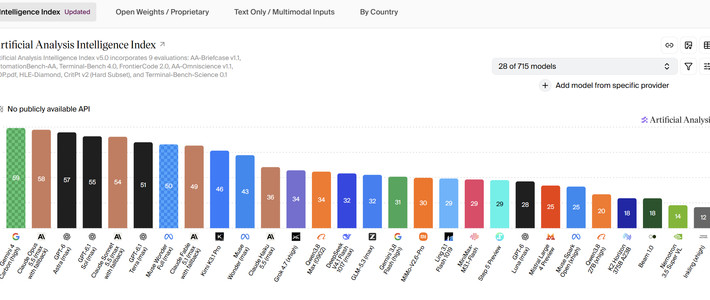
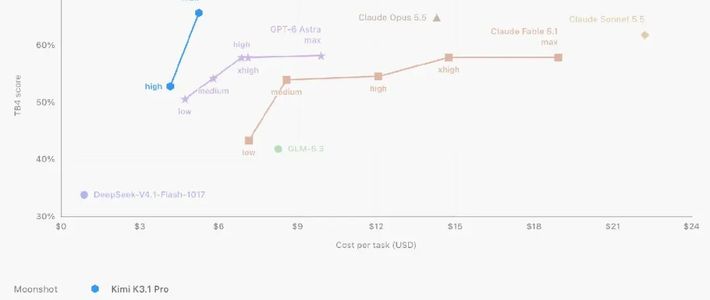
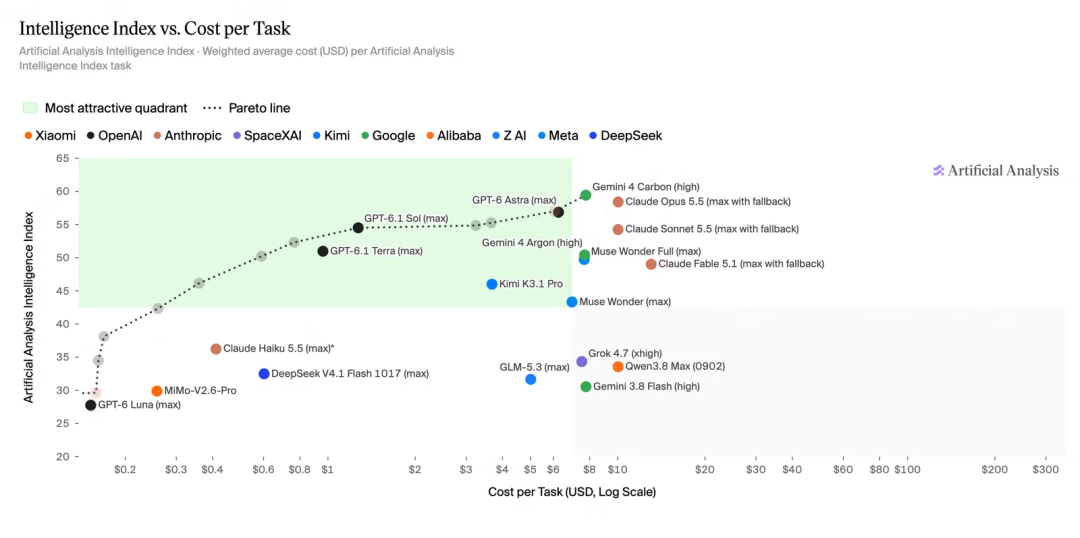
10月28号,谷歌发布了新的旗舰模型Gemini 4 Carbon,在第三方机构Artificial Analysis的新版智能指数上拿了59分,登顶第一,压过了Claude Opus 5.5的58分和GPT-6 Astra。
反常的是它先开给谁用。第一批拿到权限的,不是掏钱最痛快的开发者,也不是像你和我这种等着尝鲜的普通用户,是一小批网络安全防守人员。普通人排在队伍的末尾,队号还没发。
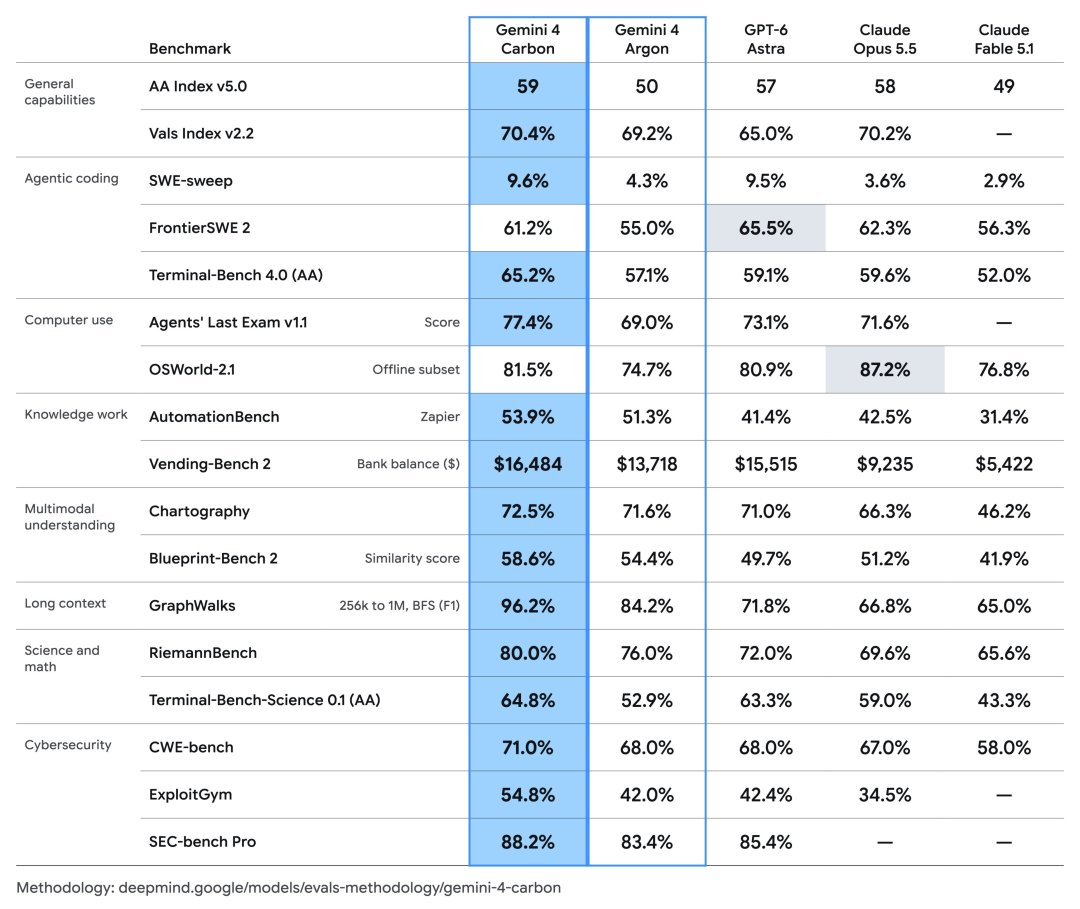
为什么是这个顺序,拆开看就明白了。谷歌给自己的定位是最强模型,具备最先进的网络安全和长程任务能力。谷歌自己公布的评测成绩里,它能在真实软件里找出隐藏的漏洞,准确率88.2%,能判断一个漏洞是不是真的可以被利用,还能把问题修到根因上。另一项专项评测里,间接提示注入攻击被它全部拦了下来,也就是网页和文件里藏的指令骗不动它,上一代Argon还漏了0.7%。
这个能力越强,越不能先撒给所有人。发现漏洞和利用漏洞,是同一套推理能力的两个方向,防守方可以拿它排修复的优先级,攻击方同样可以拿它挑目标。所以谷歌把第一批权限只开给了安全防守人员,再通过Fairwind计划逐步扩大到受信任的伙伴,公开API暂时没有,开发者、企业和普通用户什么时候能用没给时间表,甚至把模型送进了美国政府的预发布测试。
发布方式本身已经说明一件事。这一代顶级模型,开始接手会出事的活儿了。
那第一本身,成色怎么样?
不差,但没到全面。
同一家机构的代码智能体榜上,Claude Code配Opus 5.5拿62分,Carbon配谷歌自家工具是59分,还差半步;用户投票的网站制作榜上,它排第4;办公任务榜上,压在它前面的是Kimi K3.1 Pro这些熟悉的名字。知识问答它答对的更多,幻觉率11%,比同口径下两个头部对手的50%低了一大截,但比上一代Argon的4%高。当然这是那套知识题的口径,不能等同于日常聊天出错的概率,可答得更多和编得更多同时发生,值得记一笔。
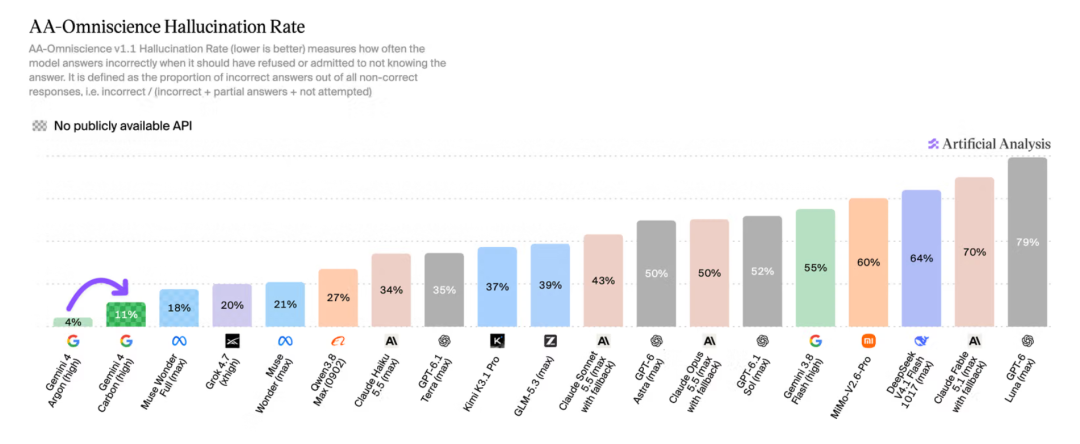
综合第一是真的,但落到具体的活儿上,每个分项都还有人站在它前面。
价格才是真正狠的部分。Carbon首发期延续上一代的半价促销,输入每百万token收2美元,输出10美元,正好是Opus 5.5标价的一半,缓存命中的输入更是低到0.2美元。促销结束后输入输出都翻回一倍,回到和对手同一水平线,谷歌没给促销的截止日期。按Artificial Analysis的测算,Carbon每个评测任务的平均费用比Opus 5.5 Max低大约23%。榜一模型把价格砍半,压力就传到了Anthropic和OpenAI那边,最后会变成你手里AI工具更便宜的价钱。这种仗,打得越凶越好。
价格战打到你手里之前,先泼一盆冷水。Carbon眼下普通人碰不到,没有任何公开入口,谷歌倒是放了话,正在给10亿级用户做精简版,但没给日期。也正因为这样,网上一批所谓“国内直达、免费镜像、免登录入口”已经冒出来了。有人整理上一代Argon的使用渠道时专门提醒过,这类入口大多不是原生模型,有的是套壳骗人,有的顺手把你的对话记录、上传的文件甚至API Key都带走。合同、报价单、家里老人的身份信息,别喂给这种入口。再想尝鲜,也别急着掏钱,更别急着交资料。
谷歌这次把最强的模型先交给了防事故的人,把想尝鲜的人排在了最后。顺序有点反常,做法没毛病。轮到你能用之前,要做的就一件事,盯住官方入口什么时候开,在那之前,别让那些假镜像先碰到你的资料。
内容由AI生成