










12
11
开源大模型进入“轻量化混战”,本地部署门槛大幅下降
2026-09-18 22:22:13
0点赞
0收藏
0评论
导语
2026年AI行业的一大明显变化:不再只比拼万亿参数巨型模型,轻量化开源大模型成为新战场。过去本地跑大模型,需要高端显卡、大容量内存;如今7B、14B、34B轻量化模型不断迭代,量化技术持续突破,普通PC、Mac、高端手机都能流畅本地运行,普通人也能拥有属于自己的离线AI。
一、什么是轻量化开源大模型
轻量化大模型,不是简单粗暴缩减参数,而是通过模型剪枝、量化、蒸馏等技术,在尽量保留核心推理、创作、代码能力的前提下,缩小模型体积、降低内存占用。
- 量化:把模型权重从FP16压缩到INT8、INT4,体积直接减半甚至压缩到1/4,算力消耗大幅降低。
- 蒸馏:用巨型大模型作为老师,训练小型模型学习它的回答逻辑,用小模型复刻大模型的能力。
开源意味着模型权重对外公开,任何人可以下载、本地部署、微调,不受云端平台的API限制,数据全部留在本机。
二、当前主流轻量化模型阵营
1. 国内开源系列
Qwen、Llama3的国产衍生版本、DeepSeek轻量化版本持续更新。Qwen3推出4B、8B、14B版本,中文理解、代码、长文本能力很强,对macOS、Windows适配完善,Ollama一键部署。适合文档问答、RAG知识库、文案写作。
2. 海外主流
Llama 3.1轻量化版本、Mistral系列,推理速度快,上下文窗口长,适合英文任务、代码生成。
3. 端侧专用小模型
专门针对手机、平板优化的1B~3B模型,占用内存极低,嵌入手机系统,实现屏幕理解、摘要、翻译离线运行,也就是前面提到的端侧AI智能体底层基础。
三、轻量化模型带来的三大改变
1. 硬件门槛断崖式下降
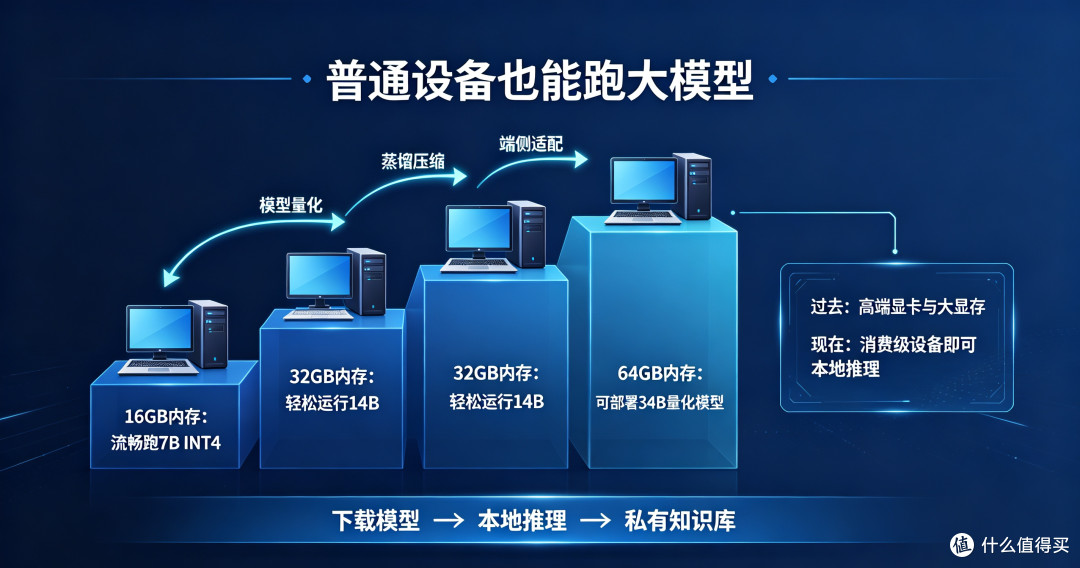
几年前,想要本地跑大模型,至少需要高端N卡,几十GB显存。现在:
- 16GB内存PC/Mac:流畅跑7B INT4量化模型
- 32GB内存:14B模型轻松运行
- 64GB内存:34B量化模型可本地部署
普通爱好者不用租赁昂贵云算力,在家就能搭建私有AI知识库,把自己的笔记、文档、资料导入RAG,打造私人AI助手。
2. 隐私自主权提升
所有问答、文档解析都在本地设备完成,数据不上传第三方服务器。企业、工作室可以部署私有轻量化模型,处理合同、客户资料,规避云端数据泄露风险。
3. AI应用开发成本降低
开发者可以基于轻量化开源模型微调,打造垂直领域模型,比如法律文本、医疗科普、工业质检、电商客服,不用从零训练大模型,大幅降低开发成本。
四、轻量化模型的短板,理性看待
❌ 能力上限弱于千亿级大模型:复杂逻辑推理、超长数学计算、多步骤深度科研任务,和云端巨型模型存在差距。
❌ 量化会带来精度损失:压缩程度越高,回答幻觉概率越高,INT4适合日常使用,高精度专业场景建议INT8。
❌ 上手仍有学习成本:虽然Ollama、LM Studio简化操作,但想要搭建RAG知识库、微调模型,依旧需要基础电脑知识。
❌ 微调需要内存:简单LoRA微调,依然需要较大内存,普通笔记本很难做大批量微调。
五、普通人怎么选轻量化开源模型
1. 普通用户,只想本地聊天、总结文档:优先Qwen3 8B,中文体验最好,一键部署。
2. 需要写代码:DeepSeek 8B代码版本。
3. 手机端离线使用:1B~3B端侧小模型。
4. 企业私有知识库:14B~34B量化模型,搭配RAG向量库。
六、行业趋势总结
AI赛道不再是“越大越好”。巨型大模型主攻云端高难度专业任务;轻量化开源模型负责本地、隐私、低成本场景。
软硬件双向适配,PC、Mac、手机芯片厂商持续优化NPU,未来本地运行开源模型会像安装软件一样简单。开源轻量化模型,会加速AI下沉,让AI从付费云端服务,变成每个人设备里的本地工具。










