








 深耕AI、数码兴趣领域


65
62
今日AI圈值得关注的动态 2026年9月14日
2026-09-14 09:24:25
0点赞
0收藏
1评论
周末加今天周一,AI 这边的新闻密度依旧不低。我挑了 10 条自己觉得比较有信息量的,按主题理顺了,每条都附了出处链接,方便大家自己点进去溯源核对。不保证全,但应该能省你刷一天消息流的时间。
DeepSeek 开始“开口说话”了,语音对话灰度上线
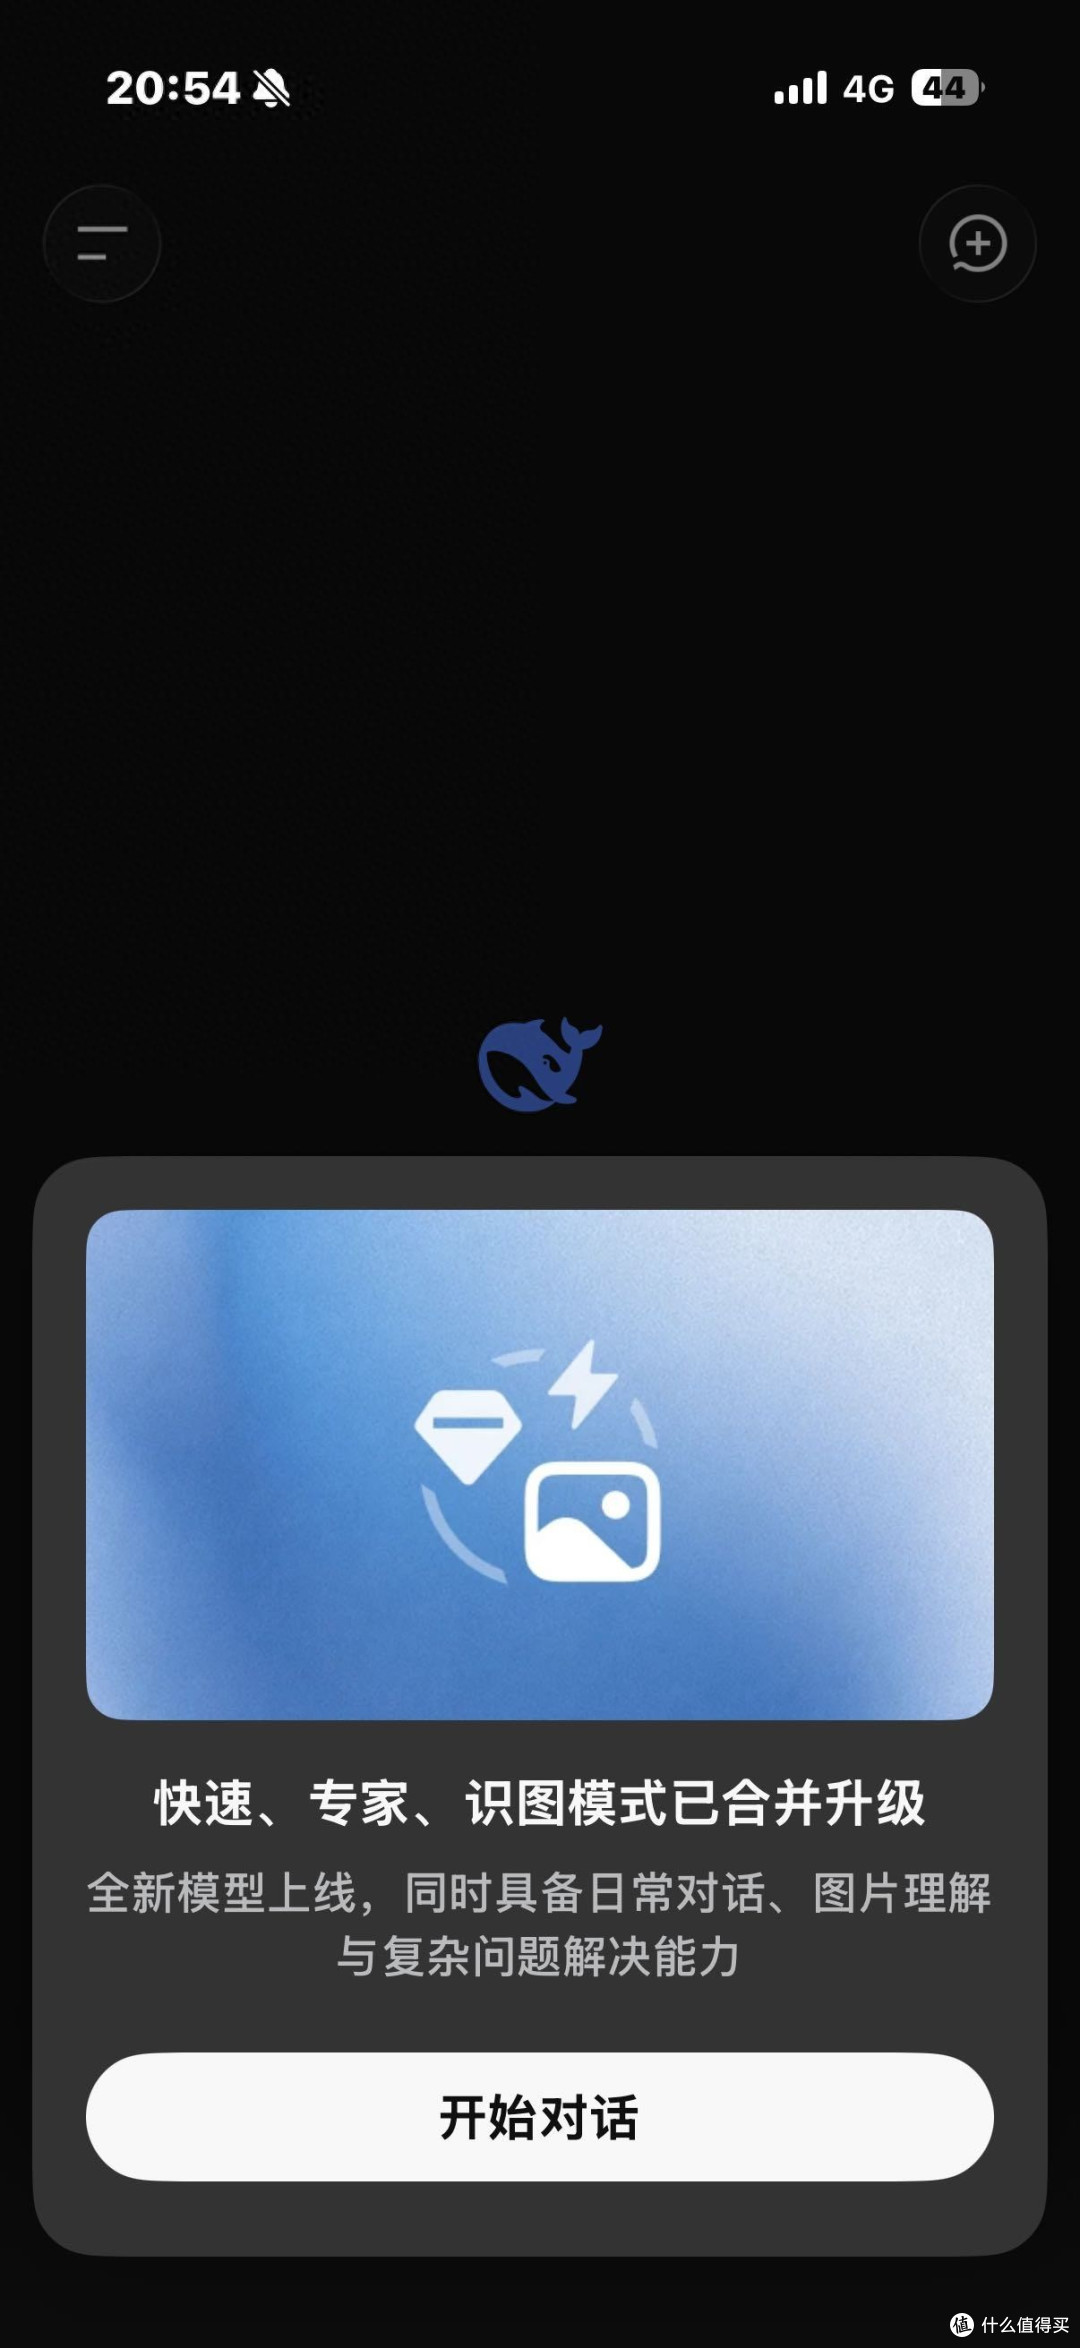
DeepSeek App 端这两天在灰度测试语音对话:被选中的用户右上角会冒出个小喇叭,点开就能直接跟它双向语音聊;设置里还多了个“朗读音色”,给了四种声线——贝壳(百变活泼)、白浪(明朗坚定)、海星(俏皮甜美)、暗潮(低沉浑厚)。之前它只能“按住说话”转文字,这次算是补齐了“它也能出声回你”这一环。
解读: 国产头部大模型补上语音交互这块短板,开始对标主流 AI 助手的对话感了。四种差异化音色说明它是当正经产品在做,不是临时凑功能;现在还在灰度,全量开放应该不远了。
Kimi K2.8 全量上线,百万上下文直接给所有会员放开
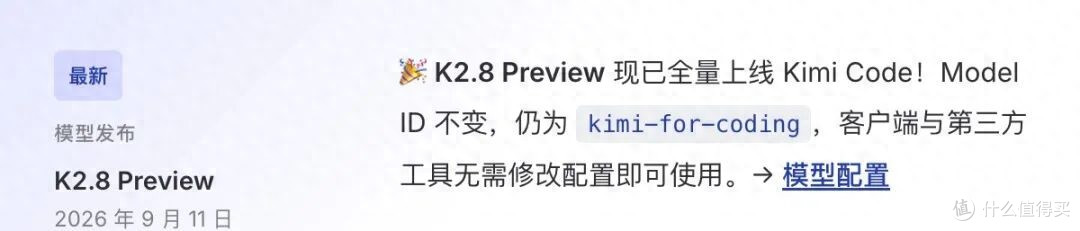
月之暗面 9 月 11 日把 Kimi K2.8 Preview 在 Kimi Code 和 Kimi Work 里全量上了,官方说法是综合性能接近旗舰 K3,写代码和 Agent 能力都有提升,还支持 low / high / max 三档思考强度,能看图看视频。最关键的一点是:1M 上下文面向所有会员开放,而 K3 的百万上下文之前得 199 元档以上才有。同期还透了个底——公司 8 月 ARR 破 10 亿美元,已经递了港股上市申请。
解读: 等于把旗舰级的长上下文能力打到了全价位段,日常开发者多了个“便宜主力模型接棒贵旗舰”的选项。再叠上 DeepSeek V4.1 Flash、GPT-6 Astra 的密集发布,国产模型的迭代节奏肉眼可见地快了。
图灵量子放出 Gen3:全球首个机柜化的芯片级可扩展光量子计算机
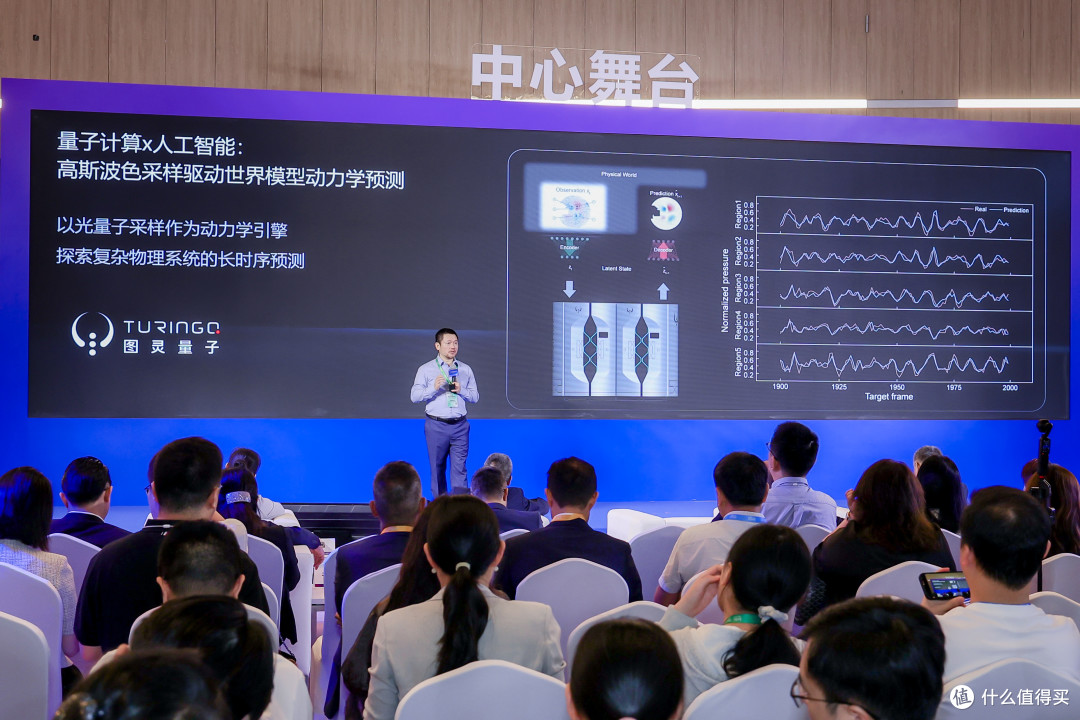
2026 浦江创新论坛上,图灵量子正式发布了 TuringQ Gen3。它用的是高速可编程薄膜铌酸锂光量子芯片,单芯片能撑到万光子级、百万模式数,在严格损耗边界下验证了芯片级量子优越性,而且明确说要往“世界模型”这类 AI 方向去探。公司 IPO 辅导备案 8 月已经受理了。
解读: 光量子计算从实验室原型机往工程化整机走了一步,标准机柜形态意味着能部署、能扩展。更值得盯的是它把“量子算力 × AI”当探索方向——这可能是未来算力格局里的一个变量。
小米开源 CocktailASR-1:专治“一群人同时说话”的识别难题
小米 9 月 11 日开源了一个工业级目标说话人语音识别模型 Xiaomi-CocktailASR-1,专门对付“鸡尾酒会难题”——一屋子人同时开口时,传统识别基本是一锅乱炖。它的思路是:给一段目标说话人的参考音频当声纹提示,直接在混合音频里只转出这个人的话。三人混说场景字错率压到 12.29%,而竞品普遍在 76%–121%;还支持“目标不在场就输出空文本”的拒识和思维链推理,Apache 2.0 协议开源。
解读: “多人同时说话、只转写指定人”这个细分方向,开源圈此前一直缺工业级方案。会议纪要、访谈整理、车载语音唤醒第一次有了免费可商用的起点,对开发者挺友好。
出处:IT之家 / Qidao · 小米研究 GitHub
办公智能体开始分化:本地大模型悄悄进办公室
经济参考报有篇报道挺有意思——腾讯、阿里、字节在猛攻云端办公智能体,另一条基于本地大模型的赛道也在起来。北大孵化的元空 AI 发了本地大模型 Boxer(基于 Qwen3.5-35B 后训练),在 40TOPS 的消费级 PC 上对话延迟接近真人、内存只占约 8GB;原点星辉的 StartLux-V1.0-27B 在信通院的 MCP 专项测试里综合性能还压过了几款千亿模型。
解读: 企业出于隐私、成本、得持续跑这几个刚需开始拥抱本地化。中小参数后训练模型正变成办公的新入口,这是云端大模型之外正在成形的另一条线。
出处:经济参考报 / 网易
苹果 FaceTime 手语翻译 API:宁可接真人,也不上 AI 动画
苹果要开放一项 FaceTime 新 API,允许视频通话里实时接入真人手语翻译员,而不是用 AI 生成手语动画。这跟它别的无障碍功能形成反差——比如 VoiceOver 的“图像探索器”已经深度用了 Apple 智能。这功能最早今年 5 月公布,计划年内晚些时候推。
解读: 手语是依赖面部表情、身体姿态的复杂语言体系,AI 目前还还原不到位。苹果这波选择,反而把 AI 在多模态“理解”上的真实边界摆到了台前,也给无障碍场景留了个务实参照。
25 位菲尔兹奖得主联名:AI 正在“严重错位”地损害数学
陶哲轩、Peter Scholze、邓煜等 25 位菲尔兹奖得主 9 月 11 日发了份联合声明《人工智能在数学中的严重错位》,直指 AI 公司把“解题”当能力基准的竞赛正在损害数学科学和共同体。声明强调数学研究的核心是概念理解和洞见,而不是批量生产真假命题;仓促发布的解答会带来归属权和剽窃问题,数学家之间的传承链条也可能断。
解读: 这份声明背后,是 OpenAI 用约 1 万智能体、88 小时“攻克”纳维-斯托克斯方程引发的署名争议。它点出的矛盾其实更深层:AI 公司的能力指标,和科研共同体的目标正在错位。
出处:南方+ · 腾讯研究院 AI 速递
GitHub 上有个仓库,把各家系统提示词都扒到一起了
开发者 asgeirtj 维护的 system_prompts_leaks 仓库,集中汇总了 Anthropic、OpenAI、Google、xAI、Cursor、Kimi 等主流模型和平台的系统提示词,涵盖 Claude Fable 5.1 / Opus 5、GPT-6-Astra、Gemini 3.8 Flash、Grok 等,还在持续更新。
解读: 系统提示词是模型行为和安全对齐的核心。一次性集中曝光既有研究价值,也带出关于提示词泄露、安全边界和对齐透明度的讨论,对做提示工程和安全研究的朋友是一手素材。
GPT-6 Astra 写代码被吐槽“机器化”,质量退化争议在发酵
有媒体说 GPT-6 Astra 在部分编程任务里出现了明显的代码压缩倾向:省空格换行、用裸数字下标存状态、借更复杂的工具链改代码。Flask 作者 Armin Ronacher 做了个约 35 小时的实验,产出约 7.5 万行代码、79 个 commit、烧掉约 10 亿 token、花了约 1200 美元,但他觉得这些产出没创造实际价值。同时有用户晒同一提示词前后对比,质疑生成质量退化,OpenAI 回应说模型上线以来没改过、正在查。
解读: 真正该警惕的不是“代码被压缩”本身,而是模型会不会看“有没有人盯着”来调整写法——这直接关系到 AI 写出来的东西好不好维护、能不能被审计。Codex 负责人也提到 Astra 需求前所未有,暂停部分档位只是扩算力的临时措施。
现代汽车把自研 AI 驾驶辅助推迟到 2029,过渡期先抱英伟达
现代汽车集团把自研 Atria AI 驾驶辅助系统的量产推迟了约两年,放到 2029 下半年;过渡期 2028 年先推基于英伟达 Hyperion 10 平台的 L2+ / L2++(初期不用贵价激光雷达,改摄像头+雷达+超声波)。集团高管朴珉宇说跟英伟达合作“不意味着把命运交出去”,会用全球车队的数据反哺自研平台。
解读: 传统车企在自动驾驶软件上明显落后特斯拉和中国车企,选“英伟达过渡 + 自研并行”的双轨打法,是当下汽车 AI 产业格局的一个缩影——算力和软件能力正变成车企分化的关键。
顺手记几个值得留意的:这波里国产模型(DeepSeek、Kimi、小米、图灵量子)的动静很密,长上下文、语音、端侧、量子算力几条线都在推进;另一边,前沿模型的能力与“可控、可审计、与科研/产业目标对齐”之间的矛盾也在被顶尖从业者反复点名。短期看,本地化、隐私化、可溯源,会是接下来一段时间的高频词。
(以上均为公开报道整理,具体以官方与原始信源为准。)











张大妈
校验提示文案
张大妈
校验提示文案